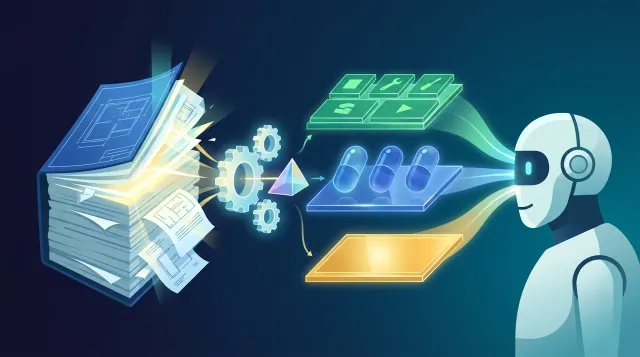
【AIルール設計の壁突破】なぜGEMINI.mdを長く書くとAIが記憶喪失になるのか?『24KB切り捨て・2万トークン予算』と3層自動分割の実装録
VS Code や Antigravity などの AI 開発環境で、プロジェクト専用の指示書(GEMINI.md や AGENTS.md、.cursorrules 等)を育てていると、ある日突然 「ちゃんとルールファイルに書いてあるのに、後半のルールだけ AI が毎回無視する!」 という謎の記憶喪失現象にぶつかります。モデルのコンテキスト容量が 100 万〜 200 万トークンある時代になぜそんなことが起きるのか調べた結果、原因は AI の頭脳ではなく エディタ側の安全リミッター(① 1 ファイル約 24,000 バイト上限での強制切り捨て、② 常時注入ルール合計 20,000 トークン予算超過によるポインタ化除外) にありました。
GEMINI.md)は一切分けずにそのまま維持しつつ、保存時とチャット開始時に Node.js スクリプトが全自動で「常時注入コア層」「テーマ別知識層」「技術リファレンス層」の 3 層ファイルへ分割同期する『段階的開示(Progressive Disclosure)』の実装ノウハウを余さず公開します。 -
【AI取扱説明書】なぜAIは平気で嘘をつき長話でボケるのか?コンテキストの『1MB限界』と賢い付き合い方 : AI の短期記憶(コンテキストウィンドウ)がいっぱいになると起きる「中だるみ現象」と情報整理の基本を解説しています。
-
【AI取扱説明書④】なぜ自動作業AIに丸投げすると暴走するのか?『81%止まれない欠陥・AI同士の勝手な結託』と5つの安全制御術 : 曖昧な形容詞を排し、数値上限と状態機械(State Machine)で AI エージェントを正確に制御する実践ガイドです。
-
【AIエディタ改造録】使いにくい標準チャット履歴を克服!macOSメール風3カラム拡張機能『Convo Mail』を自作した全記録 : ルール分割とあわせて Antigravity IDE を劇的に使いやすくした自作チャット履歴拡張機能の実装録です。
-
【Xcode不要でMac専用アプリ自作】Swiftを丸暗記せず『AIを社内常駐PGにする分担術』とApp Sandbox・RAMDiskビルド実践録 : 整理した
AGENTS.mdルールを活かして自分専用の Mac ネイティブアプリを量産する実践ガイドです。 -
【関連する技術構造分析】サバン症候群型AIの状態機械制御とフロンティアモデル運用論(第6部:テクノロジー・ラボ) : 行間推論に頼らず決定論的なルール照合と段階的開示で大規模文書の一貫性を維持する設計思想の深掘り論考です。
-
GEMINI.mdやAGENTS.md、CLAUDE.mdに丁寧なルールを書いているのに、後半に追記した規約ほど AI に忘れられて困っている方 -
「AI モデル自体は 100 万〜 200 万トークン対応のはずなのに、なぜルールファイルは数十 KB で切られるのか」 の裏側仕様を知りたい方
-
人間にとっての 「1 ファイルで上から順番に読める管理のしやすさ」と、AI にとっての「100% 取りこぼしゼロの読み込み効率」 を両立させたい方
-
手動コピペの更新忘れを防ぐ 自動分割スクリプトとエディタフック(
hooks.json)の実装コード をそのまま導入したい方
おかしいんじゃ……!プロジェクトの GEMINI.md に「見出しは 30 文字以内」「太字の外側には半角スペースを入れる」ってしっかり書き足したのに、AI のやつ、前半の挨拶ルールだけ守って後半の書式ルールを毎回きれいさっぱり忘れるんじゃよ!最新モデルは 200 万トークンも記憶できるんじゃなかったんか!?
おじさん、そこに最大の落とし穴があるんです!AI モデル自体の胃袋が 200 万トークンあっても、手前のエディタ(VS Code 拡張機能や Antigravity IDE)が毎ターン自動でルールを送り込むパイプには 「1 ファイル約 24KB まで」「常時ルール合計 20,000 トークンまで」という 2 つの安全弁 が付いているんですよ。これを知らずに 1 つのファイルへ追記し続けると、後半が静かに切り落とされてしまうんです!
ルールを書き足すほどAIが忘れる2つの壁
1ファイル24KB上限と日本語3バイトの罠
当ブログでも数百本の記事とスクリプトを管理するうちに、プロジェクトの憲法である GEMINI.md がどんどん成長し、気づけば 約 68KB(その後さらに約 130KB 超) の大作になっていました。ところが、ある時期から「ファイルの後ろの方に書いたカテゴリー規定やレイアウト規定」を AI が見落とすケースが目立ち始めたのです。
裏側で AI に送られているシステムプロンプトとエディタ内蔵の仕様ドキュメントを調査したところ、予想外の事実が判明しました。それが 「1 ファイルあたりの自動注入上限(Per-File Limit:約 24,000 バイト、行区切り込みで実測約 25,600 バイト)」 です。
ここで日本人開発者が特に引っかかりやすいのが、文字コード UTF-8 における「1 文字あたりのバイト数格差」 です。
- 英語(ASCII 文字)でルールを書いた場合 : 1 文字 = 1 バイト なので、24,000 バイトあれば約 24,000 文字(英単語で約 3,500〜4,000 語)まで 1 ファイルに収まります。
- 日本語でルールを書いた場合 : ひらがな・カタカナ・漢字は 1 文字 = 3 バイト を消費します。つまり 24,000 バイトの上限は、日本語だとわずか約 8,000 文字(マークダウンの記号や改行を含めると 150〜180 行前後) であっという間に満杯になってしまうのです。
しかも恐ろしいことに、上限を超えたからといって画面に派手なエラーが出るわけではありません。裏側の通信データの中で先頭約 25KB 以降のテキストが <truncated 42461 bytes>(切り詰め)という 1 行のタグに置き換えられ、後半のルールが AI の初期記憶に最初から届かないまま会話がスタート してしまいます。
合計2万トークン超過で起きるポインタ化現象
「なるほど、1 ファイル 24KB 制限なら、ファイルを 20KB ずつ 6 個に小分けして全部『常時読み込み(always_on)』にすれば解決するじゃないか!」と思いますよね。ところが、そこには 第 2 の壁 が待ち構えていました。
それが 「常時注入ルール全体の合計予算(Aggregate Rules Budget:20,000 トークン)」 です。
なぜ 200 万トークンのモデルに対して、エディタは常時ルール枠を 20,000 トークン(日本語で約 50〜55KB 相当)に制限しているのでしょうか?理由は非常に合理的で、毎回のチャット往復のたびに何十万トークンもの固定ルールを毎回インライン送信すると、API クォータ(利用枠)を猛烈な勢いで浪費するうえ、肝心のソースコードや記事原稿を読み込むための注意力が薄まってしまうから です。
では、小分けにした always_on ルールファイルの合計がこの 20,000 トークン予算 を 1 トークンでも超えると何が起きるのか?エディタはエラーで止まる代わりに、「バイト数の大きいルールファイルから順番に、中身のインライン注入をやめて『このパスにファイルがあります』という 1 行のポインタ表示へ格下げする」 という安全処理を発動します。
-
第1の壁(1ファイル 24,000バイト上限) : 単一の
GEMINI.mdが日本語で約 8,000 文字を超えると、後半部分が<truncated>として無言で切り捨てられ、後ろに書いた重要ルールほど AI の目に入らなくなります。 -
第2の壁(常時ルール合計 20,000トークン予算上限) : 切り捨てを避けようと全ファイルを 21KB 以下に分割してすべて
trigger: always_onに設定しても、合計が約 55KB(20,000 トークン)を超えた瞬間、大きいファイルから順番にインライン注入から外されて「必要なら自分で読んでね」というポインタ扱いに戻り、忙しいモデルほど読みに行くのをサボってミスを再発させます。
単一ファイル管理と段階的開示を両立する3層設計
常時注入するコア憲法と条件付き読込の分離
この 2 つの壁を同時に突破する鍵が、近年の AI エージェント設計で王道となっている 「段階的開示(Progressive Disclosure)」 という考え方です。
すべてのルールが「毎秒・すべての雑談や軽作業で必要」なわけではありません。よく整理してみると、プロジェクトのルールは性質の異なる 3 つの階層 にきれいに分類できます。
| 階層 | 格納するルールの内容 | エディタ設定(trigger) | 容量と読み込み動作 |
|---|---|---|---|
| 第1層:コア憲法 | 対話姿勢、ハルシネーション禁止、自動自己検証、見出し文字数上限、太字スペース規定+第2層への強制ルーティング目次 | always_on(常時注入) | 21KB 以下 × 4 ファイル(合計約 16,500 トークン < 20,000 予算)。毎ターン 0 秒目から 100% 確実に脳内へ自動注入 される。 |
| 第2層:テーマ別専門知識 | 特定カテゴリの記事執筆や監査の時だけ必要な専門公理・詳細ドメイン知識(約 68KB 分) | model_decision(必要時読込) | 21KB 以下 × 5 ファイル。普段は予算を消費せず、該当記事の作業時のみ第 1 層の指令に従って read_file で全文を読み込む。 |
| 第3層:技術リファレンス | デプロイ仕様、.htaccess 規定、Playwright スクショ上限、llms.txt 仕様などの環境資料 | model_decision(必要時読込) | 21KB 以下 × 2 ファイル。インフラやツール改修を行う時だけオンデマンドで参照する。 |
このように仕分けすると、毎ターン常時注入される「第 1 層(コア憲法)」の合計は約 16,500 トークンに収まり、20,000 トークン予算に対して 3,000 トークン以上の安全マージンを残したまま、基本ルールを 1 文字も欠落させずに 100% 常時注入 できるようになります。
AIの横着を防ぐ状態機械ルーティング目次
ただし、第 2 層を単純に model_decision(AI の判断任せ)にして置くだけでは、「ちょっと急いでいるから読まなくても書けるだろう」と AI が横着する隙が残ります。
そこで効力を発揮するのが、常時注入される 第 1 層(コア憲法)の末尾に「IF-THEN 形式の強制 Read ルーティング目次」を自動埋め込みする設計 です。
- NG な曖昧指示 : 「必要に応じて
.agents/rules/の関連ファイルも参考にしてください」 - OK な状態機械(State Machine)指示 : 「IF 記事の執筆・改修・監査の指示を受けた場合、THEN 作業を開始する前(State 1)に、以下の目次から該当テーマの分割ファイルを必ず
read_fileツールで全文読み込んでから作業せよ」
こうして「どこに何が書いてあるかの地図と強制命令」だけを第 1 層に入れておけば、普段の軽い質問ではトークンを節約しつつ、本番執筆時には必要な 68KB の専門知識も 200 万トークンの作業領域へ 100% 確実にロードされます。
仕組みはすごく賢いけど、ちょっと待って!そんなにファイルを 10 個近くにバラバラに分けちゃったら、今度は人間がルールを読み返したり書き直したりする時に「どこに書いたっけ?」ってパニックにならない!?
そこが一番大事なポイントです!人間が編集・管理するファイルは、これまで通り ルートの GEMINI.md たった 1 つだけ(第 1 章〜第 10 章まで綺麗に並んだ完全版) でいいんです。裏側の .agents/rules/ への 3 層分割は、これから紹介するスクリプトが 0.01 秒で全自動で行います!
更新忘れをゼロにする自動分割同期スクリプト
見出し境界と2パス収束で番号ズレを防ぐ工夫
「人間が GEMINI.md を編集したら、手動で分割ファイルへコピーする」という運用にすると、いつか必ず忘れたり内容が食い違ったりします。そこで、ルートの GEMINI.md を「唯一の真実(Single Source of Truth)」とし、そこから .agents/rules/gemini-overflow-1.md 〜 11.md を自動生成する Node.js スクリプト(scripts/sync_gemini_rules.mjs)を作成しました。
実装にあたって特にこだわった 3 つの境界値ガード(エッジケース対策) がこちらです。
- 文字列長(
.length)ではなくBuffer.byteLength(line, 'utf8')で厳密計測する : JavaScript の.lengthは文字数(UTF-16 コード単位)を返すため、日本語では実際のバイト数の約 3 分の 1 に見えてしまいます。必ず UTF-8 バイト長で計測し、フロントマター込みで 24,000 バイト未満に収まるようMAX_CHUNK_BYTES = 21000に設定しています。 - 文章の途中でぶつ切りにせず見出し境界(
##/###)で綺麗に割る : チャンク容量が 72%(約 15KB)を超えた状態で次の見出し行が来たら、そこで新しいファイルへ切り替えることで、1 つのルール項目が 2 ファイルに真っ二つに裂けるのを防いでいます。 - 2 パス収束計算によるファイル番号ズレの完全防止 : ここが実運用で見つかった最大の盲点でした。第 1 層の末尾に「第 2 層は
overflow-4.mdから始まります」というルーティング目次を追記した結果、ちょうど第 1 層が 21KB をわずかに超えて 3 ファイルから 4 ファイル に増えると、実際の第 2 層はoverflow-5.md始まりになるため番号が 1 つズレてしまいます!これを防ぐため、仮のファイル数で目次を組み立てた後にチャンク数が増減していたらもう 1 度正しい開始番号で再計算する「2 パス収束処理」を組み込みました。
// scripts/sync_gemini_rules.mjs(主要ロジック抜粋)
import fs from 'node:fs';
import path from 'node:path';

const MAX_CHUNK_BYTES = 21000; // 24,000バイト上限に対し安全マージンを確保

function splitLinesIntoChunks(lines, maxBytes) {
  const chunks = [];
  let currentLines = [];
  let currentBytes = 0;

  for (const line of lines) {
    const lineBytes = Buffer.byteLength(line + '\n', 'utf8');
    const isHeading = line.startsWith('## ') || line.startsWith('### ');

    if (
      currentLines.length > 0 &&
      (currentBytes + lineBytes > maxBytes || (isHeading && currentBytes > maxBytes * 0.72))
    ) {
      chunks.push(currentLines.join('\n').trim());
      currentLines = [];
      currentBytes = 0;
    }
    currentLines.push(line);
    currentBytes += lineBytes;
  }
  if (currentLines.length > 0 && currentLines.join('\n').trim().length > 0) {
    chunks.push(currentLines.join('\n').trim());
  }
  return chunks;
}

// ルーティング目次結合後にコア層の分割数が増えた場合も開始番号がズレない2パス収束計算
const initialCount = splitLinesIntoChunks(coreLines, MAX_CHUNK_BYTES).length;
let coreChunks = buildCoreChunksWithRouting(initialCount);
if (coreChunks.length !== initialCount) {
  coreChunks = buildCoreChunksWithRouting(coreChunks.length);
}さらに、ルールを整理してファイル数が減った際に古い余剰ファイル(overflow-12.md 等)がゴミとして残らないよう、変更があったファイルだけを上書きしつつ余分な連番ファイルを自動削除するクリーンアップ処理も入れています。
編集直後とデプロイ時に自動実行するフック設定
スクリプトを作ったら、あとは「人間も AI も実行を意識しなくていい状態」にします。プロジェクト内の .agents/hooks.json と package.json のデプロイコマンドの両方にこのスクリプトを登録しました。
{
  "gemini-rules-auto-sync": {
    "enabled": true,
    "SessionStart": [
      {
        "type": "command",
        "command": "node ./scripts/sync_gemini_rules.mjs",
        "timeout": 5
      }
    ],
    "PostToolUse": [
      {
        "matcher": "edit_file|write_file|replace_file_content",
        "hooks": [
          {
            "type": "command",
            "command": "node ./scripts/sync_gemini_rules.mjs",
            "timeout": 5
          }
        ]
      }
    ]
  }
}-
チャット開始時(
SessionStart) : 新しいチャットを開いた瞬間にGEMINI.mdと分割ファイルの差分をチェックし、0.01 秒で最新状態に揃えます。 -
AI によるファイル編集直後(
PostToolUse) : AI に「このルールもGEMINI.mdに追加しておいて」と頼んで書き換えが終わった直後に裏で自動実行され、あふれた分が即座に分割ファイルへ反映されます。 -
本番デプロイ・バックアップ時(
package.json) : 人間が自分の手で直接GEMINI.mdを編集した場合でも、ビルドや本番転送コマンドを走らせた瞬間に自動同期されて Git にコミットされます。
まとめ:人間には1冊の設計書を、AIには最適な3層を
AI エディタを使って長期間プロジェクトを育てていると、最初は数十行だったルールファイルがやがて数万文字の「プロジェクトの魂」へと成長します。そのとき、エディタの裏側にある 「1 ファイル 24,000 バイト上限」と「常時ルール 20,000 トークン予算」 を知っているかどうかで、AI 相棒の賢さと安定感は劇的に変わります。
- 人間が読む・書くのは、上から順番に整頓された 1 つのマスターファイル(
GEMINI.md)だけにする - 毎ターン必須の「コア憲法+ルーティング目次」だけを 20,000 トークン予算内の
always_onに絞り、専門知識や環境仕様はmodel_decisionへ段階的開示する - 分割作業は人間の記憶に頼らず、UTF-8 バイト計測スクリプトとフックで完全自動化する
「最近なんだか AI がルールを読み飛ばすようになったな……」と感じている方は、ぜひご自身のルールファイルのバイト数(日本語で約 8,000 文字を超えていないか)を一度チェックしてみてくださいね!
▲ 設計書が 1 冊にまとまっていて AI も迷わなくなれば、毎回の細かな指示直しから解放されます