【AI取扱説明書⑦】掛け算を捨てた『1.58ビットAI(BitNet)』の衝撃!3つの壁とIntel最終世代iMacでのローカルAI比較
AI の軽量化は 32 ビット → 16 ビット → 8 ビットと進んできましたが、そこに Microsoft Research などが投下した爆弾が、浮動小数点を完全に捨てて重みを 「-1・0・+1」のたった 3 通りの整数 だけにしてしまう 「1.58 ビット AI(BitNet b1.58)」 です。重みがこの 3 択になると、AI 計算の 9 割を占めていた重たい 「掛け算」がこの世から消滅し、単純な「足し算と引き算」だけ で超高速・超省エネに動くようになります。
ただし、現在のパソコンや GPU は「8 ビット単位のメモリ」と「小数の掛け算」を前提に作られているため、「荷ほどきの手間」「最新 GPU の掛け算回路が遊んでしまう皮肉」「後から 1.58 ビットに変換できない壁」 というリアルな課題もあります。本記事では、たった 3 択で知能が壊れないカラクリからハードウェアとの相性、そして手元の Intel 最終世代 iMac(Core i5 / メモリ 64GB)で動かす場合に「爆速の英語系地球知能(BitNet 1.58bit)」と「実用的な日本特化モデル(llama.cpp 4bit)」がどう違うのかまで、徹底比較して解き明かします。
-
【AI取扱説明書⑥】なぜAIは速い整数ではなく浮動小数点を使う?65,536通りの16ビット(BF16)と256通りの8ビット(FP8)で壊れない秘密 : 前回記事です。従来の AI がなぜ浮動小数点と Tensor コア(掛け算回路)で進化してきたのかを知ると、今回の BitNet の凄さが 10 倍よく分かります。
-
【AI取扱説明書⑤】AIに人間の文字はどう見えている?『16進数・日英トークン格差・意味の座標』と次の1語を選ぶ確率の正体 : 英語中心に鍛えられた「地球知能モデル」がなぜ日本語のトークン処理で不利になりやすいのか、基礎から紐解いた解説編です。
-
【AI取扱説明書⑧】Ultra 20xからダウングレードして大丈夫?『週間残量68%の算数』と500記事を0.3秒で監査する節約術 : 次回記事です。「ローカル AI が動くなら有料のクラウド AI は解約できる?」という疑問に、実機クォータの算数で白黒つけます。
-
【大人の科学教養】なぜウイルス(ファージ)は『機械の形』なのか?太陽の核融合・ボイジャー1号の50年と三進数光コンピュータの未来 : BitNet の
-1, 0, +1演算と抜群の相性を持つ「平衡三進法×光コンピュータ」と量子コンピュータの物理的な違いまで広げた科学コラムです。 -
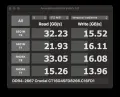
Intel最終世代iMac 2020を10年戦わせる完全武装!PRO-G40 SSD速度低下の罠とLuna Display・64GBメモリ最適化 : 今回の比較舞台である iMac 20,1(DDR4-2667 64GB・実測 Read 32.23GB/s・16GB RAM ディスク)の実機構築レビューです。
-
無圧縮の『日本特化型AI』と詐欺・工作を100%濾過する『二層式・AI浄水場』 : 英語圏ベースの汎用モデルとは別に、日本の言語・制度・知識に純化した小型モデルを設計する意義を論じた応用編です。
-
話題の 「1.58bit LLM(BitNet b1.58)」 がなぜ「1.58」という中途半端な数字なのか、なぜ
-1, 0, +1だけで賢い文章が作れるのか知りたい方 -
「掛け算がなくなるなら今の GPU でも 100 倍速くなるの?」 という疑問に対し、現在の CPU・GPU 構造とのリアルな相性を知りたい方
-
高価な NVIDIA 製グラボを積んでいない Mac(Intel iMac や Apple Silicon)の CPU と大容量メモリ で、ローカル AI がどこまで動くのか興味がある方
-
「地球知能(英語ベース汎用 AI)」と「日本特化モデル(日本語追加学習 4bit AI)」 の違いを知り、自分の用途に合ったローカル AI を選びたい方
前回は「256 通りの 8 ビット小数」でもたまげたのに、今度は「1.58 ビット」じゃと!? ビットちゅうのは 0 か 1 の整数じゃろがい! 小数点がついたビットなんて聞いたことがないぞい!
名前からしてインパクト抜群ですよね!でも中身を知ると、コンピュータの基本原理を逆手に取ったとんでもなく美しい発明なんです。まずはこの「1.58」の正体からタネ明かししますね!
重み3択で掛け算が消える1.58ビットの正体
なぜ1.58ビットという中途半端な数字なのか
コンピュータの最小単位である「1 ビット」は、0 か 1 かの 2 通り を表せます。「2 ビット」あれば 00, 01, 10, 11 の 4 通り を表せます。
では、BitNet b1.58 が使う 「-1、0、+1 の 3 通り(三値:Ternary)」 は、情報理論(2 進数の情報量)に換算すると何ビット分に相当するでしょうか?
そう、「3 通りの情報を表すのに必要な理論上のデータ量が約 1.58 ビットだから」というのが、この不思議な名前の由来です。
実際のメモリ(1 バイト= 8 ビット= 256 通りの箱)に保存するときも、たとえば 3 通りの重みを 5 個分まとめると 通り になるため、1 バイト(256 通り)の箱の中に 5 個の重みをギュッと荷詰め(パッキング)でき、1 個あたり実質 1.6 ビット前後(高速展開用の 2 ビット詰め形式でも 2 ビット)という極小サイズで格納できます。
掛け算が消滅し0のスイッチが知能を守る理由
重みを -1・0・+1 の 3 つだけに絞ると、半導体回路の上でとてつもない革命が起きます。AI の計算時間の 9 割以上を占めていた「掛け算」が丸ごと不要になり、「足し算と引き算だけ」に変わる のです。
AI の基本計算は「流れてきた信号 x × 重み w」の合計ですが、重み w が 3 択しかなければ、計算は次の 3 パターンしか存在しません。
- 重みが
+1のとき : 入力信号xをそのまま 「足す」 (+x) - 重みが
-1のとき : 入力信号xをそのまま 「引く」 (-x) - 重みが
0のとき : 「何もしない(無視してスキップする)」
CPU や GPU のチップ上では、「浮動小数点の掛け算器」は回路面積も消費電力も桁違いに食う大食い部品ですが、「整数の加算器(足し算・引き算)」は極めて小さくて省電力です。論文の試算では、演算そのものにかかるエネルギーが従来の 16 ビット浮動小数点に比べて数十分の 1 レベルまで激減します。
さらに、初期の「1 ビット AI(-1 と +1 の 2 択だけ)」が賢くなれなかった壁を突破した最大の功労者が、真ん中に追加された 「0」の存在 です。
学習中には absmean 量子化(層全体の重みの絶対値平均 で各重みを割り、-1, 0, +1 へ丸め込む方式)を使います。
-1 と +1 の 2 択しかなかった頃は、関係のないノイズ情報に対しても無理やり「賛成(+1)」か「反対(-1)」のどちらかの票を入れなければならず、思考が濁ってしまっていました。そこに「0(無関係な神経の繋がりを切るオフスイッチ=特徴選択)」が加わったことで、AI が必要な情報だけを通し不要なノイズを遮断できるようになり、一気に 16 ビットモデルに匹敵する知能へ到達したのです。
数千個の多数決と裏側のハイブリッド構造
ちょっと待ってよ! 1 本ずつの神経が「賛成(+1)」「反対(-1)」「棄権(0)」の 3 択しかなかったら、人間の言葉みたいな繊細なグラデーションなんて表現できないんじゃないの?
ここにも 「数の力(高次元アンサンブル)」 と 「裏側のハイブリッド設計」 という 2 つのタネ明かしがあります。
まず、1 つの人工ニューロンには前の層から 数千本(たとえば 4,096 本) もの入力線が繋がっています。1 本ずつは「賛成・反対・棄権」の 3 択でも、4,096 人の多数決を集計すれば、「賛成 2,500・反対 500・棄権 1,096 なら +2,000(強い肯定)」「賛成 1,200・反対 1,150・棄権 1,746 なら +50(ほんのわずかな肯定)」といった具合に、合計値には驚くほど滑らかなグラデーションが生まれます。人間の脳の神経細胞も「発火するか・しないか」の単純なパルス信号の束で深い思考を生み出しているのとそっくりです。
そしてもうひとつ、実は AI の中にある すべてのデータが 1.58 ビットになっているわけではありません。
| データの種類 | BitNet b1.58 での扱い | なぜそうしているのか |
|---|---|---|
| 重み(Weight) | 1.58 ビット(-1, 0, +1) | メモリ容量の大半を占める巨大な「知識フィルター」。ここだけを極限まで削る。 |
| 流れる信号(Activation) | 8 ビット整数(INT8) | ニューロン間を流れるデータそのものには -128 〜 +127(256 段階)の細かさを持たせている。 |
| 層ごとの倍率(Scale γ) | 16 ビット小数(FP16 / BF16) | 足し引きが終わった最後に、層全体のスケールを整える虫眼鏡(γ)を 1 回だけ掛ける。 |
| 学習時の原本(Master Weight) | 16〜 32 ビット小数 | 【最重要】 学習中に 0.0001 ずつ微調整する裏帳簿はやはり高精度の小数で保持し、計算の瞬間だけ -1, 0, +1 に変換して鍛える。 |
つまり、一番メモリを食う「重みの壁」だけを -1, 0, +1 に置き換え、そこを通り抜ける信号(8 ビット)と育成中の裏帳簿(小数)はしっかり守っているからこそ、知能が崩壊しないのです。
現行CPUと最新GPUが直面する3つの壁
CPUで最大6倍速くなり1000億規模も載る威力
では、この BitNet を私たちが普段使っているパソコンの CPU や Mac で動かすと、実際にどれくらい速くなるのでしょうか? Microsoft が公開している公式推論フレームワーク bitnet.cpp のベンチマークでは、従来の推論と比べて目覚ましい効果が実証されています。
| 実行環境(CPU アーキテクチャ) | 速度の向上率(従来比) | エネルギー消費の削減率 | 代表的なインパクト |
|---|---|---|---|
| x86 CPU(Intel Core / AMD Ryzen) | 約 2.37 倍 〜 6.17 倍 | 約 71.9% 〜 82.2% 削減 | 高価な専用グラボ無しの一般的なパソコンの CPU だけで、数十億パラメータの AI が軽快に動く。 |
| ARM CPU(Apple Silicon M シリーズ等) | 約 1.37 倍 〜 5.07 倍 | 約 55.4% 〜 70.0% 削減 | 1,000 億(100B)パラメータ の超巨大モデルが、大容量メモリの Mac 単体で秒間 5〜 7 トークン(人間が読む速さ)で動作する。 |
特に衝撃的なのが メモリ容量の激減 です。1,000 億パラメータの巨大 AI を従来の 16 ビット(FP16)で動かそうとするとメモリだけで 約 200GB 必要になり、普通のパソコンでは起動すらできません。しかし 1.58 ビットなら 約 20GB 前後 まで縮むため、メモリ 32GB や 64GB の Mac のメインメモリにすっぽり収まってしまうのです。
荷ほどき負荷と最新GPUミスマッチの壁
おおーっ、CPU で 2 倍〜 6 倍も速くなるんか! でもちょっと待てよ、重い掛け算が消えて足し算だけになったんなら、100 倍くらい速くなってもよさそうなもんじゃし、最新の NVIDIA 製 GPU で動かしたらもっと爆速になるんじゃないんか?
そこが現代のコンピュータ構造のすごく皮肉で面白いところなんです!実は今の CPU や最新 GPU には、1.58 ビットの本来の力を出し切れない 「3 つの物理的な壁」 があるんですよ。
① 「1 バイト= 8 ビット単位」の荷ほどきコスト :現在のあらゆる CPU・GPU のメモリは「8 ビット(1 バイト)」が最小の引き出しになっており、「1.58 ビット専用の引き出し」は存在しません。そのため bitnet.cpp では、8 ビットの箱に詰め込んだ重みを計算のたびにビット演算で 「荷ほどき(アンパッキング)」 するか、あらかじめ計算結果を入れた 「早見表(ルックアップテーブル:LUT)」 を SIMD 命令(Intel の AVX2 等)で高速に引く工夫をしています。掛け算が消えた代わりに、この「荷ほどきと表引き」に CPU パワーを食われているのが現状です。
② 最新 NVIDIA GPU の「掛け算エンジン」が遊んでしまう皮肉 :前回見た通り、現在 AI 覇権を握っている NVIDIA の GPU は、チップ面積の大部分を 「浮動小数点(FP16 / FP8)の掛け算を超並列でこなす Tensor コア」 に割いています。そこに「掛け算が一切ない BitNet」を持ち込むと、せっかくの高価で巨大な掛け算エンジンが宝の持ち腐れになり、細かいビットの並べ替えばかりをさせられるというミスマッチが起きます(※専用 GPU カーネルも開発されていますが、現行 GPU は小数の積和演算向けに特化しているため、1.58 ビットの真価を 100% 引き出す構造ではありません)。
③ メインメモリの通り道(メモリ帯域幅)の壁 :CPU の計算自体が極限まで軽くなると、今度は「メモリ(RAM)から CPU へデータを運ぶ道路の幅」で頭打ちになります。一般的な DDR4 / DDR5 メモリ(毎秒 30GB〜 90GB 程度)では CPU コアをたくさん動かしすぎるとデータ待ちの渋滞が起き、逆に CPU とメモリが広帯域で直結された Apple Silicon(Pro / Max / Ultra で毎秒 200GB〜 800GB)は相性抜群です(※ただし Apple Silicon 上で古い Intel 用バイナリを変換する「Rosetta 2」経由で動かすと、ビット操作命令の変換ロスで速度が激減するため、必ず ARM ネイティブビルドで動かす必要があります)。
既存モデルを後から1.58ビット化できない課題
そして実用面でのもうひとつの大きな壁が、「すでに公開されている優秀な 16 ビット AI モデルを、後から手軽に 1.58 ビットへ変換することはできない」 という点です。
従来の 4 ビット量子化(INT4) なら、完成済みの優秀な日本語 AI モデルを後からツールで 16 段階の整数に丸め込んでも(Post-Training Quantization)、高い知能を保ったまま動きます。しかし -1, 0, +1 の 3 択に後から無理やり丸めると、さすがに知識が壊滅してしまいます。
BitNet として動かすには、最初から数兆トークンものデータを読み込ませて「一から 1.58 ビット専用モデルとして育成(ネイティブ学習)」しなければならない ため、莫大な初期計算コストがかかります。そのため現時点で公開されているネイティブ 1.58 ビットモデルは、Microsoft 公式の BitNet-b1.58-2B-4T(20 億パラメータ)など一部のモデルに限られているのがリアルな現在地です。
Intel最終iMacでのBitNetと4ビット比較
Core i5と64GBメモリ環境での速度と容量試算
では、実際に手元の iMac 2020(iMac 20,1:第 10 世代 Intel Core i5 6 コア[AVX2 対応]/ DDR4-2667 メモリ 64GB[実測 Read 約 32.2GB/s]/ Radeon Pro 5300 VRAM 4GB / macOS Sequoia) でローカル AI を動かす場合、BitNet(1.58bit) と従来の 日本語 4bit 量子化モデル(llama.cpp) ではどれくらい違いが出るのでしょうか?
内蔵 GPU の VRAM は 4GB しかないため、実用サイズのモデルはすべて 64GB のメインメモリ + Core i5(CPU) で回すことになります。ハードウェアの実効メモリ帯域幅(約 30〜 35GB/s)と各エンジンの動作特性から算出した 推論(試算値) を含む比較表がこちらです。
| 比較項目 | ① BitNet(bitnet.cpp / 1.58bit)例: BitNet-b1.58-2B-4T(2B) | ② 日本語・軽量 4bit(llama.cpp / INT4)例: Llama-3.1-Swallow-8B / Gemma(9B・12B) | ③ 日本語・中規模 4bit(llama.cpp / INT4)例: Gemma(27B クラス) |
|---|---|---|---|
| 重みの表現形式 | 1.58 ビット(-1, 0, +1 の 3 通り) | 4 ビット(16 通りの整数+ブロック倍率) | 4 ビット(16 通りの整数+ブロック倍率) |
| 必要なメモリ量(本体) | 約 0.4 〜 0.6 GB (16GB RAM ディスクにも余裕で常駐!) | 約 5.0 〜 7.5 GB (64GB メモリなら普段使いの裏で余裕) | 約 16 〜 18 GB (64GB 大容量メモリの真価が活きる領域) |
| 予想生成速度(推論) | 約 25 〜 45 トークン/秒(推論) (画面に文字が一瞬でザーッと流れる爆速) | 約 5 〜 9 トークン/秒(推論) (人間が声に出して読むくらいの落ち着いた速度) | 約 1.8 〜 3.5 トークン/秒(推論) (1 語ずつじっくり考えながら出る速度) |
| 日本語の自然さと知識 | △(片言・機械翻訳調) 英語の論理やコードは優秀だが日本語は不自然 | ◎(非常に自然) 敬語・要約・日本の制度や背景も的確 | ◎+(極めて自然・深い推敲) オフラインでの長文校正や壁打ちにも対応 |
※上記の生成速度は iMac 20,1 の実効メモリ帯域(約 32.2GB/s)および AVX2 命令での動作傾向に基づく 推論(予測値) です。また、ローカル LLM では中国企業製モデルも流通していますが、セキュリティポリシーおよび開発元の透明性の観点から除外し、米国(Microsoft / Google / Meta)および日本の公的研究機関(東京科学大学・産総研など)による透明性の高いモデルを基準に比較しています。
なぜここまで速度差が出るのか、先ほどの「メモリの通り道(約 32.2GB/s)」で割り算すると一発で納得できます。
AI は文字(1 トークン)を 1 つ出すたびに、メモリにあるモデルの重みデータを最初から最後まで 1 周読み込みます。8B の 4bit モデル(約 5.5GB)なら、32.2GB/s ÷ 5.5GB ≒ 秒間 約 5.8 回 が物理的な上限になるため、どんなに頑張っても秒間 5〜 9 トークン前後に落ち着きます。一方、約 0.5GB しかない BitNet(2B)なら CPU のキャッシュも効き、AVX2 の早見表命令(pshufb 等)と足し引きだけで回るため、同じ Core i5 なのに 秒間 25〜 45 トークン(推論) という別次元のスピードが飛び出すのです(※ 6 コアの Core i5 で動かす際は、メモリの順番待ち渋滞を防ぐためスレッド数を -t 4 または -t 6 に絞るのが最適解です)。
英語ベースの地球知能と日本特化4ビットの違い
ここで絶対に押さえておきたいのが、「AI の知能には『地球知能』と『ローカル(日本)特化知能』の 2 階建てがある」 という視点です。
Microsoft が公開した BitNet-b1.58-2B-4T は、わずか 0.4GB の器に 4 兆トークン(4T) もの知識を詰め込んだ驚異的なモデルですが、その中身は数学・物理・プログラミング・論理パズルといった世界共通ルールを英語で鍛えた 「地球知能(英語圏汎用知能)」 です。そのため、英語で質問したり Python コードを書かせたりすると 0.4GB とは信じられないほど賢い一方、日本の法律や文化はほとんど習っておらず、日本語で話しかけると昔の翻訳ソフトのような片言になってしまいます。
対照的に、llama.cpp で動かせる 4 ビット量子化モデル には、東京科学大学などが日本のウェブ・論文・知識を徹底的に追加学習させた Llama-3.1-Swallow-8B や、多言語の表現力が極めて高い Google の Gemma シリーズなど、「地球知能 + 日本の言葉・文化」を兼ね備えた実用モデルが揃っています。
まとめ:64GBメモリ環境での賢い使い分け術
Intel 最終世代 iMac のような大容量メモリ搭載マシンでローカル AI を楽しむなら、次の使い分けが現時点のベストアンサーです。
① 普段のオフライン日本語パートナーには「4bit 日本語モデル(8B〜 12B)」を使う :llama.cpp で Swallow や Gemma の 4bit 版(約 5〜 7GB)を動かせば、ネットを遮断した完全ローカル環境でも、人間が読むのにちょうどいいペースで自然な日本語の要約や壁打ちができます。
② 「BitNet(1.58bit)」は次世代アルゴリズムの爆速ベンチマーク&英語・コード実験機として触る :約 500MB のモデルを 16GB RAM ディスクや Thunderbolt 接続の高速外付け SSD(PRO-G40 等)に置けば、ロード時間はコンマ数秒、CPU だけで文字が滝のように流れる「掛け算ゼロの世界」を今すぐ体験できます(※ Hugging Face から入手する際は GPU 用の -bf16 ではなく bitnet.cpp 用の -gguf リポジトリを選びます)。
③ 「日本語ネイティブ BitNet」が登場する未来への最高の受け皿になる :将来、日本の研究機関から一から日本語で鍛えた 8B〜 27B クラスの 1.58bit モデルが登場し、さらに PC やスマホの NPU に「1.58 ビット専用の加減算回路」が標準搭載されれば、手元のマシンだけで超巨大 AI が爆速・無音で動く時代がやってきます。
ローカル AI や RAM ディスクを余裕で同居させるための iMac 27 インチ(2019 / 2020)用 64GB メモリ環境と、モデルデータの置き場として内蔵 SSD 並みの実測 3,000MB/s 超を叩き出す外付け SSD はこちらで紹介しています。
重みを -1 と 0 と +1 の 3 つだけにして掛け算をなくしちゃうなんて、AI 界の究極のダイエットでちぃね!猫様はダイエット反対派なので、ご飯の重みはいつでも +1 満タンでお願いするでちぃ🐾
さて、手元の iMac でもローカル AI が動くことが分かると、次に必ず浮かぶのが 「じゃあ、毎月高いお金を払っているクラウドの最上位プラン(Google AI Ultra 20x など)はダウングレードしても大丈夫なんじゃないの?」 というお財布に直結する疑問です。
完結編となる 第 8 弾(Ultra 20x からダウングレードして大丈夫?『週間残量 68% の算数』) では、AI にダウングレード相談をしたときに返ってくる「一般論アドバイスの罠」と、実際のクォータ画面 「週間残量 68% & Claude 枠 0%」の算数 が暴き出した衝撃の真実、そして 500 記事規模のサイトで最上位 AI の枠を節約しながら 0.3 秒で全件監査する実践パイプラインを公開します!
▲ 「地球知能」と「日本特化」、それぞれの得意分野を知るのが使いこなしの第一歩です