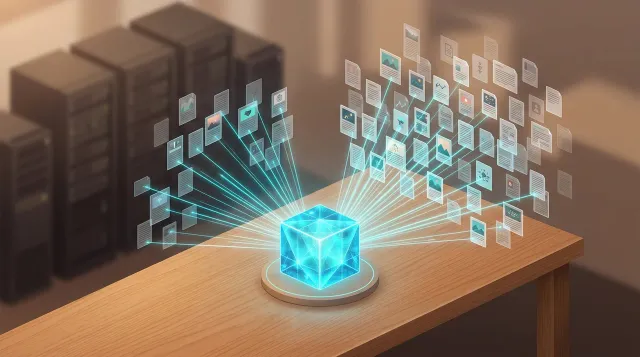
【サーバー不要の超高速DB】なぜ『SQLite』はMySQLより速いのか?500記事のAstroサイト×AI記憶探索をミリ秒化した実装録
「データベース」と聞くと、WordPress の裏側で動いている MySQL や業務システムの PostgreSQL のように、専用サーバーを 24 時間立ち上げて管理する重厚な仕組みを思い浮かべる方が多いはずです。ところが、私たちが毎日使っている iPhone や Android、Chrome ブラウザの内部で、実は世界で最も多く稼働しているデータベースは たった 1 つのファイルだけで動く『SQLite(エスキューライト)』 です。
しかも驚くべきことに、読み取り中心の用途においては、巨大なサーバー型データベースや OS で個別ファイルを直接開く処理よりも SQLite の方が圧倒的に高速 に動作します。本記事では、なぜサーバー不要の SQLite がこれほど速いのかという 3 つの構造的理由と明確な弱点を整理した上で、当ブログ(約 500 記事規模の Astro 静的サイト)が「本番サーバーの完全静的 HTML(セキュリティ無敵状態)」を一切崩さず、手元の Mac に Node.js 標準 SQLite インデックスを組み込んで AI の記事・過去チャット探索を数ミリ秒化した実践ノウハウをコード付きで公開します。
-
【Web安全設計の基本】なぜ古いPHPサイトやC言語ソフトは狙われるのか?『メモリの番地(ポインタ)手作業管理』の限界とRust・静的サイトが安全な理由 : 本番 Web サーバーからデータベースそのものを無くす「静的サイト(SSG)」が、なぜ SQL インジェクション攻撃に対して絶対的な安全性を持つのかを解説しています。
-
【AI取扱説明書⑧】Ultra 20xからダウングレードして大丈夫?『週間残量68%の算数』と500記事を0.3秒で監査する節約術 : AI に何百個ものファイルを直接読ませてトークン枠を浪費するのを防ぎ、ローカル処理で一瞬で監査を終える設計思想の姉妹編です。
-
【AIエディタ改造録】使いにくい標準チャット履歴を克服!macOSメール風3カラム拡張機能『Convo Mail』を自作した全記録 : 数百スレッド・数千往復の AI 対話ログを SQLite 全文検索でミリ秒呼び出しできるようにした専用ビューアの開発記録です。
-
『SQLite』 という名前は見かけるけれど、「簡易的なおもちゃのデータベースでしょ?」と思っていた方
-
なぜ 1 ファイルの SQLite が、専用サーバーで動く MySQL や個別のテキストファイル読み込みより速いのか、その仕組みを知りたい方
-
Astro などの静的サイト(MDX)で記事が数百本に増え、AI エージェント(Claude や Gemini 等)に関連記事を探させると遅くて枠ばかり減ると悩んでいる方
-
Node.js 標準の
node:sqliteで 日本語全文検索(FTS5)や WAL モード を使う際の「2 文字検索の罠」や安全な設定方法を知りたい方
ちょっと教えてくれ!SQLite っていうデータベースは、サーバーもいらずに .sqlite っていう 1 個のファイルだけで動くそうじゃな。手軽なのは分かるけど、本格的な MySQL とかと比べたらやっぱり遅いんじゃろ?
それがまったく逆なんです、おじさん!「何千人もが同時にデータを書き込む巨大 SNS」みたいな用途を除けば、実は データを検索して読み出すスピードは、専用サーバーを立てる MySQL より SQLite の方が速いケースが山ほどある んですよ。なぜそんな逆転現象が起きるのか、タネ明かししますね!
1ファイルで動くSQLiteがMySQLより速い理由
サーバー通信ゼロ!OSファイル開閉より35%速い
一般的なサーバー型データベース(MySQL や PostgreSQL)を使う場合、プログラムがデータを 1 件取り出すだけでも、「SQL 文をネットワークパケットに変換して送信 → データベースサーバー側で受信・解析 → 結果をまた通信で返却」という プロセス間・ネットワーク間の往復(いわゆる N+1 クエリで致命傷になる通信待ち時間) が毎回発生します。
これに対し、SQLite はサーバーではなく 「プログラム自身の部品(ライブラリ)」 として同じメモリ空間の中で直接動きます。通信の待ち時間が文字通り ゼロ(0 ミリ秒) であり、手元のメモリや SSD 上のデータを関数呼び出し 1 つで直接読み出せるため、何十回連続でクエリを投げても一瞬で終わります。
さらに SQLite 公式の有名な検証実験(『35% Faster Than The Filesystem』)では、数キロバイト〜数十キロバイトの細かいデータを「OS のフォルダに 1 個ずつのファイルとしてバラバラに保存して読み出す」よりも、「1 つの SQLite ファイルにまとめて読み出す方が約 35% 高速で、ディスク容量も約 20% 節約できる」 ことが実証されています。OS が何百回もファイルの「開く(open())・閉じる(close())」の権限確認を繰り返す手間を、SQLite がたった 1 回のファイルオープンで済ませてしまうからです。
読み書きを止めない『WALモード』とSSD相性
そして現代の SQLite を劇的に進化させた切り札が、次の 1 行で有効化できる 『WAL(Write-Ahead Logging:ログ先行書き込み)モード』 です。
PRAGMA journal_mode = WAL;昔の SQLite はデータを書き換えるたびに本体ファイルをロックしていましたが、WAL モードを有効にすると、新しい変更分はまず横にある専用ファイル(-wal)のお尻へ 順番に追記(シーケンシャルライト) されていきます。これにより、「裏でデータを更新している最中でも、読み取り処理が一切待たされずに並行して爆速で動き続ける」 ようになり、現代の高速な NVMe SSD とも抜群の相性を発揮します。
万能ではない!SQLiteが苦手な2つの弱点
もちろん、SQLite は魔法の杖ではありません。採用する前に知っておくべき明確な弱点が 2 つあります。
| 比較項目 | SQLite(組み込み・単一ファイル型) | MySQL / PostgreSQL(クライアント・サーバー型) |
|---|---|---|
| 導入・管理の手間 | 設定ゼロ・1 ファイルをコピーするだけでバックアップ完了 | サーバー構築、ユーザー権限管理、死活監視、定期パッチ当てが必要 |
| 読み取り・検索速度 | 通信往復ゼロのため小〜中規模では圧倒的に高速(数ミリ秒) | 1 回のクエリごとに TCP / ソケット通信のオーバーヘッドが発生 |
| 大量の同時書き込み | 苦手(書き込み自体は一度に 1 つずつ順番に処理される) | 得意(行単位のロック等で何百・何千人の同時書き込みを捌ける) |
| 複数サーバーからの共有 | 不向き(ネットワーク越しの共有フォルダ置きは破損の元) | 得意(Web サーバーを何十台に増やしても中央 DB へ接続可能) |
何千人も同時に書き込むシステムと複数台分散
SQLite が苦手なのは、X(旧 Twitter)や巨大 EC サイトの注文処理のように 「世界中の何千人ものユーザーが、同じ瞬間に一斉にデータを書き込み続けるシステム」 です。WAL モードでも「書き込みをする人」自体は一瞬ずつ順番待ちになるため、書き込みが殺到する巨大サービスや、複数台の Web サーバーから 1 つの DB を共有する構成では MySQL や PostgreSQL の出番になります。
個人開発やブログ管理では弱点が問題にならない
逆に言えば、「書き込むのは自分(またはバッチ処理)だけで、圧倒的多数はデータの検索・読み取り」 というスマホアプリ、デスクトップツール、個人〜中規模メディアの分析基盤においては、SQLite の弱点は 1 ミリも顔を出さず、「サーバー管理ゼロ・爆速・壊れない」というメリットだけを 100% 享受できるのです。
本番は静的のまま!500記事×AIのミリ秒検索術
なるほどなぁ!でもちょっと待てよ。このブログはせっかく WordPress(MySQL)をやめて、ハッカーに狙われない『Astro の静的 HTML サイト』にしたんじゃなかったか?そこに SQLite を入れたら、またデータベース攻撃の心配が増えたりしないのか?
おじさん、そこが一番大事な設計ポイントです!公開している本番サーバー(Xserver)には、SQLite なんて 1 ミリも置いていません! 本番は今まで通り 100% 純粋な HTML ファイルのままにしておき、手元の制作パソコン(Mac)の中だけに「AI 専用の超高速索引(インデックス)」として SQLite を持たせる んです!
全記事grepでAIのトークン枠が溶ける課題
Astro のような静的サイトジェネレーター(MDX 管理)は、記事が 50 本〜100 本のうちはテキストファイルのままでも快適です。しかし、当サイトのように公開記事が 約 500 本、さらに過去の AI 対話ログが 800 スレッド(数千万文字) を超えてくると、AI エージェント(Gemini 4 Argon や Claude)と一緒に記事を書くときに深刻な問題が起きます。
たとえば「この記事の数値を直したから、関連する他の記事も矛盾がないか探して」と頼むたびに、AI が 500 個の .mdx ファイルを毎回テキスト検索(grep)して何十ファイルも丸ごと読み込むと、時間ばかりかかる上に AI の週間トークン枠があっという間に溶けてしまう のです。
Node標準機能とmmapで0.03秒応答を実現
そこで当サイトが構築したのが、「テキスト原本(MDX)は一切変えず、Node.js v24 標準組み込みの node:sqlite(外部パッケージ追加ゼロ)でローカル知識 DB(knowledge.sqlite)を自動生成・差分同期する」 という 2 層分離アーキテクチャです。
-
本番 Web は完全静的(攻撃面ゼロ)を維持 : 記事のマスターデータはこれまで通り Git 管理の
.mdxファイルであり、Xserver へ転送するのはビルド後の静的 HTML と WebP 画像だけです(_local_db/は.gitignoreで外部非公開)。 -
記事カルテと内部リンク網の自動構造化 : ファイル更新時刻(
mtime)が変わった記事だけを差分解析し、タイトル・要約・<mark>で強調した核心主張・見出し別の本文・発着リンクのグラフを SQLite に格納します。変更がない時の差分確認はわずか 約 0.03 秒 で完了します。 -
OS メモリマップ(
mmap)によるシステムコール省略 : 読み取り接続時にページキャッシュ(32MB〜64MB)とPRAGMA mmap_size(128MB〜512MB)を割り当てることで、データベース全体が Mac のメモリ空間へ直接マッピングされ、500 記事+800 会話の横断検索が 数ミリ秒〜数十ミリ秒 で返ってきます。
日本語FTS5『2文字ヒットしない罠』と安全設定
最後に、これから Node.js(node:sqlite)で日本語の SQLite 全文検索を作る方がほぼ確実にハマる 「2 つの実務上の落とし穴」 と、その解決コードを共有しておきます。
trigramの3文字制限を補うハイブリッド検索
SQLite 標準の全文検索エンジン FTS5 で日本語を手軽に検索するには、文字を 3 文字ずつずらして索引を作る tokenize='trigram'(トライグラム) が非常に便利です。
しかしここには仕様上の罠があります。「3 文字ずつ切り出す」という構造上、『介護』『登山』『靴』『AI』『3%』のような「1〜2 文字の短いキーワード」を MATCH で検索すると、インデックスが機能せず検索結果が 0 件になってしまう のです!
これを防ぐには、検索語句の文字数を判定し、3 文字以上なら高速な FTS5 MATCH、1〜2 文字ならワイルドカードをエスケープした LIKE 検索へ自動で切り替えるハイブリッド関数 を組むのが正解です。
WAL併用時はimmutable禁止の鉄則コード
もう 1 つの罠が「読み取り専用で開くときの設定」です。ネット上の古い記事では URI パラメータの immutable=1(完全不変モード)を勧める例がありますが、裏で別プロセスが WAL 追記を行う環境で immutable=1 を使うと、最新の追記分が見えなかったりインデックス不整合エラー(SQLITE_CORRUPT 誤検知)を起こす危険 があります。
WAL 環境で安全に読み取り専用にするには、immutable=1 ではなく PRAGMA query_only = ON; を使いましょう。また node:sqlite はセキュリティと標準準拠のためダブルクォート文字列("...")を列名とみなす仕様(DQS=0)なので、SQL 内の文字列は必ずシングルクォート('...')で統一します。
import { DatabaseSync } from 'node:sqlite';

// 読み取り専用プロセスの安全な初期化例(Node.js v24+ 標準モジュール)
export function openReadDb(dbPath) {
  const db = new DatabaseSync(dbPath);
  // WAL環境では immutable=1 ではなく query_only = ON で誤書き込みを防ぐ
  db.exec(`
    PRAGMA query_only = ON;
    PRAGMA temp_store = MEMORY;
    PRAGMA cache_size = -32768;     -- 32MB ページキャッシュ
    PRAGMA mmap_size = 134217728;   -- 128MB OSメモリマップ
  `);
  return db;
}

// 日本語 1〜2 文字の取りこぼしをゼロにする FTS5 + LIKE ハイブリッド検索例
export function searchSections(db, rawKeyword) {
  const kw = String(rawKeyword ?? '').trim();
  if (!kw) return [];

  // サロゲートペアを考慮した文字数が 3 文字以上なら高速な FTS5 trigram MATCH
  if ([...kw].length >= 3) {
    const ftsPhrase = '"' + kw.replace(/"/g, '""') + '"';
    const stmt = db.prepare(`
      SELECT s.slug, s.heading
      FROM article_sections_fts f
      JOIN article_sections s ON s.id = f.rowid
      WHERE article_sections_fts MATCH ?
      ORDER BY bm25(article_sections_fts)
      LIMIT 20
    `);
    return stmt.all(ftsPhrase);
  }

  // 1〜2 文字語句(例: '登山', 'AI', '3%')は LIKE 特殊文字をエスケープして確実に拾う
  const escaped = kw.replace(/[\\%_]/g, '\\$&');
  const stmt = db.prepare(`
    SELECT slug, heading
    FROM article_sections
    WHERE heading LIKE ? ESCAPE '\\' OR body_text LIKE ? ESCAPE '\\'
    LIMIT 20
  `);
  const pattern = `%${escaped}%`;
  return stmt.all(pattern, pattern);
}
このように「空文字のトリム」「1〜2 文字境界の分岐」「% や _ 記号のエスケープ」「WAL と競合しない query_only = ON」を押さえておくだけで、外部ライブラリに一切頼らない堅牢で超高速な検索基盤が手に入ります。
まとめ:適材適所でSQLiteは最強の武器になる
今回のポイントを整理します。
- SQLite が速いのは「通信往復ゼロ」だから : アプリと同じメモリ空間で直接動き、細かいファイルを OS で何度も開閉するより約 35% 速く、
WAL モードによって読み書きの並行性も確保できます。 - 本番の静的サイト(Astro)とローカル SQLite は最高の相性 : 公開サーバーは DB レスの安全な静的 HTML のまま維持し、手元の制作環境にだけ SQLite インデックスを置くことで、セキュリティとミリ秒検索を両立できます。
FTS5 trigramの 1〜2 文字対策とquery_only = ONを忘れずに : 日本語の短い単語を取りこぼさないハイブリッド分岐を入れるだけで、数百記事・数千チャットの記憶を一瞬で引き出せる頼もしい知識庫になります。
「データベース=重たいサーバー管理が必要」という固定観念を外してみると、たった 1 個の .sqlite ファイルが日々の執筆や AI 活用のスピードを劇的に変えてくれますよ!
▲ おやつ袋の音を 0.01 秒で聞き分ける猫様の検索スピードを目指して、手元のデータベースも磨いています