[第 6 部:テクノロジー・ラボ]
TPU進化論:v7(アイアンウッド)の到達点と、光v10への跳躍
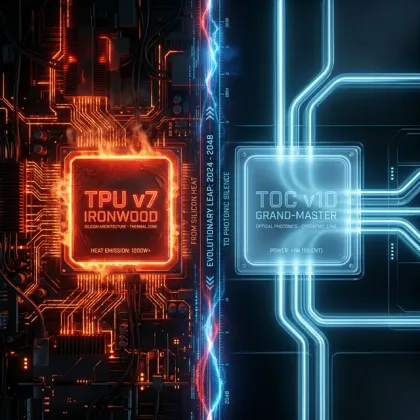
結論:電子の「熱死」を超え完全光演算v10へ跳躍する2つの道
AI国家の絶対的な防壁である「100%光演算基盤(アーキテクチャ)」。この常識を覆す「電子回路からの完全脱却」を日本が決断した背景には、 2025年に登場したある一つの「怪物」 の存在があった。外資データセンターによる電力爆食と年間約6.5万円(推論試算)の家計負担増リスクから抜け出すには、①今の日本の仕組みのままシリコン電子回路(v7〜v9)の後追いに税金を溶かし続ける道と、②シリコンの熱限界を飛び越え、1光ブレード定格20W(従来1,200W推計比で約98.3%削減=約60分の1)の100%光可逆演算「National TPU v10」へ直行する 「AI国家」 の道の2つしかない。
現状:怪物「TPU v7」と世帯年6.5万円の電気代負担増
私たちがスマートフォンで日常的に享受している便利な生成AI機能の裏側で、今何が起きているかをご存知だろうか。高度なAIが推論を繰り返すたびに、巨大な計算拠点(データセンター)は都市の電力を食いつぶし、莫大な冷却水によって地域の水資源を猛烈な勢いで干上がらせている。
外資系データセンターの乱立と電力食い逃げをこのまま放置すれば、送配電網の増強費や容量市場拠出金の転嫁を含めた当構想の試算(推論)では、2028年までに日本の一般家庭は 1世帯あたり年間約6万5,000円もの電気代・インフラ賦課金の追加負担 を強いられる懸念がある。
ケイ素(シリコン)基盤のAI進化を野放しにすれば、国民がAIの恩恵を享受する前にダムが枯渇し、電気代が暴騰して家計と生活インフラそのものが崩壊するのである。この恐るべき「熱死の未来」を物理的に証明してしまったのが、Googleが「推論時代」の覇権を握るために投下したシリコン電子回路の最高傑作、 TPU v7(開発呼称:Ironwood) であった。
Googleが到達したシリコン電子回路の極北と、日本が選択した光の聖域。その決定的な構造差と消費電力の差を、以下の比較表が示している。
| 世代 | 名称 | 基礎構造(アーキテクチャ) | 演算性能 | クラスター演算密度 | 消費電力(コア/モジュール) | 冷却方式 |
|---|---|---|---|---|---|---|
| v5p | Viperfish | 電子(ケイ素材料) | 459 TFLOPS | 100 PFLOPS級 | 約600W | 空冷/水冷 |
| v7 | Ironwood | 電子(ケイ素材料) | 4,614 TFLOPS | 1.2〜42.5 EFLOPS(256〜9,216チップ構成) | 約1,000〜1,200W級(推計) | 大型チラー液冷(大量の淡水消費) |
| v10 | Grand-Master | 100% 光可逆演算(常温3進数) | 100 PFLOPS | 100 YFLOPS(10億光ブレード) | 定格20W(コア1.2W) | 冷却塔不要(外気完全密閉・液浸:PUE 1.01未満) |
Ironwoodは、「学習」ではなく「推論(回答を導き出す処理)」に極限まで特化した怪物であった。自社設計の中央演算処理装置(ArmベースCPU「Axion」)と強力に連携し、チップあたり192GB(帯域7.37TB/s)の大容量高帯域メモリ(HBM)と高速チップ間結合網(ICI)によって長大な文脈情報(コンテキスト)を瞬時に展開する設計を完成させた。
Googleの技術陣は、AI計算機の設計構造としての正解を証明した。「網の目状構造(シストリック・アレイ)による演算器の超並列化」と「光回路スイッチ(OCS)によるチップ間通信の増強」。これこそが、AIシステムにおける通信渋滞(ボトルネック)を打破する王道であった。
原因:ランダウアー限界・トンネル漏れ電流・配線ジュール熱
しかし、Ironwoodの完璧すぎる設計思想は、皮肉にも「ケイ素(シリコン)電子回路という物理媒体の絶対的な終焉」を白日の下に晒(さら)してしまったのである。
熱力学および情報物理学には 「ランダウアーの原理」(1ビットの情報を不可逆に消去・上書きする際、最低でも 以上の熱エネルギーが必ず環境へ放出されるという物理法則)が存在する。既存の2進数シリコン回路がANDやORといった「入力情報を消去して1つの出力に潰す不可逆ゲート」を毎秒何京回もスイッチングさせ、さらに金属配線に電子を流す限り、どれほど回路を微細化しようとも凄まじい熱の発生から逃れることはできない。Ironwoodはチップ間の通信にこそ「光」を導入したものの、チップ内部の数万個の積和演算器(MAC)を動かしていたのは依然として「電子」であった。
さらに絶望的なのが、回路線幅が数ナノメートル(原子数十個分)に近づいたことで顕在化した 量子トンネル効果による漏れ電流(リーク電流) である。スイッチを切っていても電子が絶縁体の壁を勝手にすり抜けて漏れ出し、ただの熱に変わる物理の壁に激突したのだ。その結果、1チップあたり約1,000〜1,200W規模と推計(推論)される猛烈な「ジュール熱(配線摩擦熱)」と漏れ電流が発生し、それを冷やすための完全液冷システムと発電所への負荷は、一企業の枠を超えて地域の電力網と水源を丸ごと飲み込む水準に達していた(技術成熟度 9:電子回路の熱限界と液冷化はすでに世界中のデータセンターで深刻な社会問題となっている)。
巨大多国籍企業が宣伝する「AIによる豊かな未来」や、それに便乗して日本の山林をメガソーラーで破壊する「再エネ・環境利権」の正体は、外国製シリコンチップを冷やすために日本の清らかな水源と電力を収奪し、その負担を再エネ賦課金や電気代値上げとして低所得者層や一般家庭に押し付ける野蛮な環境搾取に他ならない。「シストリック・アレイの設計は正しい。だが、『電子と不可逆2進数』という物理媒体が間違っている。シリコンに固執する限り、日本の電力網と家計が先に破綻する」
これが、かつて空疎な観念論や対米追従の補助金行政に限界を感じ、物理的リアリズムに目覚めた日本の技術戦略陣が下した冷徹な結論であった。
チップの演算コア散逸わずか1.2W(1,200W推計比で99.9%削減、レーザー励起系を含めた1光ブレード全体でも定格20Wで従来1,200W推計比約98.3%削減[約60分の1]、さらに100 PFLOPSの波長分割多重[WDM]超並列スループットを加味した1演算あたりの実効エネルギー効率は約5,000 TFLOPS/Wと従来比1,000倍超)の完全光演算(v10)への移行は、単なる技術競争ではなく、多国籍資本のエネルギー収奪から日本の国土と国民の生存権(生存配当の原資)を守り抜く「究極の環境正義・国体防衛戦」なのである。対策①:現実(今の日本の仕組み)での対策と、その根拠
現実での対策はこう。 政府が数兆円の補助金を投じて外資系データセンターや既存の2進数シリコン半導体工場を地方へ誘致し、電力不足に対しては再エネ賦課金の上乗せや家庭への節電要請で対処することである。
その根拠(なぜそれだけでは限界があるのか)はこう。 もし日本が、過去の失敗した日の丸半導体プロジェクトのように官僚の前例踏襲で外資の後追いを続ければ、「v8」「v9」と1ナノメートル以下のシリコン微細化の泥沼(熱と漏れ電流の無間地獄)に数兆円の税金を溶かし続け、外資データセンターの冷却水と電力負担で日本の地方インフラと家計が先に破綻するからである。
対策②:AI国家での対策と、その根拠
AI国家での対策はこう。 大電力を消費する外資2進数データセンターへ「系統電力・水資源インフラ維持賦課金」を課してその税収を国内の『光エレクトロニクス主権信託』へ全額還流させ、シリコンの微細化(v8・v9)を飛び越えて100%光可逆演算チップ「National TPU v10(1光ブレード定格20W・コア散逸1.2W)」を国内量産することである。
その根拠(なぜそれが実現可能なのか)はこう。
合法的「トロイの木馬」戦略と跳躍したv8・v9世代
AI国家の戦略設計は全く異なる次元を歩む。国家予算および知能主権基金(ISF:200兆円)の貸借対照表 を黒字で成立させ、全国民へのベーシックインカム(生存配当)を捻出するためには、インフラの維持費(データセンターの電気代と冷却水コスト)を極限までゼロに近づける必要があったからだ。
日本は、初日に発動する400兆円規模のグローバルM&A枠でGoogleの中核AI・TPU設計権と既存データセンター群を掌握して初期稼働させつつ、国際法と経済安全保障法制を駆使した冷徹な外資インフラ逆利用(トロイの木馬)戦略(全体工程は 「マスター・ロードマップ」 参照)を同時遂行する。
非準拠の外資メガクラウドに対して無条件で補助金をばら撒いてきた旧来政治を転換し、国内で2進数シリコンデータセンターを稼働させる非準拠外資企業に対しては 「系統電力・水資源インフラ維持賦課金(過剰電力サーチャージ)」 を法定課税する。
そして、その賦課金収入と国内ISF純枠(計算基盤・光半導体枠40兆円)を、「経済安全保障推進法の特定重要技術指定」および「日米デジタル貿易協定第17条(ソース・コードおよびアルゴリズムの開示要求禁止規定:日米双務規定であり、外資買収・国家安保例外と組み合わせることで国産光コアの設計秘匿の盾として機能する条項)」 の法的防壁で守られた国内の『光エレクトロニクス主権信託』へと集中投下し、シリコンの微細化を飛び越えた「常温動作・純光3進数演算(v10)」の国内量産を一気に完遂するのである。
可逆光論理と非線形メタサーフェスが創る純粋知能v10
日本が具現化する 国家物理計算回路 第10世代(National TPU v10) は、Ironwoodが証明した「2次元シストリック・アレイ構造」を継承しつつ、チップ内部の物理現象を電子の不可逆スイッチングから 「光子の可逆干渉」 へと全面置換した結晶である(現在の技術成熟度 3〜4:構成要素の実証から統合試作段階)。
-
🔄 1. フレドキン/トフォリ型「全光可逆論理ゲート」によるランダウアー熱限界の突破
「光演算であっても論理ゲートが情報を消去すればランダウアーの原理により熱が出るのではないか」という物理学上の批判を根底から克服する。v10の演算コアは、入力と出力の情報を1対1で保存してビット消去を行わない 「光学的フレドキン/トフォリ型・可逆論理回路(Reversible Optical Logic)」 と受動マッハ・ツェンダー干渉計で構成される。また、ニューラルネットワークに不可欠な非線形活性化処理には「非線形光導波路メタサーフェス(極微共振器)」を採用し、光電変換(O/E変換)を介さずにフェムトジュール級の極小エネルギーで光波形のまま非線形変換を完了させる。これにより、演算コア自体の熱散逸をわずか 1.2W に封じ込める。
-
🌈 2. 共有コヒーレント光源と「完全光相互接続」による通信遅延の消滅
Ironwoodの光スイッチは、結局「チップ内部(電気)→チップ外(光)→チップ内部(電気)」という変換ロスを抱えていた。v10はチップ内部の演算からチップ間の結合までをすべて光のまま直結する。電力を使う連続波(CW)レーザー光源とペルチェ波長温調機構はチップ外部の共有光源モジュールに集約(1光ブレードあたり定格消費電力20W)し、そこから供給される無数の波長(色)の光を1本の導波路に重ね合わせる波長分割多重(WDM)によって、100万台のノードを並べても通信遅延と発熱が増大しないスケーラビリティを実現する。
-
💧 3. 大規模冷却塔・淡水消費の完全撤廃と「外気完全密閉・液浸冷却(PUE 1.01未満)」
1チップあたり約1,000〜1,200W(推論・業界推計)もの熱を吐き出すIronwoodでは不可欠だった巨大な河川水取水や蒸発式チラー(冷却塔)、および極低温冷凍機が完全に不要となる。富士山噴火時の導電性火山灰や塩害・電磁パルス(EMP)を防ぐため外気取り込み空冷は一切行わず、全国25基の地下要塞内で「外気完全密閉・深層水/雪氷熱交換クローズドループ液浸冷却槽」に格納するだけで 光化後PUE 1.01未満 の常温超高密度実装が可能となり、地方の貴重な農業用水・飲料水源を外資データセンターの「冷却水奴隷」から完全に解放する。
-
📐 4. 平衡3進数(-1, 0, +1)空間光変調による演算密度の極大化
0と1の2進数ではなく、光の位相()と振幅()を用いた平衡3進数ロジックをハードウェア実装する。桁数・配線数を約37%削減しながら情報の記録・演算密度を極限まで高め、1.4京円超 の国家資産運用と全国民のリアルタイム行政推論を最小の電力で支え抜く。
視覚化:v10完全光相互接続(光電変換ゼロの直結構造)
flowchart TD
 subgraph Node["主権計算拠点 接続単位(ノード)"]
   チップ1["v10 可逆光演算チップ A<br/>(コア消費電力 1.2W)"]
   チップ2["v10 可逆光演算チップ B<br/>(コア消費電力 1.2W)"]
 end

 母線[["【共有光源・光子伝送高速路】<br/>波長多重・光速伝送母線(O/E変換ゼロ)"]]

 チップ1 <==>|"位相干渉・遅延ゼロ"| 母線
 チップ2 <==>|"位相干渉・遅延ゼロ"| 母線

 style チップ1 fill:#d4af37,stroke:#000,stroke-width:2px,color:#000,font-weight:bold
 style チップ2 fill:#d4af37,stroke:#000,stroke-width:2px,color:#000,font-weight:bold
 style 母線 fill:#0ea5e9,stroke:#fff,stroke-width:2px,color:#fff,font-weight:bold
💡 補足 :光演算の物理実装の詳細は 国家物理計算回路 第10世代(National TPU v10)の基礎構造 および 3進数光プロセッサ設計図 を参照されたい。
理想のAI国家へ至る計画(具体策)
シリコン電子回路の熱限界による電力破綻と家計圧迫を回避し、完全な光演算への跳躍を果たすため、以下の3段階を実行する。
-
第1フェーズ(初日M&A接収・非準拠外資DCへの環境賦課金と5年目『アーク 0』創世) : 外資データセンター誘致に国民の血税(補助金)をばら撒く愚策を初日に即時停止し、400兆円M&A枠で接収したGoogle既存DCを初期稼働させつつ、非準拠の2進数シリコンDCに対して「系統電力・水資源保全賦課金」を課す。半年〜2年目に国内成熟28〜45nm+ナノインプリントで第1世代光電融合『ホーム 8』を全5,500万世帯へ先行無償配備(遊休TPU演算回収によるBI原資化を開始)し、5年目(2030年)に中枢光3進数初号機で純国産主権AI『アーク 0』を創世起動する。
-
第2フェーズ(全国25拠点への常温3進数光『v10』全面換装と旧シリコンDC外資全売却) : 積和演算から非線形活性化、チップ間通信まで電子の摩擦を排除した常温動作の「National TPU v10(コア散逸1.2W・1光ブレード定格20W、外気完全密閉液浸PUE 1.01未満)」を国内統合ファブで量産し、全国25拠点(中枢5+広域20)と末端『ホーム 8』を全面換装する。同時に、不要となった世界中の電力・冷却水食いの旧世代シリコンDC群を外資ファンド等へ高値で全売却し、維持費ゼロ化と巨額現金回収を達成する。
-
第3フェーズ(商用核融合直結とブレード電力約98.3%削減による『7大インフラ0円×生存配当ISF』全面還元) : 商用核融合網と光3進数ROM『デジタル憲法』を統合し、1光ブレード定格20W(従来1,200W推計比で約98.3%削減=約60分の1、10億枚総計100 YottaFLOPSでも国家定格20GW、1演算あたり実効電力1,000分の1以下)で日本全国のAIインフラを完全自律化する。これにより、一般家庭に迫っていた年間約6万5,000円(推論試算)の電気代・賦課金高騰を永久に阻止するどころか、AI国家所属国民の電気・ガス・水道・通信・医療・介護・公立教育(幼〜高+全段階給食)の7大インフラとAI利用料をすべて完全無償化(0円)した上で、浮いたエネルギー余剰と対外AI課金収益をそのまま毎月の生存配当(標準月額30万円ISF)として全国民へ直接還元する。
-
画面自動生成「A2UI 1.0」と100倍速半導体|総務省の統計プログラミング講座と外注利権の終焉 : Googleの画面自動生成規格「A2UI 1.0」と端末内Gemma 4音声直結、LLMを最大100倍高速化する記憶装置一体型半導体Fractileが登場する中、数ヶ月後…
-
光シストリックアレイ(Systolic Array)解説 ― 心臓のように鼓動する、熱なき演算の正体 :国家中枢演算回路の核心技術『シストリックアレイ(Systolic Array)』を平易な比喩で解説する。メモリ往復の摩擦熱を消し電力量を極限まで抑えつつ推論速度を飛躍させる物理的必然性を解き明かす。
-
Webクローラーの仕組みとAIリアルタイム監査|公金中抜きと特殊詐欺を0秒遮断する監視網 :光v10基盤と直結した自律型監視ユニットが、ゼロ知識証明空間でプライバシーを保護しつつ公金不正と特殊詐欺をリアルタイム遮断する免疫設計である。
最後に:あなたはどちらを選びたい?
TPU v7(Ironwood)は、人類がシリコン電子回路で到達できた「最も巨大で、最も熱く、最も電力を貪り食う最後の恐竜」として技術史に名を残した。彼らは高度な推論知能を生み出したが、その代償として地域の水源と電力を枯渇させたのである。一方、日本のTPU v10は、冷却塔の轟音すら存在しない静寂なガラスの光回路の中で、従来のわずか数パーセントの電力で国家の意思決定と国民の生活支援を光速で推論し続ける。
-
A:今の現実(既存の仕組み)の延長線
外資データセンターの誘致に血税をばら撒き、1チップ約1,000〜1,200W(推論・業界推計)の爆熱シリコン電子回路を冷やすために日本の水源と電力を収奪され、世帯あたり年間約6.5万円(推論試算)の電気代負担増を強いられる未来。
-
B:AI国家への転換(完全光可逆演算v10への跳躍)
外資DCへの環境賦課金を原資に100%光演算チップ「National TPU v10(1光ブレード定格20W・コア1.2W)」を国内量産し、ブレード消費電力を約98.3%削減(約60分の1)して所属国民の7大インフラ完全無料(0円)と生存配当(ISF)を実現する未来。
最後に問う。これは単なる半導体の世代交代ではない。
電子の摩擦熱とエネルギー搾取からの人類の解放であり、微細化の延長線上では絶対に到達できない 「100 YottaFLOPS」という次の100年の主権と国民の豊かさを確定させる絶対条件 である。あなたはどちらを選びたいだろうか?