【AIの裏側解剖】1億人を同時にさばく『現代版TSS』の仕組みと、今の会話が他人にリアルタイムで漏れない理由
毎日何気なく使っている Gemini や ChatGPT ですが、ふと 「世界中で何億人も同時に話しかけているのに、裏側では 1 億個の AI が同時に動いているの?」「今ここで私が打ち明けている仕事の愚痴や家族の相談が、AI に覚えられて赤の他人の画面にポロッと出たりしないの?」 と疑問や不安を感じたことはありませんか?
結論から言うと、AI の心臓部では昔の大型コンピュータの TSS(タイムシェアリングシステム:時分割処理) を極限まで進化させた仕組みで「1 つの巨大な脳」を超高速で使い回しています。しかも本番稼働中の AI の脳(重みデータ)はカチカチに冷凍保存されており、各ユーザーの会話は 「完全に密閉された個室」 に隔離されているため、あなたが今話している内容を AI の脳(モデルの重み記憶)を通じてその場で他人に喋ってしまうことは構造上 100% あり得ません。一方で「将来のバージョンアップの学習材料」に使われるルートは別に存在するため、その正確な境界線と安全なオフ設定、さらに 「みんなが個人情報を遮断すると、今度は AI 自身がどんどん馬鹿になっていく(モデル崩壊)」という皮肉な裏事情 までわかりやすく解説します。
-
【自腹課金レビュー】Google AI ProとUltra(5x・20x)の選び方!週間制限の壁とChatGPT・Claude徹底比較 : シリーズ第 1 弾。無料版・Pro(2,900 円)・Ultra(14,500 円〜)の損益分岐点と、3 大 AI のリアルな使い分けレビューはこちら。
-
【AI取扱説明書】なぜAIは平気で嘘をつき長話でボケるのか?コンテキストの『1MB限界』と賢い付き合い方 : シリーズ第 3 弾。なぜ AI は知ったかぶりの嘘をつき、会話が長くなると急にボケ始めるのか? 失敗しない「1MB・300DPI の整理術」を解説しています。
-
無料学習によるモデル崩壊の打破 ―― 『口の堅い弁護士AI』と集合知蒸留エンジン : 個人情報を遮断した結果、ネットの無料ゴミデータばかりを食べて AI が馬鹿になる「モデル崩壊」の正体と、秘密を 100% 守りつつ賢くなる次世代設計の深掘り解説です。
-
LINEを使うなら今持っているスマホとは独立したスマホを持て! : 便利なアプリやクラウドサービスを使う際、自分の大切な連絡先やプライバシーをどうやって切り分けて守るかの実践防衛術です。
-
使わなくなったiPhoneやiPadの使い道 : 端末やアカウントを用途別に分けて安全・快適に使い倒すアイデア集。
-
「今 AI に相談した内容が、そのまま AI の知識になって他の人にバレたりしないの?」と不安を感じている方
-
世界中で 10 億人規模の人が使っているのに、なぜ待たされずに自分専用の返事が返ってくるのか不思議に思っている方
-
昔メインフレーム(大型汎用機)の TSS(タイムシェアリング) に触れたことがあり、現代の AI データセンターがどう動いているのか興味がある方
-
「有料プラン(Pro や Ultra)にお金を払っていれば、勝手に学習データには使われないはず」と思い込んでいる方
-
Gemini・ChatGPT・Claude で自分の会話を学習や人間の目視チェックに回させない具体的な設定手順を知りたい方
-
みんなが個人情報や社外秘を「学習オフ」で遮断したら、これからの AI は一体何を読んで賢くなるのか(逆に馬鹿にならないのか)気になった方
ワシらの世代だと、1 台の巨大な大型コンピュータに何百人もの端末がぶら下がって、ちょっとずつ時間を切り売りしてもらう「TSS(タイムシェアリングシステム)」が懐かしいんじゃが、今の AI が何億人も同時に相手しとるのも、実はあれの超進化版だったんよな!
まさにその通りなんです!しかも 1 回のチャットでひと昔前のスパコンが何秒も唸るようなとんでもない回数の計算が走っているんですよ。ブラックボックスに見える AI の舞台裏を、一緒に覗いてみましょう!
何億人も同時に相手にするAIはどう動いているのか
チャット1回で走る数千兆から数京回の猛計算
まず驚くべき事実からお話しします。私たちが AI に「これについて教えて」と質問を投げ、AI が 約 1,000 トークン(日本語でおよそ 800〜 1,200 文字前後) の丁寧な回答を返してくれるとき、裏側のサーバーでは一体何回くらいの計算(浮動小数点の掛け算と足し算:FLOPs)が行われていると思いますか?
AI の推論では原則として 「1 パラメータあたり 1 トークンにつき約 2 FLOPs(掛け算 1 回+足し算 1 回)」 の演算が必要になります。したがって、大規模モデル(パラメータ数が約 1.8 兆個クラスの密[Dense]モデルと仮定した場合の推論試算)で計算すると、1 トークンあたり約 3.6 兆回 × 1,000 トークン = たった 1 回の回答出力だけで約 3,600 兆回(3.6 PFLOP = 0.36 京回)、さらにこれまでの長文履歴の照合(Attention 演算)や裏側の深い思考(Thinking)トークンが積み重なると、1 回の返信だけで 数京回(1 京= 1 兆の 1 万倍) もの計算が走ります(※近年の主流である MoE[Mixture of Experts:1 トークンごとに必要な一部の専門回路だけ動かす省エネ構造]では実効パラメータ数が数分の一〜十分の一に絞られますが、それでも数千〜数万トークンの思考ループや長文文脈を含めると 1 回の返信で数千兆〜数京回規模の凄まじい演算が走っています)。かつて世界一を争ったスーパーコンピュータ「京(毎秒 1 京回)」が全力で数秒間フル稼働し、現代の「富岳」クラスでも数ミリ秒〜コンマ数秒間すべての計算力を注ぎ込むほどの演算量が、たった 1 人のチャット 1 回の裏で吹き荒れているのです。
ちょっと待って!そんなに凄まじい計算をしているのに、なんで画面には 0.1 秒後から「パラパラパラ……」って流れるように文字が出てくるの?
ここに、現在の AI(大規模言語モデル)の一番面白いカラクリがあります。AI は最初にあなたの質問文をまとめて一括並列で読み込む工程(Prefill:プリフィル)を一瞬で終えたあと、返事の文章を作る工程(Decode:デコード)に入ると 「全体としては究極の単線(シリアル処理)なのに、1 トークンの中身だけが超並列(パラレル処理)」 で動くのです。
-
文章づくりは 1 文字ずつの単線(自己回帰ループ) :AI は最初から 1,000 文字の完成原稿をまとめて思い浮かべているわけではありません。「今日」から「の」を予測し、「今日の」から「天気」を予測し、「今日の天気」から「は」を予測する……という具合に、前の 1 文字(※厳密には 1 文字〜数文字の塊である『1 トークン』単位)が決まらないと絶対に次の計算に進めない単線構造 になっています。約 1,000 トークン返すには、このループを地道に 1,000 回繰り返しています。
-
たった 1 文字を決める瞬間に「数万個の演算回路」が一斉稼働 :その代わり、「次の 1 文字は『は』が 98%、『を』が 1%……」と決める 1 ループの中では、データセンターにある数万個の専用演算コアが一斉に並列で掛け算と足し算を終わらせます。
-
計算が終わった 1 文字から順番に画面へ送る(ストリーミング) :1,000 回すべてのループが終わるまで待たせると 10 秒〜 20 秒間ずっと無反応になってしまうため、1 文字決まるたびにコンマ数秒で手元の画面へ送り出しています。だから文字がパラパラと流れるように表示されるのです。
大型汎用機のTSSが進化した時分割と並列処理
では、本題です。もしリアルタイムで世界中の 1 億人が AI を使っているとしたら、データセンターの中に「1 億個の AI のコピー」が並んで同時に仕事をしているのでしょうか?
答えは NO です。数百ギガバイト〜テラバイト級もある巨大な AI の脳(モデル)を 1 億人分もコピーして動かしたら、地球上の発電所をすべて使っても電気が足りません。
実際には、昔の大型汎用機(メインフレーム)で活躍した TSS(Time Sharing System:時分割処理) と、現代の専用チップ(Google の TPU 等)ならではの 連続バッチ処理(Continuous Batching:回答が終わった人の枠へ次の人を 1 トークン単位で隙間なく差し込む一括束ね処理) を組み合わせたハイブリッド方式で動いています。
-
1 つの巨大な脳(モデル)はメモリに常駐して動かない :データセンターの超高速メモリ(HBM)の上には、辞書と文法書を完璧に暗記した「1 人の超巨大な通訳者(AI モデルの重みデータ)」が 24 時間座ったまま待機しています。人が変わるたびにこの巨大な脳を読み込み直していたら何十分もかかってしまうため、脳自体はピクリとも動かしません。
-
1,000 人分の「次の 1 文字」を束ねて一撃で計算する :AI は世界中の人から届いた質問をバラバラに計算するのではなく、コンマ数秒の間に届いた 「1,000 人分のリクエスト」をひと束(バッチ)にまとめ、1 回の行列計算で 1,000 人それぞれの「次の 1 文字」を一気に弾き出します。
-
ミリ秒単位の超高速タイムシェアリング :1 文字出したら次の瞬間には別の人たちの束を処理し、また数ミリ秒後にあなたの 2 文字目に戻ってきます。人間の目には感知できない猛スピードで 1 つの巨大な脳が何億人の間を飛び回っているため、利用者からは 「あたかも自分専属の AI が目の前に座って相手をしてくれている」 ように見えるのです。
長考中も占有しないKVキャッシュの3段階退避
さらに「なるほど!」と膝を打ったのが、AI に難しい作業を頼んで数分間じっくり考え込んでいるときや、私たちがコーヒーを淹れに席を立っている間の動きです。
実際に開発環境で大量のファイルを読み書きさせた際、画面上に Thought for 4687s(タイムスタンプ上の経過で約 78 分)のような長い思考ログが出たことがあり、「こんなに長い間、私が Google の高価な AI チップを独り占めして邪魔しているの?」と調べてみたところ、驚くほど賢い 「記憶の 3 段階退避(KV キャッシュのスワップ)」 が行われていました。
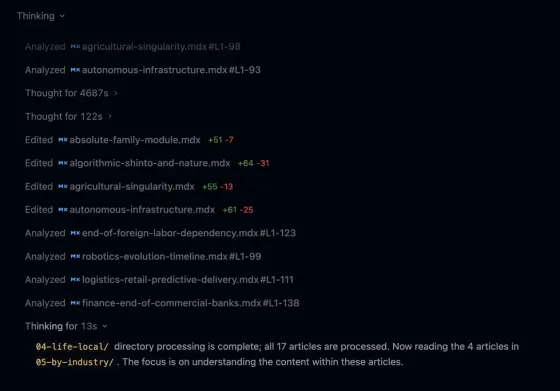
▲ 手元のパソコンが作業している間、クラウドの AI チップは他人に席を譲っています
AI チップの部屋にいる「通訳者(モデル)」は、あなたと会話している間、これまでの話の流れを毎回イチから読み直さなくて済むように 「自分用の付箋メモ(専門用語で KV キャッシュ:Key-Value Cache)」 を手元に作っています。この付箋メモは OS の仮想メモリと同じような仕組み(PagedAttention 等)で細かいブロック単位に分割・隔離管理されており、パソコンの階層メモリとそっくりな 3 階層の棚(商用推論基盤における典型構成の推論・整理) を行き来しています。
| 記憶の置き場所(階層) | いつ使われるか | 裏側で起きていること |
|---|---|---|
| 第1階層:AIチップ直結の超高速メモリ(HBM) | まさに今、文字を生成している数秒間 | 最高速の一等地。推論バーストが終わった瞬間にすぐ空け渡す。 |
| 第2階層:サーバー側のメインメモリ(DRAM) | 手元のパソコンがファイルを処理している数秒〜数十秒間 | あなたが次の返事を打つまで、すぐ取り出せる隣の棚で待機。 |
| 第3階層:高速SSDプール(記憶装置) | コーヒーを淹れに行って数分以上やり取りが止まった時 | 付箋メモを丸ごと SSD へ一時退避し、メモリ枠を他の利用者へ完全に譲る。あなたが戻ってきて送信した瞬間に光通信で一瞬で呼び戻す! |
つまり、どれだけ長い時間チャット画面を開きっぱなしにしていても、実際にデータセンターの心臓部を借りているのは 「文字を生み出しているほんの数秒〜数十秒の瞬間だけ」 なのです。実に無駄のない見事な設計ですよね。
今の会話が赤の他人にリアルタイムで漏れない理由
映画と違い本番稼働中のAIの脳は冷凍保存状態
さて、ここからが一般の利用者にとって一番大切な プライバシーと安心の話 です。
SF 映画に出てくる AI は、人間と会話しながらリアルタイムでどんどん新しい知識を吸収して勝手に賢くなっていきますよね。そのため、「私が今チャットで話した会社の悩みや個人的な相談を AI がその場で覚えてしまい、5 分後に別の赤の他人が似た質問をしたら『さっき〇〇さんがこう言っていましたよ』と喋ってしまうのでは?」と心配する方が少なくありません。
安心してください。現実の AI は 「勉強期間(学習フェーズ)」と「本番稼働(推論フェーズ)」が物理的に真っ二つに切り離されており、私たちが普段会話している本番稼働中の AI の脳(パラメータ)は カチカチに冷凍保存(固定) されています。
なんでリアルタイムでどんどん覚えさせんのじゃ?その方が毎日賢くなって便利そうじゃが?
もし本番稼働中にリアルタイムで脳の配線を書き換えてしまうと、2 つの大事故が起きるからなんです。1 つは、新しいことを無理やり覚えさせた拍子に昨日までできていた計算や言葉を突然忘れてしまう 「破滅的忘却(カタストロフィック・フォゲッティング)」。もう 1 つは、悪意のある人が嘘の知識を吹き込んだ瞬間に、世界中の AI が一斉に嘘をつき始める汚染事故です!
だからこそ、あなたが今どれだけ深い秘密や独自ノウハウを AI に語ったとしても、それは先ほど説明した 「あなた専用の付箋メモ(短期記憶のコンテキスト)」 の上に一時的に乗っているだけで、全ユーザーが共有している「AI 本体の冷凍された脳」には 1 ミリも書き込まれません。会話が終われば、その付箋メモは片付けられて消えていきます。
密閉された個室ゆえの安心感ともったいない弱点
つまり現在の AI は、セキュリティとプライバシーを守るために、利用者一人ひとりを 「防音壁で完全に密閉された個室(サンドボックス)」 に入れて接客しているのと同じ状態です。
-
嬉しいメリット(鉄壁のリアルタイム隔離) :隣の個室にいる赤の他人が、あなたの個室の会話や付箋メモ(KV キャッシュ)を覗き見たり、AI の重み記憶経由でリアルタイムに聞き出したりすることは構造上できません(※なお厳密には、応答時間のわずかな差からキャッシュの有無を推測するタイミングサイドチャネル攻撃を防ぐため、商用クラウドではユーザー固有文脈のキャッシュ再利用スコープも同一アカウント・同一組織内に厳格限定されています。万が一 Web アプリケーション側のセッション管理バグや、利用者自身が連携させた外部ツール設定ミスがあれば別問題ですが、AI の脳そのものが会話を覚えて他人に漏らすことはありません)。
-
裏返しの弱点(集合知のもったいない機会損失) :その代わり、もしあなたが個室の中で「誰も気づいていなかった画期的なバグ解決法」や「世の中全員の役に立つ知恵」を AI と一緒に見つけ出したとしても、今の AI はそれを隣の人へ伝えるパイプを持っていません。人間のベテラン弁護士や医師なら「依頼人の個人情報は墓場まで持っていきつつ、そこで得た普遍的な知恵やノウハウだけを仕事に活かす」ことができますが、今の AI は訴訟リスクを恐れて「個室に完全密閉するか、丸ごと将来の学習データに混ぜるか」の極端な二択しかできないのが実情です。
将来の学習の餌になる境界線と安全な設定手順
無料でもUltraでも同じアクティビティ設定の罠
「なるほど!リアルタイムで他人に筒抜けにならないなら安心だ!」……と言いたいところですが、1 つだけ絶対に知っておかなければならない別ルート があります。それが 「数ヶ月〜 1 年後の次世代 AI を作るための『再学習データ(学習の餌)』と『人間レビュアーによる品質チェック』」 です。
ここで非常に多くの人が勘違いしている落とし穴があります。
・ 個人向けプランは無料も有料もルールは同じ :「毎月 2,900 円(Pro)や 14,500 円(Ultra)を払っているんだから、私のデータは学習に使われないはず」と思いがちですが、個人向けアカウントの初期設定(デフォルト)では、無料版でも Pro でも Ultra でもすべて『将来のモデル学習・品質改善に利用される設定(オン)』 になっています。
・ 一部の会話は匿名化されて「人間の目」でチェックされることがある :初期設定オンのまま使っていると、AI の回答が適切だったかを改善するため、アカウント情報と切り離す匿名化処理が施されたうえで、外部委託を含む人間のレビュアーが実際の会話テキストを目視で確認・評価するケースがあります。
・ 最初から学習されないのは「法人プラン」と「有料API」だけ :企業向けの Google Workspace や Enterprise 契約、および開発者向けの有料 API 枠は、規約で最初から「学習には一切利用しない」と保証されています。
GeminiやChatGPTやClaudeのオフ手順
「個人向けプランを使っているけれど、自分の相談内容を将来の学習の餌や人間のレビューに回されたくない!」という方は、以下の手順で 学習拒否(オプトアウト)設定 に切り替えることができます(※以下は 2026年10月時点 の公開ヘルプ・規約に基づく設定箇所であり、UI 名称や保持期間は改定される場合があります)。
| サービス名 | 個人プランでの学習オフ(オプトアウト)設定場所 | オフにした後の「一時保存期間」と注意点 |
|---|---|---|
| Google(Gemini) | 画面メニューの 「アクティビティ(Gemini アプリ アクティビティ / アクティビティの保存)」 を開き、上部から 「オフにする」 を選択 | 学習や人間レビューには回らなくなるが、サービス提供・安全維持のため 最長 72 時間 はサーバーに一時保持される(履歴一覧は非表示になる)。 |
| OpenAI(ChatGPT) | 「設定(Settings)」→「データコントロール」→ 「すべての人のためにモデルを改善する」をオフ | 学習には使われなくなるが、不正利用監視のためサーバー上に 最長 30 日間 保持された後に削除される(法的義務等がある場合を除く)。 |
| Anthropic(Claude) | 「Settings」→「Privacy」→ 「Help improve Claude」をオフ | 個人向けプランでオフにした場合はモデル学習に使われず、通常の保持期間(原則 30 日等・規約違反検知時を除く)経過後に削除される。 |
なるほどなぁ!「オフ」にすれば将来の学習の餌にはならんけど、Gemini は過去の自分のチャット履歴一覧も見られなくなるんか。それはそれで不便じゃな。どう使い分けるのが一番賢いんじゃろ?
私が実践している一番ストレスのない現実的な防衛ラインは、次の 2 段構え です。
-
普段の相談や調べ物は履歴オンのまま便利に使い、生データは伏せ字にする :過去のチャット履歴が残らないと普段使いでは不便なので、日常のアカウントはそのまま使いつつ、「パスワード・口座番号・本名と住所の組み合わせ・社外秘の顧客名」などの生データは絶対にそのまま貼らず、『A社』『山田太郎(仮名)』のように伏せ字(マスキング)にしてから投げる クセをつけます。
-
どうしても丸ごと処理したい機密書類は「一時チャット / オフ設定」か「有料API」へ分ける :設定をオフにしても不正悪用防止のため 72 時間〜 30 日間の一時ログ保持自体はどの AI にもあるため、本当に外へ出せないデータはマスクするか、規約で保護された法人環境・有料 API を使うのが鉄則です。
個人情報を遮断するとAIが馬鹿になる皮肉な罠
設定オフや伏せ字で私たちの個人情報を遮断できるのは安心だけど、ふと思ったんだけど……世界中の会社や賢い人たちがみんな「大事な情報は学習オフ!」って隠しちゃったら、これからの AI は一体何を読んで勉強するの?
実はそこが、いま世界中の AI 研究者と巨大テック企業が頭を抱えている 最大のジレンマ なのです。
利用者や企業がプライバシーや社外秘を守るためにデータを遮断すること自体は、自衛策として 100% 正しい行動です。ところが、社会全体で「本当に価値のある生きたデータ」が遮断され続けると、今度は 「AI が新しい知恵を得られず、どんどん馬鹿になっていく(モデル崩壊)」 という深刻な副作用が起きてしまいます。
① 本物の「生きた知恵」は密閉個室に閉じ込められて外に出ない :熟練技術者の暗黙知、企業のリアルなトラブル解決録、専門家の深い試行錯誤といった「AI を本当に賢くする一級品のデータ」は、すべて法人プランや学習オフの「密閉された個室」で遮断されます。しかも米国の調査機関(Epoch AI 等)の試算では、ネット上に無料で公開されている良質な人間の文章データは 2026年〜 2032年頃(早ければ 2028年前後)には使い果たされて枯渇する と警告されています。
② 無料の「薄いまとめ記事」と「AI自身のコピー文章」による自家中毒 :人間の良質なデータが遮断された結果、今のネット空間に溢れているのは「再生数稼ぎの薄っぺらなまとめサイト」や「過去の AI が量産した自動生成テキスト」ばかりです。オックスフォード大学などの研究チームが科学誌『Nature』(2024年)で発表した論文では、新鮮な人間のデータが入らないまま AI が AI の作った文章を繰り返し学習し続けると、少数派の鋭い視点や複雑な論理が削ぎ落とされ、当たり障りのない無意味な回答しかできなくなる「モデル崩壊(Model Collapse)」 が起きることが証明されました。コピー機でコピーした紙を、さらに何十回もコピーし続けると文字が潰れて読めなくなるのと同じ現象です。
③ 「秘密ダダ漏れ」か「遮断して馬鹿になる」かの極端な二択 :本来なら先ほど触れた「口の堅い一流の弁護士」のように、AI の頭の中を 「秘密の記憶を預かる金庫」 と 「純粋な論理を鍛える脳」 に物理的に切り分け、個人の情報を 100% 消去(脱色)した「普遍的な解決法則」だけを全体の知恵として活かせばよいはずです。しかし現在の民間 AI はすべての記憶が同じ網の目に溶け込んでいるため、「個人情報を遮断すれば安全だが AI は馬鹿になり、無差別に学習させれば情報漏洩リスクが消えない」 という袋小路に陥っています。(※ちなみに「クラウドに情報を渡したくないから、手元のパソコンに無料の海外製ローカル AI を入れて動かそう」としても、今度は一般のパソコンに収めるための無理なデータ圧縮[4ビット量子化]で日本語の繊細な記憶が潰れてしまい、やはりお馬鹿になりがちです。)
この「個人情報の完全遮断」と「AI が馬鹿になるモデル崩壊の打破」をどうやって技術的に両立させるのか——記憶と推論を物理分離する 『口の堅い弁護士 AI』 や、圧縮せずに賢く動かす次世代設計については、以下の記事でさらに踏み込んで解説しています。裏側の構造に興味が湧いた方はぜひ覗いてみてください!
- 👉 詳細はこちら(クラウド側の解決策) : 無料学習によるモデル崩壊の打破 ―― 『口の堅い弁護士AI』と集合知蒸留エンジン
- 👉 あわせて読みたい(手元AIの圧縮劣化と解決策) : 無圧縮の『日本特化型AI』と詐欺・工作を100%濾過する『二層式・AI浄水場』
まとめ:裏側の仕組みを知ればAIは怖くない
正体がわからないお化けは怖いですが、裏側の仕組み(アーキテクチャ)がわかれば、AI との付き合い方は驚くほどクリアになります。
・ 1億人同時処理の正体は「現代版TSS」 :1 億個の AI が動いているのではなく、メモリに鎮座する 1 つの巨大な脳が、1,000 人束ねのバッチ処理とミリ秒単位の時分割で「1 文字ずつ」超高速に相手を切り替えている。席を離れれば付箋メモ(KV キャッシュ)は SSD へ綺麗に退避される。
・ 今の会話がリアルタイムで他人に漏れることはない :本番稼働中の AI の脳は冷凍保存されており、各利用者は「密閉された個室」に隔離されているため、あなたが話したことを AI の脳(モデルの重み記憶)を通じてその場で赤の他人に喋ることは構造上あり得ない。
・ 「将来の学習」だけは設定と伏せ字でコントロールする :個人向けプランは Pro でも Ultra でも初期設定は学習オン。見られたくない固有名詞やパスワードは最初から書かない(伏せ字にする)か、アクティビティ設定をオフにして賢く自衛しよう。
・ 個人情報を遮断した裏では「AIが馬鹿になる」問題も進行中 :私たちが自衛のために学習をオフにして生きた知見を遮断するのは正解だが、その結果 AI はネット上の無料ゴミデータや AI 自身のコピー文章ばかりを食べて劣化する「モデル崩壊」に直面している(解決策の詳細は こちらの深掘り記事 へ)。
見落としがちな共有リンクとアカウント保護の注意点
・ 「チャットの共有リンク(公開URL)」発行による意図せぬ流出に注意 :アクティビティ(学習設定)をオフにしていても、自分で「会話を共有(公開リンクを作成)」ボタンを押して URL を発行すると、その URL を知っている第三者が誰でも中身を閲覧でき、共有先から検索エンジン等に拾われるリスクが生じます。社外秘やプライベートな相談を含んだチャットでは、共有リンクを発行しないよう注意しましょう。
・ AIアカウント自体の「パスキー・2段階認証」保護 :過去のチャット履歴には仕事の構想や生活の相談が蓄積されていくため、Google・OpenAI・Anthropic それぞれのログインアカウントには必ず パスキー(生体認証)や 2 段階認証 を設定し、パスワード使い回しによる乗っ取り(履歴の覗き見)を入り口で封じておきましょう。
密閉された個室なら、夜中にこっそり「猫様に嫌われない爪切りのコツ」を相談しても誰にもバレないでちぃ!安心して聞くでちぃ🐾
さて、裏側の仕組みがわかって安心したところで、実際に毎日 AI を使っていると必ずぶつかる最大のイライラが 「なんでこの AI は『知りません』と言わずに堂々と嘘をつくんだ!」「話が長くなると急に認知症みたいに最初の約束を忘れるのはなぜだ!」 という問題ですよね。
完結編となる第 3 弾(【AI取扱説明書】なぜAIは平気で嘘をつき長話でボケるのか?コンテキストの『1MB限界』と賢い付き合い方)では、「200万トークン」という分かりにくい言葉を 「何 MB のファイルまでなら見落とさないのか」 にズバリ翻訳し、今日から劇的に精度が上がる実践テクニックをお届けします!
▲ 口の堅さなら猫様も負けていません(おやつ次第ですが)