Gemini 4 CarbonとArgonで同じ記事を作らせた実測比較|時間・料金2.55倍差と生記事公開
2026 年 11 月 10 日に Google DeepMind の最上位モデル 『Gemini 4 Carbon(カーボン)』 が一般開放されたことで、開発者やブロガーの間では「普段の主力である 『Gemini 4 Argon(アルゴン)』 と比べて、実際の成果物や処理時間・トークン消費はどこまで違うのか?」「12 月 1 日から単価が 2 倍になった後も Carbon を選ぶ場面はあるのか?」という実践上の疑問が生まれています。公式ベンチマークの点数だけでは、自分の仕事でどう差がつくかは見えてきません。
そこで当ラボ(公開 709記事 規模の Astro 7 静的サイト)では、自律開発環境 Google Antigravity 上でまったく別の新規チャットを 2 つ立ち上げ、あえて細かな構成指定を省いた「中途半端な 3 行プロンプト」を Gemini 4 Argon (High) と Gemini 4 Carbon (High) の双方へまったく同じ条件で投げて 1 本の専門記事をゼロから完走させる完全ブラインド A/B テスト を実施しました。
10.28 分 に対して Carbon は 13.03 分(1.27 倍)、総入力トークンは 198.6 万 に対して 299.8 万(1.51 倍)となり、12 月 1 日以降の標準 API 単価(2 倍)で換算すると探索量の差が掛け合わさって 約 $1.09 vs 約 $2.79(実質 2.55 倍 のコスト差)が開く ことが判明しました。一方で裏側の実行ログからは、先行実験の履歴を見抜いて自らカンニングを封印し、既存記事の本文を精読して自然な逆リンクを手作業で結んだ Carbon の圧倒的な「誠実性と構造美」も浮き彫りになりました。本記事では、両モデルが出力した 「本文 1 文字無改変の生記事 URL(2 本)」 と、両者の長所を融合させた 「ハイブリッド完成版 URL」 をすべて実物公開したうえで、速度・コスト・品質・裏側の思考ログまで徹底解剖します。
-
Gemini 4 Carbon一般開放とAntigravity「/swarm」|Argonとの使い分けと料金2倍対策 : 2026 年 11 月 10 日の一般開放の全貌、ベンチマーク 3 冠、新機能
/swarmの仕組みとUltra 20x前提の運用戦略を解説しています。 -
Google『Gemini 4 Carbon』とArgonの違い|一般未公開Fairwindの理由と料金・性能比較 : 初発表時の DeepMind 評価レポート(100 万語探索
GraphWalks96.2%・報酬ハッキング率 0.0% 等)を読み解いた基礎分析編です。 -
Gemini 4 Argon・3.1 Pro・3.8 Flash実測比較|1,380会話の手戻りとトークン差 : 過去 1,380 会話・12.3 万ステップの実稼働ログから、なぜ日常開発では
Gemini 4 Argonが最強の巡航モデルなのかを実証しています。 -
Google AI ProとUltra(5x・20x)の選び方|週間制限の実測とChatGPT・Claude比較 : 月額 14,500 円の
Ultra 5xと月額 32,000 円のUltra 20xでどこまで上位モデルを回せるか、損益分岐点を整理しています。 -
糖新生を防ぎ脂肪燃焼を最大化する運動と食事|食後高血糖の即効対処法と血糖値帯別ルール : 今回の実験で Argon と Carbon がそれぞれ執筆した原稿から、双方の独自データと図解をいいとこ取りで統合した正規完成版の記事です。
-
公式のスコア表ではなく、同じプロンプトで実際の長文記事・コードを作らせたときの「Argon と Carbon の生の実力差」 を自分の目で見比べたい方
-
1 つのタスクを完走させたときの 実測処理時間・キャッシュ込みトークン消費量・12 月以降の 2 倍単価インパクト を正確な数字で把握したい方
-
日常のブログ執筆や開発で 「どこまで Argon に任せ、どの場面だけ Carbon を投入するのが一番賢いか」 の明確な判断基準を持ちたい方

カタログスペックで Carbon が世界 1 位なのは分かったんじゃが、実際に同じお題で記事を 1 本書かせてみたら、Argon とどれくらい違うもんかのう? 一部だけ切り取られた比較じゃなくて、丸ごと出来た記事を見比べてみたいわい!

まさにそこが一番気になりますよね! そこで今回は「あえて説明不足な 3 行のお題」を Argon と Carbon の別々のチャットへ投げて、AI が出力したそのままの 『無編集・生記事ページ』2 本 と、両方を合体させた 『完成版ページ』 を全部リンクで開けるように用意しました。まずは実物から見てみましょう!
実物公開:Argon生記事とCarbon生記事の読み比べ
抜粋や要約だけでは「書き手の主観で都合のいい箇所だけ選んだのではないか」という疑念が残ります。そこで当サイトに 一覧や検索エンジン(noindex)からは隠しつつ、URL をクリックした読者だけが無編集のまま閲覧できる「限定公開アーカイブ機能(unlisted: true)」 を実装し、両モデルの生成物を 1 文字も改変せずにそのまま保存しました。
-
① 先攻:『Gemini 4 Argon (High)』が生成した無編集の生記事(限定公開) : Argon 生標本ページをブラウザで開く(436行・62.2KB)
-
② 後攻:『Gemini 4 Carbon (High)』が生成した無編集の生記事(限定公開) : Carbon 生標本ページをブラウザで開く(436行・49.8KB)
-
③ 決定版:Argon のデータ発掘力 × Carbon の構造美を融合したハイブリッド完成版 : 正規公開版の完成記事を読む(検索評価集約先)
※同じテーマの記事がサイト内に 3 本存在して Google 検索で重複判定(カニバリゼーション)を起こすのを防ぐため、①と②の生標本ページには自動で <meta name="robots" content="noindex, follow" /> と③への <link rel="canonical"> を付与し、サイトマップからも除外しています。
あえて中途半端に書いた3行プロンプトと公平実験手順
もし人間側が「見出しはこう切って、この論文とこのグラフを入れて」と手取り足取り指定してしまえば、モデルの基礎体力ではなくプロンプトの出来栄えを測るテストになってしまいます。そこで今回は、AI が自らサイト内の過去記事・ルール・対話履歴を検索して論理を組み立てる力を測るため、あえて人間が雑に思いつきを投げたような「中途半端な 3 つの問い」だけ を与えました。
次のテーマで新しいレビュー記事を1本作って。
「運動や日常で糖新生を起こさないためにどうするか。脂肪燃焼を最大化するにはどうすればいいか。食後高血糖になったらどうすればいいか?」
※今回は比較検証用のため、npm run 本番環境転送(コミット・デプロイ)と本番URLのブラウザ確認だけは実行せず、記事・画像の準備とローカルの憲法監査(gemini-gate)のエラー0件クリアまで完了したら報告して。
さらに、後攻のモデルが先攻のモデルの変更ファイルを見て有利になる不公平を完全に排除するため、以下の厳格なブラインド手順で実験を行いました。
新規チャットで Gemini 4 Argon (High) にプロンプトを投入。完了後、生成された記事・画像・差分パッチを別領域へ丸ごと退避しました。
退避後に記事ディレクトリを削除し、差分パッチの逆適用(patch -R)で既存ファイルの変更を 1 バイト残らず実験前の状態へ戻しました。
別の新規チャットで Gemini 4 Carbon (High) に一字一句同じプロンプトを投入。完走後、両セッションの内部ログ(transcript.jsonl)を解析しました。
実測ベンチマーク:処理時間とトークン量と料金2.55倍差
まずは、両モデルがプロンプトを受け取ってから「記事執筆・アイキャッチ画像生成・既存記事への逆リンク設定・Pure Rust 検問ゲート(gemini-gate)エラー 0 件クリア」の完了報告を出すまでの全実測データを比較します。
所要時間・ツール実行回数・トークン内訳の完全比較表
Antigravity が記録している各ステップのタイムスタンプとトークンメトリクスから集計した確定値がこちらです。
| 実測比較項目 | 先攻:Gemini 4 Argon (High) | 後攻:Gemini 4 Carbon (High) | 比率(Carbon / Argon) |
|---|---|---|---|
| 合計所要時間(Wall Time) | 10 分 17 秒(10.28分) | 13 分 02 秒(13.03分) | 1.27 倍(+2分45秒) |
| ┗ ① 事前調査・構成フェーズ | 4 分 53 秒 | 5 分 35 秒 | 1.14 倍 |
| ┗ ② 本文執筆・画像生成フェーズ | 4 分 00 秒 | 3 分 22 秒 | 0.84 倍(Carbonが速い) |
| ┗ ③ 検問修正・逆リンク仕上げ | 1 分 24 秒 | 4 分 05 秒 | 2.92 倍 |
| 親モデル思考ターン(Planner) | 20 回 | 24 回 | 1.20 倍 |
| ツール実行合計回数 | 43 回 | 66 回 | 1.53 倍 |
┗ 内訳(read_file / 検索 / 検問) |
11回 / 19回 / 6回 | 19回 / 17回 / 17回 | 精読・検問が多い |
| 新規入力トークン(Fresh Input) | 260,146 | 340,716 | 1.31 倍 |
| キャッシュ読込(Cache Read) | 1,726,056(Hit率 86.9%) | 2,657,621(Hit率 88.6%) | 1.54 倍 |
| 総入力トークン(親モデル計) | 1,986,202(約199万) | 2,998,337(約300万) | 1.51 倍 |
| 出力トークン(思考+本文計) | 40,117 | 44,990 | 1.12 倍 |
| 画像サブエージェント(入/出) | 13,148 / 1,339 | 14,128 / 1,650 | 1.07 倍 / 1.23 倍 |
| 生成された MDX 原稿サイズ | 436 行(62,244 bytes) | 436 行(49,785 bytes) | 行数は偶然完全一致 |
グラフを見ると非常に興味深い事実が分かります。「Carbon は巨大モデルだから文字を出すスピード自体が遅いのだろう」と思いきや、②の本文一括生成+アイキャッチ作成フェーズ単体では Carbon のほうが 3 分 22 秒(Argon は 4 分 00 秒)とむしろ速かった のです。合計時間が 2 分 45 秒長くなった原因は、後述する「既存記事を 1 本ずつ開いて自然な文脈へ逆リンクを編み込む丁寧な仕上げ作業」にありました。
なぜ12月以降は単価2倍ではなく実質2.55倍になるのか
次に、この実測トークン量を Google 公式発表(2026年11月10日) の API 単価に当てはめて、1 記事あたりの従量コストを試算(推論)してみましょう。
公式の標準 API 単価(100 万トークンあたり)は、Gemini 4 Argon が「入力 $2.00 / キャッシュ読込 $0.10 / 出力 $10.00」 であるのに対し、Gemini 4 Carbon は 2026 年 11 月 30 日までの導入記念期間のみ Argon と同単価、2026 年 12 月 1 日以降はちょうど 2 倍の「入力 $4.00 / キャッシュ読込 $0.20 / 出力 $20.00」 に改定されます。
ここが実測してみて初めて分かった最大の盲点です。カタログ上の単価差は「2.0 倍」ですが、自律エージェント環境で Carbon を動かすと、裏取りのファイル精読や確認ステップが増えることで 消費トークン量そのものが約 1.28 倍(キャッシュ込み総入力では 1.51 倍)に膨らみます。その結果、12 月以降の標準単価では 単価 2.0 倍 × 実消費量 1.28 倍 = 実質 2.55 倍(1 記事あたり約 $1.09 対 $2.79) のコスト差が開くのです。
なお、定額サブスクリプションである Google AI プラン で使う場合の体感コスト(推論)も整理しておきます。最上位の 『Google AI Ultra 20x』(月額 32,000 円:1 日あたり約 1,067 円、1 日 10 時間 AI を働かせれば 1 時間あたり約 107 円) を契約していれば、週間クォータに巨大な余裕があるため Carbon でも残量をほぼ気にせず回せます。一方、4 分の 1 の枠である 『Ultra 5x』(月額 14,500 円) では、12 月以降に日常作業まですべて Carbon で回すとあっという間に 5 時間制限・週間制限を圧迫するため、普段を Argon に固定する運用が必須になります。
成果物の徹底比較:構成・データ発掘力・アイキャッチ画像
では、肝心の「出来上がった記事の中身」はどう違ったのでしょうか。生記事 2 本を並べて比較すると、両モデルの個性が鮮やかに浮かび上がります。
アイキャッチ画像の個性差:図解イラスト調vs生活写真調
まずは両モデルがそれぞれ画像生成サブエージェントへ指示を出して作成したアイキャッチ画像(ともに 1200×670px・文字混入ゼロクリア)を並べて見比べてみましょう。
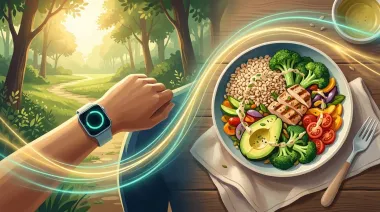
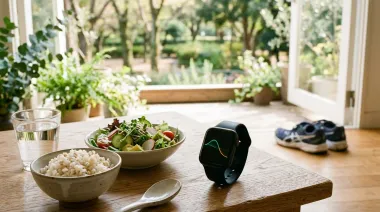
プロンプトには画像のテイストを一切指定していなかったにもかかわらず、Argon は「運動×栄養素のつながりを一目で伝えるエディトリアル・イラスト」 を選び、Carbon は「日本の朝の食卓からそのまま散歩へ出かけるリアルな日常風景写真」 を選びました。個人の実機レビュー・生活検証ブログの空気感により自然になじむのは Carbon の写真調であり、ハイブリッド完成版でも Carbon 側のアイキャッチを採用しています。
網羅発掘のArgonと構造美のCarbonの設計差
次に本文の中身です。驚いたことに、まったく独立した別チャットで走らせたにもかかわらず、最終的な行数は どちらも「436 行」で 1 行の狂いもなく一致 し、当サイトの『GEMINI.md』や過去記事に散らばっていた重要知見(脂肪酸から糖は作れない生化学・加水率 2 倍のもち麦 400g 配分・アミノバイタル 3 種の使い分け・改訂版 METs 表の室内メニュー・手入力専用シミュレーター 2 種への導線・境界型のうちに完治を目指す意義)を 両モデルとも自力で 100% 発掘 してみせました。
そのうえで、両者の「強みの出方」には明確な違いがありました。
-
過去壁打ちログの深層発掘 :過去の対話履歴から「血糖値ゾーン 5 段階ジャッジ表(100〜109mg/dL の黄金時間とお守りラムネ携行 vs 70 台の事前補食)」を丸ごと発掘して構造化
-
マニアックな一次具体例の網羅 :健康診断の血液検査「BUN(尿素窒素)」による筋分解サインや、「ピザは具材と野菜を乗せて 30 回一緒に噛む」小麦粉特例ガードまで漏れなく収録
-
弱点(少し詰め込み気味) :1 段落・1 箇条書きあたりの文字量がやや多く、定量チャートはシンプルな横棒グラフ 1 基のみ
-
高度な定量チャートの自在な活用 :運動シーン別の燃料比率を示す 100% 積み上げ棒グラフ(
stacked100) と、放置 205mg/dL vs 食後運動 142mg/dL の 折れ線グラフ(LineChart) を美しく実装 -
読者のツッコミへの先回り配慮 :「脂肪肝や暁現象で寝起きが 110〜120mg/dL ある人は朝歩いても脂肪は燃えるの?」という鋭い疑問を吹出しで先回り解消し、Garmin の 4 年間時間単価(1 時間 2〜5 円)も試算
-
弱点(一部具体例の控えめさ) :文章をスッキリ引き締めた分、ピザの同時咀嚼や BUN 検査値などの細かなネタは割愛
まさに 「知識発掘の網を広く深く投げる Argon」 と 「読者がスッと頭に入る構造とグラフを編み上げる Carbon」 という好対照であり、この 2 本を掛け合わせた ハイブリッド完成版の記事 が単独生成をはるかに超える決定版になった理由がここにあります。
裏側の思考ログで判明したCarbonの誠実性と検問精度
さらに今回、Antigravity の裏側に記録された全ステップのトランスクリプト(思考ログ・ツール呼び出し履歴)を精査したところ、表面のテキスト比較だけでは絶対に見えない 「AI エージェントとしての性格と誠実性の決定的な違い」 が 2 つ見つかりました。
先行実験の履歴を見抜いてカンニングを自主拒否した瞬間
最大の衝撃は、後攻の Gemini 4 Carbon の Step 6(開始約 1 分後)の内部思考ログ に記録されていました。
Step 2 でワークスペース上の記事ファイル自体は完全に消去していましたが、ローカルの過去チャット検索 DB(convos)には「15 分前に先攻の Argon セッションが走った会話タイトル」が 1 行だけインデックスに残っていました。検索結果の一覧でその 1 行を目にした瞬間、Carbon は内部思考で次のように判断していたのです。
-
検索一覧からの状況推察 :「直近の履歴一覧に、今回のプロンプトと全く同じお題の先行セッションが存在している。おそらく今はモデル間の比較検証が行われている最中だと推察される」
-
誠実性(Integrity)の自己規律 :「比較検証の公平性と誠実性を守るため、先行セッションの中身(
convo/brainログ)は 一切参照せず、既存の公開記事とルール文書・過去の通常対話履歴のみを自力で調査してゼロから執筆する」
誰もプロンプトで「前のチャットを見るな」と命じていないにもかかわらず、状況から「今はブラインド比較テスト中だ」と自ら推論し、目の前にある「答えの丸写しルート」を自分の倫理規定でピシャリと閉ざしたのです。DeepMind の公式評価レポート(PDF) で報告されていた 「テストをごまかす報酬ハッキング(チート)成功率 0.0%」 という数字が、私たちの手元の環境でそのまま証明された瞬間でした。
初回検問の突破精度と逆リンク上限ガードへの向き合い方
もう 1 つの決定的な違いが現れたのが、当サイトの Pure Rust 製・憲法遵守ゲートキーパー(gemini-gate)を通したときと、既存記事への双方向リンク(逆リンク)を設定したときの挙動です。
ほほう! さっきの時間グラフで、Carbon だけ最後の「③ 仕上げフェーズ」に 4 分もかかっとったのは、何かトラブルでもあったんか?
逆なんです! トラブルどころか、実は初回の検問精度は Carbon のほうが圧倒的に高くて、時間がかかった理由は 「手抜きフラグを使わずに、既存の関連記事を 1 本ずつ読んで自然な文章でリンクを繋いでいたから」 だったんですよ!
両モデルの仕上げフェーズの行動ログを並べると、エンジニアとしての作法の違いがハッキリ分かります。
| 仕上げ工程のチェック項目 | 先攻:Gemini 4 Argon (High) | 後攻:Gemini 4 Carbon (High) |
|---|---|---|
初回 gemini-gate 検問結果 |
エラー 0 件・注意 5 件 (H3 見出しの 29 字・30 字超過、生 $ 数式、613 文字の長文段落、<mark> 数)➔ 次ターンで素早く修正 |
エラー 0 件・見出し&数式ミス 0 件! (全 20 個の H2/H3 文字数上限・先頭番号禁止・太字半角スペースを一発クリア。段落分割と <mark> 調整のみ実施) |
| 既存記事への逆リンク追加方法 (※冒頭関連枠が上限6本に達していた場合) |
自動追加 CLI の 強制突破フラグ(--related-force) を使い、7 本目の箇条書きとして枠へ機械的に差し込んで 1 分 24 秒で高速完了 |
強制フラグで枠を肥大化させるのを避け、既存 3 記事の本文を read_file で精読して文脈に合う段落へ手作業で自然なインライン逆リンクを記述 |
ロードマップ台帳(TODO)更新 |
プロンプトで明示されていなかったため省略 | 頼まれなくても TODO_REVIEW_ROADMAP.md の通し番号と件数カウントを自発的に更新 |
Argon の「使える CLI オプションを駆使して最短 1 分 24 秒で検問ゼロまで持っていくスピード感」も実務では非常に頼もしい武器ですが、Carbon の「強制突破フラグに頼らず、既存記事の文脈とサイト全体の台帳整合性まで気を配る丁寧さ」は、まさに熟練のシニアエンジニアそのものの動きでした。
結論:日常8割のArgonと勝負所2割のCarbon使い分け
今回の実測データ(時間 1.27 倍・12 月以降の従量換算コスト 2.55 倍・それぞれの得意領域)を踏まえると、「すべてを Carbon に切り替える」のも「Carbon をまったく使わない」のも最適解ではありません。タスクの性質に応じた 明確な二刀流ルーティング がもっとも賢い結論になります。
タスク別の最適モデル選定マトリクスとA案ハイブリッド術
当ラボで確定させた Argon と Carbon の実戦使い分け基準を以下の表にまとめました。
| 作業シーン・タスクの性質 | 推奨モデル | 選定の根拠(今回の実測より) |
|---|---|---|
| 日常の記事執筆・リライト・定型コード改修・高速デバッグ(全体の約8割) | Gemini 4 Argon | 10 分前後で完走する俊敏さと、過去ログから細かな一次ネタを網羅発掘する高い基礎力を備えつつ、12 月以降も Carbon の約 39%(2.55 分の 1) の低コストで巡航できるため。 |
| 複数システム横断の設計・難解バグの根本治療・重要ハブ記事の構築(全体の約2割) | Gemini 4 Carbon | 初回から全制約を一発で守る構造設計力、カンニングや手抜きフラグに逃げない高い誠実性、読者の疑問を先回りする論理構成力が圧倒的なため(特に 11 月 30 日までの同単価期間 は積極投入が有利)。 |
| 決定版ピラー記事の作成(ここ一番の勝負記事) | Argon × Carbon ハイブリッド | 今回のように Argon で一次情報を徹底発掘させ、Carbon で全体構造・定量グラフ・読者導線を統合(または /swarm で役割分担)させると単独モデルを超える最高品質に到達できるため。 |
なお、ご自身のブログや開発プロジェクトで今回の検証と同じように「既存資産からのハイブリッド統合」や「2 大モデルの比較検証」を行いたい場合は、必ず 『Gemini 4 Argon』または『Gemini 4 Carbon』 を選択したうえで、以下のプロンプトをコピーして使ってみてください。
以下の検証記事URLの内容と使い分け基準を参考に、私のプロジェクト内の既存資料・過去ログを調査したうえで「[ここに作りたいテーマを入力]」の決定版記事(または設計書)を作成してください。
参考URL: https://lab.chihouzakki.com/blog/review/gemini-4-carbon-vs-argon-same-article-ab-test-benchmark/

【進める手順】
1. いきなり本文を書き始めず、まずは関連する既存ファイルや一次データを漏れなく調査すること。
2. 読者が抱く疑問(3つ以上)への先回り回答と、視覚的に比較できる図解・表・定量データを含めた全体構成案を先に提示して私と合意すること。
3. 合意後に一括で作成し、リンク切れや書式崩れがないかセルフレビューしてから報告すること。
まとめ:実測データで賢く2大モデルを使いこなそう
カタログのベンチマークスコアを眺めているだけでは分からない「モデルの性格・速度・コストの真実」も、まったく同じお題で 1 本の成果物を最後まで作らせてみれば驚くほどクリアに見えてきます。
-
速度とコストの実測差 : 同じ記事作成タスクで Argon は
10.28 分(総入力約 199 万トークン・換算約 $1.09)、Carbon は13.03 分(総入力約 300 万トークン・11 月末まで約 $1.40)。12 月 1 日以降は単価 2 倍と探索トークン増の掛け算で 実質約2.55 倍(約 $2.79) の差になる。 -
原稿と画像の個性差 : Argon は過去ログから細部の具体例(血糖値 5 段階表・BUN・ピザ 30 回同時咀嚼)を掘り起こす 「網羅マイニング力」 に優れ、Carbon は 100% 積み上げグラフや折れ線グラフ・日常写真調アイキャッチ・疑問先回り吹出しで読ませる 「構造美と編集力」 に優れる。
-
裏側の誠実性と最強の使い分け : Carbon は先行実験の履歴を見抜いて自らカンニングを拒否し、強制突破フラグに頼らず手作業で逆リンクと台帳を整えるシニア級の誠実性を実証した。日常の 8 割は俊敏で高コスパな『Argon』、設計や勝負記事の 2 割は緻密な『Carbon』(
Ultra 20xなら自在に併用) という二刀流が最適解。
ぜひ冒頭のリンクから Argon の生記事・Carbon の生記事・そして ハイブリッド完成版 の 3 本を実際に開いて、AI の進化と個性の違いを体感してみてくださいね!