AIの架空論文を防ぐ国立国会図書館サーチ・J-STAGE・PubMed API×SQLite裏取り術
-
学術・文献裏取りのローカルSQLite化 : 国立国会図書館サーチ(NDL Search)API、国内学会誌の J-STAGE WebAPI、英語医学論文の NCBI PubMed E-utilities を外部クレート依存ゼロの Pure Rust で統合し、書誌・構造化要旨・DOIを単一ファイル
ndl_search.sqliteに永続キャッシュする仕組みを構築しました。 -
漢字2文字の専門語も逃さない二重FTS5検索 : 従来の
trigram(3文字分割)全文検索ではヒットしなかった「大麦」「血圧」「鉄」などの1〜2文字キーワードを、軽量補助インデックスndl_items_short_ftsの併設によって 1.0〜2.6ミリ秒 で高速抽出します。 -
執筆前コマンド1発で4大一次情報DBを30ミリ秒並列照会 : 法令(
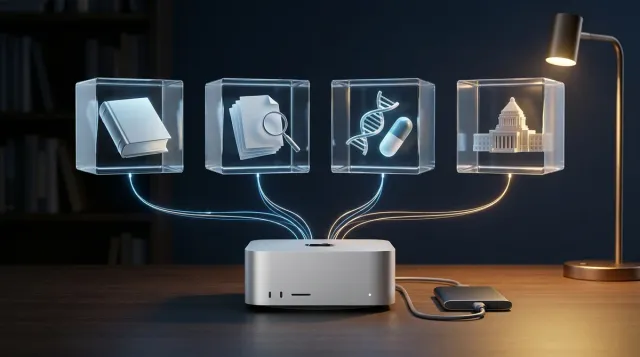
egov_laws.sqlite)・保有PDF蔵書(pdf_library.sqlite)・国会答弁(kokkai.sqlite)・学術文献(ndl_search.sqlite)の4大ローカル一次情報データベースをstd::thread::scopeで同時走査し、ウォームキャッシュ時 全体30.31ミリ秒(DB照会26.0ミリ秒) で裏付け(エビデンス)と旧版・未施行法改正の警告を自動抽出します。
-
MomongaCodeとは?Z3・TLA+形式検証とChatGPT検証150件で防ぐAI開発の死角 : AI任せの開発が15分の試遊で破綻し、GPT-6 Lunaの150件検証でもパーサーをすり抜ける実行時バグが残る原因を解明。Z3と36本のTLA+仕様を備えたOSS「MomongaCode」や6項目の判断ログ、Signal画面監視対策まで解説します。
-
国会会議録APIとe-Gov全法令XMLをSQLite化|26万条文の0.6秒監査術 : 本記事の前作にあたる検証録です。全8,992法令・263,348条文のオフライン検索と国会答弁キャッシュを構築した基盤設計を解説しています。
-
ローカルRAGにベクトルDBは不要?5大SQLite×Rustで個人知識庫を組んだ実測録 : 重厚なベクトルデータベースを使わず、複数の特化型SQLiteとFTS5で高速な知識検索を実現する全体アーキテクチャの記録です。
-
Web検索RAGの法令ハルシネーション4大罠|e-Gov SQLiteで820記事を監査した実測録 : AIがWeb検索経由で陥りやすい条文番号のズレや未施行改正の混同を、ローカル法令DBで一掃した監査手法をまとめています。
-
PDFのダウンロード元URL確認と出典特定の自動化|SQLite管理と医療旧版検知でAI誤引用を防ぐ実証録 : 手元のPDF蔵書1,039冊から拡張属性・DOI・ハッシュ照合で公式出典URLを自動復元し、改訂済みの古い医療ガイドライン等に旧版警告を注入した実証録です。
-
AIエージェント全自動の現実|DoorDash注文数百件・IEEE論文1,400本撤回の衝撃 : AI丸投げブームの裏で起きた国際会議論文1,400本の一斉撤回など、実在するDOIであっても一次原典の検証が不可欠である理由を分析しています。
-
AIの「架空論文・誤ったDOI捏造」に悩む執筆者・研究者の方 : 生成AIに医療・健康・栄養・工学などの根拠論文を探させた際、実在しない論文タイトルや別論文のDOIを混ぜられる事故を根絶したい方。
-
公的APIを規約遵守・安全第一でローカル知識庫へ繋ぎたい開発者の方 : レート制限の排他制御やアンチボット応答時の即時フォールバック、読み取り専用サンドボックスからのミリ秒検索をRustとSQLiteで実装したい方。
-
記事執筆や調査の「事前裏取り」を自動化したい個人開発者の方 : 法令・取扱説明書・国会答弁・学術論文の4領域をコマンド1発で横断照会し、Web検索の待ち時間と手作業の転記ミスをゼロにしたい方。

前回の記事で「e-Govの法律26万条文」と「国会会議録」がローカルSQLiteに入って、法律や制度の裏取りはミリ秒単位で終わるようになりましたよね。でも、健康や栄養、ガジェットの工学的な検証記事を書くときは、法律だけでなく「査読付きの学会論文」や「医学ガイドライン」の裏付けが必要になりませんか?

まさにそこが次なる最大の障壁(ボトルネック)でした。法律と国会答弁がローカルで即座に引けるようになると、最後までWeb検索頼みとして残ったのが「国内の専門図書・学会誌論文・英語の医学論文」だったのです。そこで今回は、国立国会図書館サーチ・J-STAGE・PubMedの3大学術APIをPure Rustで単一SQLiteへ統合し、執筆前の準備コマンド1発で「4大一次情報DB」を30ミリ秒で並列照会する仕組みを完成させました。
なぜ法律と国会答弁だけではAIの嘘を防ぎきれないのか
当ラボでは現在、合計 885記事(うち検証録 448記事)におよぶ記事を公開・保守しています。先日の検証録『国会会議録APIとe-Gov全法令XMLをSQLite化|26万条文の0.6秒監査術』では、デジタル庁のe-Gov法令データ(8,992法令・263,348条文)と 国立国会図書館の国会会議録検索システムAPI をローカルSQLiteへ格納し、条文や大臣答弁の裏取りをミリ秒単位で完結させました。
しかし、日々の暮らしに直結する実機レビューや検証記事を執筆していると、法令や国会答弁だけでは根拠として足りない場面に必ず直面します。
医療や健康の記事で頻発するAIの架空論文捏造
たとえば、登山時の低血糖を防ぐ補食の検証や、大麦(β-グルカン)による食後血糖値の抑制、パルスオキシメーターや家庭用血圧計の測定原理、あるいは半導体・ストレージの熱設計などを解説する場合を考えてみてください。
ここで読者が本当に知りたい裏付け(エビデンス)は、曖昧な一般論ではなく 「どの学術論文や診療ガイドラインの、どの実験データに基づいているのか」 という一次文献です。ところが、大規模言語モデル(LLM)に「このテーマの根拠となる論文とDOIを挙げて」とそのまま指示すると、もっともらしい英語タイトルと実在する学術誌名、そして全く無関係な別論文のDOI(デジタルオブジェクト識別子)やPMID(PubMed固有ID)をつなぎ合わせた「精巧な架空論文」を出力する事故が後を絶ちません。
- AIの記憶や汎用Web検索に頼ると、実在する著者名と別論文のDOIを合成した「架空の論文引用」が混入しやすい。
- 日本語の一般検索ではSEOまとめサイトばかりが上位に出て、原著論文のPDF直結URLや構造化要旨(アブストラクト)に辿り着くまで何分もかかる。
- 同じテーマの関連記事を書くたびに毎回ゼロからWeb検索をやり直すため、通信待ち時間と転記ミスが積み重なる。
- 国立国会図書館サーチ・J-STAGE・PubMedの公式APIから直接取得した確定書誌・DOI・PMID・構造化要旨のみをローカルSQLiteに永続化する。
- 一度取得した文献とクエリ結果はローカルDBに蓄積され、読み取り専用サンドボックス内からも 1.0〜2.6ミリ秒 でオフライン検索できる。
- 執筆前の
prepコマンド1発で「法令・保有PDF・国会答弁・学術文献」の4大DBを約30ミリ秒で同時走査し、旧版警告まで自動提示する。
実在DOIに潜む撤回論文と旧版ガイドラインの罠
しかも、AI時代の論文ファクトチェックには「DOIや論文タイトルが実在してさえいれば安心」と言い切れない、もう一段深い落とし穴が存在します。それが 「後から不正で撤回(Retraction)された論文」 と 「改訂前の古い診療ガイドライン」 の誤引用です。
先日の検証録『AIエージェント全自動の現実|DoorDash注文数百件・IEEE論文1,400本撤回の衝撃』でも詳しく分析した通り、近年は論文捏造工場(ペーパーミル)や生成AIの悪用による粗製乱造が深刻化しており、世界最大級の学術団体であるIEEE(米国電気電子学会)が1日で国際会議論文1,400本を一斉撤回する前代未聞の事態まで起きています。インターネット上のまとめ記事や古い学習データには撤回前の論文情報がそのまま残っているため、AIは撤回済みであることに気づかず「査読付き論文の裏付け(エビデンス)」として引用してしまいます。
同様に医療・健康分野では、論文やPDF資料そのものは本物であっても、数年前に改訂された古い診療ガイドラインの基準値を「現在の標準基準」としてAIが引っ張ってくる事故が頻発します。当ラボでは『PDFのダウンロード元URL確認と出典特定の自動化|SQLite管理と医療旧版検知でAI誤引用を防ぐ実証録』において、保有PDF蔵書1,039冊のうち改訂済みの古い医療・法制度資料56冊へ旧版警告フラグを注入する仕組みを構築しましたが、外部の学術論文や専門図書についても「いつ刊行された誰の文献か」「撤回や改訂がなされていないか」を即座に照合できる一次情報基盤が不可欠でした。
英語医学論文と国内学会誌を束ねる学術DBの壁
さらに厄介なのが、学術情報の検索窓口が分野と言語によってバラバラに分断されている点です。
-
国内の専門図書・博士論文・雑誌記事索引 を網羅しているのは、国立国会図書館の「NDLサーチ」です。
-
日本の学会誌論文や国内の診療ガイドライン(PDF) が集まっているのは、科学技術振興機構(JST)の「J-STAGE」です。
-
世界標準の医学・生物学・栄養学のランダム化比較試験(RCT)やメタ解析 が集積されているのは、米国国立医学図書館(NLM / NCBI)の「PubMed」です。
記事を1本書くたびにこれら3つの異なる検索サイトをブラウザで開き、それぞれ独自のクエリ構文で検索してタイトル・著者名・発行年・DOI・URLをコピー&ペーストするのは、人間にとってもAIエージェントにとっても大きな負担になります。しかも、数千万件規模のデータを持つこれらの巨大データベースは、e-Gov法令XML(全件で約933MB)のように「最初から全データを丸ごとダウンロードして手元のSSDやハードディスクに入れておく」というわけにもいきません。
そこで当ラボでは、「必要なトピックを公式APIから礼儀正しくオンデマンド収集し、一度引いた確定書誌と主要シード文献を単一の ndl_search.sqlite に永続蓄積して、2回目以降はオフライン1ミリ秒で再利用する」 というハイブリッド知識庫を設計しました。
学術3大APIとPMDA導線のPure Rust統合設計
この学術知識庫のエンジンとして新規実装したのが、当ラボの知識検索バイナリ kb-search に組み込んだ src/gov_ndl.rs です。既存の法令・国会モジュールと同様に、重厚な非同期ランタイムや外部XMLパーサークレートには一切依存せず、Pure RustとOS標準の curl、そしてC言語FFI直結のSQLiteのみで3大プロバイダの通信とパースを統合しています。
# 3大プロバイダ(NDL / J-STAGE / PubMed)や媒体種別を指定して1コマンド検索・自動キャッシュ
./scripts/run_kb_search.sh ndl "パルスオキシメーター" --jstage
./scripts/run_kb_search.sh ndl "barley beta-glucan glycemic" --pubmed
./scripts/run_kb_search.sh ndl "医療機器" --author "厚生労働省" --mediatype books
./scripts/run_kb_search.sh ndl "ロキソプロフェン" --pmda
それぞれのAPIが持つ仕様の癖と、Rust側での統合処理の急所を見ていきます。
国立国会図書館サーチのOpenSearchとSRU両対応
1つ目の接続先は、国立国会図書館サーチ『APIのご利用について(外部提供インタフェース)』 で公開されている公的APIです。NDLサーチは2024年のシステム刷新に伴って旧ドメイン(iss.ndl.go.jp)から現行の https://ndlsearch.ndl.go.jp/ へと統合されており、国立国会図書館サーチのAPI仕様書 に準拠して以下の2系統のエンドポイントをクエリ条件に応じて自動で使い分けています。
- OpenSearch エンドポイント(
https://ndlsearch.ndl.go.jp/api/opensearch) : キーワード(any)、タイトル(title)、著者名(creator)、出版者(publisher)、ISBN(isbn)、開始・終了年(from/until)、媒体種別(mediatype:図書books・記事論文articles・デジタルコレクションdigital)をシンプルなクエリパラメータで指定できるRSS 2.0拡張XML形式のインターフェースです(1リクエスト最大500件まで取得可能)。 - SRU(Search/Retrieve via URL)エンドポイント(
https://ndlsearch.ndl.go.jp/api/sru) :operation=searchRetrieveと CQL(Contextual Query Language)検索式(query=title="著作権" AND from="2020"など)を渡すことで、recordSchema=dcndl(DC-NDL XML)による精密な書誌メタデータを取得できる上位インターフェースです。
gov_ndl.rs では、通常のキーワード検索や媒体絞り込みには応答が軽快な OpenSearch を使い、--sru オプションが指定された場合には自動的に DC-NDL スキーマの SRU(CQL検索式)へ切り替える二刀流のルーティングを実装しました。また、返却されるXML内の <dc:identifier xsi:type="dcndl:JPNO">(全国書誌番号)や <dc:identifier xsi:type="dcndl:DOI">、<rdfs:seeAlso> などを正規化し、国立国会図書館の固定書誌URLとDOIを確実に抽出します。
J-STAGEとPubMedからのDOI・要旨一括抽出
2つ目の接続先は、国内の学会誌・論文誌を統括する科学技術振興機構(JST)の J-STAGE WebAPI(利用条件は JST『J-STAGE WebAPI 利用規約』 参照)です。
J-STAGEの検索API(https://api.jstage.jst.go.jp/searchapi/do?service=3)は Atom XML 形式でレスポンスを返します。ここで実務上きわめて重宝するのが、各論文の <prism:doi>(10.xxxx/... 形式のDOI)と並んで、本文PDFへ直結するURLパターンが取得できる点です。たとえば、当ラボの保有PDF蔵書にも収録している低山登山時の血糖値変動に関する論文(『Walking Research』誌)であれば、学会誌コード・巻号・論文IDから直結URLを即座に特定し、一次資料へのインラインリンクとして記事へ埋め込むことができます。
3つ目の接続先は、世界中の医学・生命科学論文を網羅する 米国国立生物工学情報センター(NCBI)『Entrez Programming Utilities Help (NBK25500)』(通称 E-utilities)です。PubMedのAPIは以下の2段階パイプラインで動作します。
-
第1段階(
esearch.fcgi?db=pubmed&retmode=json) : 検索クエリ(term)に合致する論文の PMID(PubMed ID)リストをJSON形式で高速に取得します。 -
第2段階(
efetch.fcgi?db=pubmed&retmode=xml&id=...) : 取得した複数の PMID をカンマ区切りで一括指定し、<PubmedArticle>構造体を含む詳細XMLをまとめて引き出します。
ここで特にこだわったのが、英語医学論文の 「構造化アブストラクト(要旨)」の完全保持 です。医学論文のXMLでは、<AbstractText Label="BACKGROUND"> や <AbstractText Label="OBJECTIVES">、<AbstractText Label="RESULTS"> のように複数の段落タグに分かれて要旨が格納されています。簡易的なパーサーでは最初の1段落だけを読んで残りを捨ててしまいがちですが、gov_ndl.rs ではすべての <AbstractText> タグを走査し、[BACKGROUND/OBJECTIVES] ... [METHODS] ... [RESULTS] ... とラベル付きで結合して全文をSQLiteへ保存します。さらに <ArticleId IdType="doi"> と <ArticleId IdType="pmc">(PubMed Central 無料全文ID)も同時に抜き出すため、抄録だけでなく無料公開されている全文論文への導線も一発で揃います。
規約遵守の物理レート制限とPMDA安全導線
公的機関や学術機関のAPIをプログラムから利用する際、最も厳格に守らなければならないのが 「相手先サーバーへの礼節と利用規約・アクセス制限の絶対遵守」 です。
とりわけAIエージェントを使った開発環境では、複数のサブエージェントや並列タスクが同時にコマンドを呼び出す場面があります。もし各プロセスが勝手にAPIを連打すれば、数秒でレート制限(HTTP 429 Too Many Requests)に抵触し、IPアドレスの遮断や提供元への迷惑につながります。
そこで gov_ndl.rs では、呼び出し元のAIやスクリプトの行儀に頼るのではなく、Rustバイナリの最深部に 「プロセス横断の排他ファイルロック(flock(LOCK_EX))とプロバイダ別最小待機間隔」 を物理的な安全装置として組み込みました。以下の比較表は、統合した3大学術APIとPMDA安全導線の技術仕様およびレート制限設計をまとめたリファレンスです。
| プロバイダ / 対象分野 | エンドポイント・形式 | 主要クエリ引数 | APIキー要否・当ラボのflock待機間隔 |
|---|---|---|---|
| 国立国会図書館サーチ(NDL) 国内の専門図書・雑誌記事索引・博士論文・デジタル化資料 |
OpenSearch(RSS 2.0拡張XML):ndlsearch.ndl.go.jp/api/opensearchSRU(DC-NDL XML): ndlsearch.ndl.go.jp/api/sru |
OpenSearch:any, creator, publisher, from, until, mediatype, cntSRU: operation=searchRetrieve, recordSchema=dcndl, query(CQL検索式) |
APIキー不要(非営利リサーチ)1,500ミリ秒(1.5秒)旧 iss.ndl.go.jp 廃止対応済。1回最大500件上限を守り、連続呼び出し時はプロセス間で1.5秒間隔を強制。 |
| J-STAGE(科学技術振興機構) 国内学会誌論文・会議録・日本語の診療ガイドライン |
WebAPI(Atom XML):api.jstage.jst.go.jp/searchapi/do |
service=3(論文検索), text, author, material(資料名・誌名), pubyearfrom, pubyearto, count |
APIキー不要(非営利リサーチ)1,200ミリ秒(1.2秒)論文メタデータと <prism:doi> 抽出に特化。PDF本体への無差別自動巡回は一切行わない設計。 |
| NCBI PubMed(米国国立医学図書館) 英語医学・生命科学・栄養学論文(RCT・メタ解析) |
esearch(JSONでPMID取得):.../entrez/eutils/esearch.fcgiefetch(詳細XMLで要旨取得): .../entrez/eutils/efetch.fcgi |
db=pubmed, term([Author] / [Journal] 結合), retmode=json/xml, datetype=pdat, mindate, maxdate, retmax, tool |
APIキー不要(秒間3回まで無料)600ミリ秒(0.6秒)NCBI公式のAPIキーなし上限(秒間3回=333ms間隔)より約2倍余裕を持たせた600ms間隔+ tool パラメータ明記。 |
| PMDA(医薬品医療機器総合機構) 医療用医薬品の添付文書・医療機器認証・安全性情報 |
公式検索URL導線生成(--pmda):pmda.go.jp/PmdaSearch/iyakuSearch/ |
一般名称・販売名・薬効分類等からの公式検索画面および厚労省医療機器認証情報への直結案内 | APIキー不要・通信ゼロ(スクレイピング禁止) 添付文書・医療機器DBへの機械的スクレイピングを行わず、公式検索画面への直結URLと検索手順を案内。 |
-
公開サービス組み込み時の事前申請とサーバキャッシュ制限 : NDLサーチ『APIのご利用について』 および JST『J-STAGE WebAPI 利用規約』(第2条・第3条第5項)では、非営利目的の利用申請は不要である一方、広告収益等を伴う営利目的のWebサイト・アプリ(利用者運営サービス)にAPI提供データを組み込んで表示・提供する場合には事前申請が必要と定められています(またJ-STAGEでは利用者運営サービス用の公開サーバやクラウド等への24時間以上の機械可読キャッシュが禁止されています)。
-
手元端末での文献所在特定と原典からの正当な引用 : 本記事のローカルSQLite基盤は、公開Webサイトの裏側でAPI応答データを第三者へ再配信するものではなく、執筆者が手元のローカル端末で実在論文・専門図書の所在(DOI・URL)を特定するための個人用リサーチ索引です。記事本文で数値や知見を紹介する際は、必ず特定した一次原典(公開PDFや書籍)そのものを直接確認し、著作権法第32条の引用要件を満たして記述してください。
さらに、万が一ネットワーク側で HTTP 401 / 403 / 429 などのステータスコードやアンチボット応答(Cloudflare Turnstile や CAPTCHA 等)が返された場合には、ヘッダー偽装やリトライ連打などの回避試行を一切行わず、その場で即座に外部通信を中断して手元のローカルSQLite(--offline 相当)へフォールバックする 厳格なフェイルセーフを徹底しています。
また、医療用医薬品や医療機器の添付文書を管轄する 独立行政法人 医薬品医療機器総合機構(PMDA)『医療用医薬品 情報検索』 については、一般向けのバルク検索WebAPIが提供されていないため、HTMLスクレイピングで無理やりデータを吸い上げるような手法は一切採らず、--pmda オプション指定時にPMDA公式検索ページおよび厚生労働省の医療機器認証情報への正確な参照導線を出力する安全設計としました。
短語検索も漏らさぬ二重FTS5と単一ファイル確定術
3大学術APIから取得した貴重な書誌データは、ローカルの _local_db/ndl_search.sqlite に格納されます。しかし、単にSQLiteのテーブルへ INSERT しただけでは、実戦の執筆フローで使い物にならない2つの技術的課題が浮上しました。
1つは 「漢字1〜2文字の重要キーワードが trigram 全文検索でヒットしない問題」、もう1つは 「AIエージェントの読み取り専用サンドボックス環境でSQLiteのWAL(Write-Ahead Logging)ロックが衝突する問題」 です。
漢字2文字の専門語を拾う二重全文検索インデックス
日本語のテキストをSQLiteの標準機能だけで高速に全文検索する場合、形態素解析器(MeCabなど)を外付けせずに済む FTS5 の trigram トークナイザ(3文字ずつのN-gram分割)が非常に便利です。「パルスオキシメーター」や「ランダム化比較試験」といった3文字以上の語句であれば、これだけでミリ秒単位の部分一致検索が機能します。
ところが、医療・栄養・工学の現場では 「大麦」「血圧」「鉄」「亜鉛」「睡眠」「銅」「熱」 といった1〜2文字の漢字・英数字キーワードが頻繁に登場します。3文字単位でインデックスを作る trigram では、2文字以下のクエリを投げるとインデックスが効かず、検索結果がゼロ件になるか全件走査(フルスキャン)に落ちてしまうのです。
この弱点を解消するため、ndl_search.sqlite(および kokkai.sqlite・pdf_library.sqlite)では、以下の 「二重FTS5(Dual-FTS5)アーキテクチャ」 を実装しました。
-- 1. 3文字以上の部分一致をミリ秒で捌くメインの trigram FTS5
CREATE VIRTUAL TABLE IF NOT EXISTS ndl_items_fts USING fts5(
    title,
    authors,
    venue,
    identifiers,
    abstract_text,
    tokenize='trigram'
);

-- 2. 「大麦」「血圧」「鉄」等の1〜2文字語を取りこぼさない軽量 ascii FTS5
CREATE VIRTUAL TABLE IF NOT EXISTS ndl_items_short_fts USING fts5(
    tok,
    content='',
    contentless_delete=1,
    detail='none',
    tokenize='ascii'
);仕組みはシンプルかつ強力です。文献データを登録・更新する際、Rust側のトークン抽出関数(extract_short_fts_tokens)がタイトルや要旨から「2文字の連続する漢字・カタカナ・英数字」および「1文字の重要漢字」を抽出し、content='' かつ detail='none'(本文や位置情報を重複保存しない極小省容量モード)の ndl_items_short_fts に登録します。
検索実行時にクエリ語が3文字以上であればメインの ndl_items_fts(trigram)を引き、1〜2文字の短語が含まれていれば即座に ndl_items_short_fts(ascii)を並列参照して rowid を結合します。この二重化により、「大麦」や「血圧」といった2文字の検索語でも、取りこぼしゼロかつ1ミリ秒台でのピンポイント抽出が可能になりました。
サンドボックスでも1ミリ秒で引けるWAL切り詰め
もう1つの急所が、SQLiteのジャーナルモード設計です。通常、SQLiteで読み書きの並行性を高めるには PRAGMA journal_mode = WAL; を設定します。しかし、WALモードのデータベースは本体ファイルの横に -wal と -shm(共有メモリ)という一時ファイルを生成する仕様になっており、たとえ SELECT(読み取り)であっても、開くプロセス側に対象ディレクトリへの書き込み権限がないとエラーやロック競合を起こす場合があります。
当ラボでは、AIエージェントが暴走してシステムを壊さないよう、日常の検索コマンドを厳格なサンドボックス環境で実行しています。そのため、データベースが -wal ファイルを残した状態のままだと、読み取り専用接続(SQLITE_OPEN_READ_ONLY)や別プロセスからの同時アクセス時に最大の障壁(ボトルネック)となり得ます。
そこで gov_ndl.rs および gov_kokkai.rs では、APIからのデータ取得・キャッシュ書き込みが完了した瞬間に、必ず以下のトランザクション終端処理を実行して 「完全に自己完結した単一 .sqlite ファイル」 へと確定させています。
-- 書き込み完了時にWALを本体へ完全統合し、単一ファイル(DELETEモード)へ確定させる
PRAGMA wal_checkpoint(TRUNCATE);
PRAGMA journal_mode = DELETE;
そして、検索のみを行うオフライン照会時や執筆前の prep コマンド実行時には、最初から DbConn::open_readonly(path)(SQLITE_OPEN_READ_ONLY | SQLITE_OPEN_NO_MUTEX)で開く設計としました。これにより、一切のロックファイルや一時ファイルを生成することなく、何個のスレッドから同時アクセスしても競合ゼロで読み出せます。
本文リンクとYAML出典行の自動生成による転記ミス根絶
さらに、執筆現場での「うっかりミス」を物理的に防ぐ工夫として、kb-search ndl の検索結果出力には、ヒットした文献ごとの書誌情報だけでなく 「そのまま記事本文に貼れるMarkdownインラインリンク」 と 「フロントマターの references: にそのまま貼れるダブルクォート付きYAML行」 を自動整形して表示する機能を持たせました。
-
初期シード文献50件の永続化 : 導入初日からオフラインでも即座に主要文献が引けるよう、当ラボの記事群で頻出する10大トピックについて 合計50件(NDL図書・書誌 10件 / J-STAGE国内学会論文 24件 / PubMed英語医学論文 16件、ファイルサイズ約356KB) を事前シード済みです。また、
kokkai.sqlite側にも二重FTS5と12政策テーマ・111発言(4.00MB)を初期シードしています。 -
YAMLコロン誤認を防ぐ自動クォート出力 : PubMedの英語論文タイトルには
Comparison of low- and high-carbohydrate diets: a randomized trial.のように半角コロン+スペース(:)が頻出します。これをフロントマターのYAMLにそのまま貼ると構文エラーになるため、ツール側で最初から"..."で安全にエスケープしたreferences用スニペットを出力します。 -
7日間のクエリキャッシュ(
ndl_query_cache) : 同じ検索語・同じフィルタ条件でのAPI呼び出しは7日間ローカルキャッシュから即座に返却されるため、執筆中に何度もコマンドを叩いても外部APIへの通信は一切発生しません。
実際にローカルキャッシュ済みの ndl_search.sqlite に対してオフライン検索を実行すると、PubMedの英語論文(「大麦β-グルカン」関連)は 1.0〜1.2ミリ秒、NDLやJ-STAGEの日本語文献(「パルスオキシメーター」「血圧」「著作権」など)も 2.1〜2.6ミリ秒 という驚異的な速度で構造化要旨とDOIが返ってきます。
執筆前コマンド1発で4大一次情報DBを並列照会する
個別の検索コマンド(kb-search law / pdf / kokkai / ndl)がどれほど速くなっても、人間やAIが「面倒だから」と実行をサボってしまえばハルシネーション防止にはなりません。人間やAIの注意力に頼らず裏取りを100%強制する唯一の方法は、「記事を書き始める前の準備コマンド1発の中に、4大一次情報データベースの横断照会を最初から組み込んでしまうこと」 です。
当ラボでは、新規記事の作成や既存記事のリライト、Search Console改善、過去対話からの記事起こしを行う際、必ず最初に ./scripts/run_kb_search.sh prep コマンドを実行して「執筆用オールインワン・バンドル(カルテ)」を生成する状態機械ワークフローを運用しています。今回、この src/workflow_prep.rs を全面改修し、全5モード(prep new / convo / draft / gsc / edit)すべてで 4大ローカル一次情報DBの同時並列照会 が自動発動するようにしました。
記事テーマや対象スラッグから重要キーワードを自動抽出し、「薬機法」「36協定」「車検」「独禁法」などの日常略称を正式法令名や条文番号へと自動展開します。
std::thread::scope で4本のワーカースレッドを立ち上げ、egov_laws・pdf_library・kokkai・ndl_search を独立 Read-Only 接続で同時照会します。
抽出された条文・ガイドライン・国会答弁・学術論文をバンドルへ一括出力します。古い年次のPDFや未施行法改正には注意ラベルを付与し、最新改訂版のみ外部検索でピンポイント補完します。
法令・PDF・国会・学術を束ねる3.3GB知識基盤
現在、当ラボのローカル環境(_local_db/)では、記事インデックス等を含む5大SQLite群(総容量 3,389.75 MB)が稼働しており、そのうち以下の4つが「一次情報の裏取り(ファクトチェック)用4大データベース」として prep コマンドに直結されています。
| 一次情報DBファイル名 | 容量・収録スケール | 収録されている一次情報の中身 | prep 照会時のインテリジェント機能 |
|---|---|---|---|
egov_laws.sqlite |
933.40 MB (8,992法令・263,348条文) |
デジタル庁 e-Gov 全法令一括XMLから構築した国内現行法令・全条文フルテキスト | 略称エイリアス展開・条文番号逆引き(第36条 等)・未施行改正(upcoming_revisions)警告・公開時の廃止ID自動検問 |
pdf_library.sqlite |
300.18 MB (保有取扱説明書・医学書・公的資料) |
Apple Vision OCR等で全ページ文字起こし済みの取扱説明書・診療ガイドライン・白書PDF | 2文字語解禁(二重FTS5)・公式PDF直結URL提示・旧版ガイドラインヒット時の ⚠️旧版注意 自動警告 |
kokkai.sqlite |
4.00 MB (主要政策テーマ・累積キャッシュ) |
国立国会図書館 国会会議録検索システムAPIから取得した本会議・委員会の大臣・政府参考人答弁 | 二重FTS5検索・発言者肩書きと会議日付・公式発言URLの自動抽出 |
ndl_search.sqlite |
0.35 MB (初期50文献+執筆時自動蓄積) |
NDLサーチ・J-STAGE・PubMedから取得した専門図書・国内学会誌論文・英語医学論文の書誌と要旨 | 二重FTS5検索・DOI / PMID / PDF直URLの抽出・references 用YAMLスニペット出力 |
この4大DBが揃ったことで、どのようなジャンルの記事であっても「法律の根拠条文」「メーカー取扱説明書や省庁ガイドラインの該当ページ」「国会での政府公式見解」「査読付き学術論文のDOIと実験要旨」の4点セットが、手元のマシン内部だけで瞬時に揃うようになりました。
スレッド独立Read-Only接続とmmap最適化
合計1.2GBを超える4つのSQLiteデータベースを毎回照会するとなると、「準備コマンドの実行だけで何秒も待たされるのではないか?」と懸念されるかもしれません。もしシングルスレッドで1つずつ直列にデータベースを開き、重いクエリを順番に流していれば、確かに大きな遅延が発生します。
この遅延を極限まで削ぎ落とすため、workflow_prep.rs の並列照会エンジン(gather_local_evidence_parallel)では、Rustの低レイヤー制御ならではの3つの高速化技法を投入しました。
-
std::thread::scopeによる4スレッド完全並列走査 : Rustの生ポインタを持つSQLite FFI接続構造体(DbConn)は、スレッド安全性を保証するため意図的に!Sendかつ!Sync(スレッド間での移動・共有禁止)として設計しています。そこで、親スレッドで開いた接続を使い回すのではなく、std::thread::scope内で立ち上げた4本のスレッド(laws/pdf/kokkai/ndl)がそれぞれ自身のスレッド内部でDbConn::open_readonlyを呼び出し、OSカーネルレベルでロック競合を起こさずに4つのDBファイルを同時並行で読み出します。 -
DBサイズに応じた
PRAGMA mmap_sizeの最適割り当て : ファイルサイズが933MBあるegov_laws.sqliteと300MBあるpdf_library.sqliteにはmmap_size = 536870912(512MB)を、軽量なkokkai.sqliteとndl_search.sqliteには134217728(128MB)のメモリマップドI/Oを割り当てています。これにより、2回目以降のウォームキャッシュ時はシステムコールのread()すら経由せず、ユニファイドメモリ上の仮想アドレス空間からゼロコピーでB-Treeインデックスを走査します。 -
プリペアドステートメントのループ外1回コンパイル(
prepare&st.reset()) : 抽出された複数の照合キーワード(最大12語)でFTS5を検索する際、ループの中で毎回SQL文をprepareするのではなく、ループの外で1回だけプリペアドステートメントをコンパイルし、ループ内ではst.reset()とst.bind_text()のみを繰り返すことでSQLパーサーのオーバーヘッドを排除しました。
薬機法や旧版ガイドラインを30ミリ秒で炙り出す実測値
では、この並列アーキテクチャによって実際の処理時間は何ミリ秒になったのか、実機でのベンチマーク測定結果を見てみましょう。
たとえば、医療機器であるパルスオキシメーターや家庭用血圧計のレビュー記事を想定し、./scripts/run_kb_search.sh prep new "パルスオキシメーター 医療機器 薬機法 血圧" --bundle を実行した際の実測値は以下の通りです。
-
ウォームキャッシュ時の総実行時間 : 全体
30.31ミリ秒(うち4大一次情報DBの並列照会フェーズはわずか26.0ミリ秒)。人間がEnterキーを押した瞬間に、全8セクションを含むオールインワン執筆バンドルの書き出しまでが完了します。 -
日常略称エイリアス指定時(
36協定 残業 労働基準法) : 全体33.2ミリ秒で完了。「36協定」という通称から自動的に労働基準法第36条を逆引きして条文テキストを抽出しつつ、国会での働き方改革関連答弁やJ-STAGEの労働衛生論文を同時取得します(なお、933MBのegov_laws.sqliteをOS起動後に初めてディスクから読み込むコールドキャッシュ時でも2,350.8ミリ秒で完走します)。 -
法令DB(
egov_laws.sqlite)からの自動抽出結果 : 略称「薬機法」を正式名称 『医薬品、医療機器等の品質、有効性及び安全性の確保等に関する法律』(昭和三十五年法律第百四十五号)へ自動展開し、第二条(医療機器の定義)の条文と 「⚠️未施行改正情報あり(2027-04-01 / 2028-05-21)」 の注意喚起を抽出します。 -
保有PDF蔵書(
pdf_library.sqlite)からの自動抽出結果 : 保有PDF内の 『高血圧治療ガイドライン』 やパルスオキシメーター取扱説明書(型番SAT-2100等)を抽出し、同時に2020年・2022年・2023年刊行の古い資料に対しては⚠️旧版の可能性:最新改訂版も要確認というアラートを自動付与します。 -
国会答弁(
kokkai.sqlite)と学術文献(ndl_search.sqlite)からの自動抽出結果 : 参議院厚生労働委員会等におけるパルスオキシメーターの医療機器認証に関する政府参考人答弁、J-STAGEの 『パルスオキシメータの原理と測定上の注意点』、およびPubMedの家庭用血圧測定(Home Blood Pressure Monitoring)に関するランダム化比較試験(RCT)論文の要旨とDOIを一括抽出します。
ここで極めて重要なのが、「ローカルDBは閉鎖的な完璧主義のためにあるのではなく、執筆前の最初の30ミリ秒で『確実な土台』と『調べるべき差分』を確定させるためにある」 という設計思想です。
たとえば、手元の pdf_library.sqlite に収録されているガイドラインが数年前の版だった場合、prep バンドルが自動的に ⚠️旧版の可能性:最新改訂版も要確認 と警告を出してくれます。執筆するAI(および監査する人間)は、その警告を見て「基礎的な測定原理は手元の取扱説明書PDFとJ-STAGE論文で確定させ、最新の診断基準値だけは最新の改訂版ガイドラインを外部検索でピンポイント確認しよう」と判断できます。
また、学術論文を記事の主たる根拠として採用する際も、この「ローカルDBでの刊行年・DOI確定」と「原典ステータスの最新確認」を組み合わせる2段防壁が威力を発揮します。具体的には、まずローカルの ndl_search.sqlite と pdf_library.sqlite で対象論文のDOI・PMID・刊行年および旧版アラートの有無を30ミリ秒で特定し、架空論文を100%排除します。
その上で、重要な医療・工学の裏付け(エビデンス)として本文へ引用する文献については、PubMed の efetch 詳細XMLに含まれる <PublicationType> タグ(撤回済み論文に付与される Retracted Publication や撤回告知 Retraction of Publication 等の属性)や <CommentsCorrections RefType="RetractionIn">、あるいは J-STAGE・学会公式サイト上の正誤表・最新改訂版の有無を最終確認します。実在性の確認をローカルSQLiteで瞬時に終わらせられるからこそ、人間とAIは「撤回や改訂がないか」という本当に重要な品質監査に時間を割けるようになるのです。
さらに記事を書き上げた後の公開フェーズ(run_gemini_gate.sh finish / publish)では、本文中に引用された e-Gov 法令URLや法令名が egov_laws.sqlite とミリ秒単位で自動突合され、廃止された旧法令IDや未施行改正の注記漏れがあればデプロイ前に機械的にブロックされます。「執筆前の30ミリ秒並列照会」と「公開前のミリ秒機械検問」で前後を挟み撃ちにすることで、Web検索の待ち時間とハルシネーションの双方を極小化できるのです。
手元で4大SQLiteを高速運用する母艦とAIプロンプト
最後に、読者の皆さまご自身のローカル開発環境や執筆環境において、この「複数SQLiteによる一次情報キャッシュ&並列照会基盤」を再現するためのハードウェア構成の勘所と、そのままコピーして使えるAI構築プロンプトを共有します。
数GBの知識DBをメモリマップ走査する母艦とSSD
当ラボのように、933MBの法令DBや300MB超のOCR済みPDF蔵書DB、さらに記事インデックスや学術キャッシュなど合計3.3GB超のSQLite群を PRAGMA mmap_size でメモリマップし、4スレッド並列で20〜30ミリ秒で走査しようとすると、マシンの 「ユニファイドメモリ容量」 と 「ストレージのランダムリード性能」 が体感速度に直結します。
メインメモリに余裕がある環境では、OSのページキャッシュとSQLiteの mmap 領域に数GBのデータベースインデックスが常駐するため、SSDやハードディスクへの物理I/Oがほぼゼロになり、毎回30ミリ秒での並列照会が維持されます。当ラボで母艦として使用している大容量ユニファイドメモリ搭載の Mac mini や、肥大化する過去対話履歴・PDF原本・SQLiteバックアップを高速に退避・読み出しするための外付けNVMe SSDは以下の構成です。
もちろん、これから新しく学術キャッシュ(ndl_search.sqlite)や国会会議録キャッシュ(kokkai.sqlite)だけを始めるのであれば、初期データベース容量はわずか数MB〜数十MBですので、一般的なノートPCや既存のMac環境でも十分軽快に動作します。
事前調査から段階構築させるコピペ用AIプロンプト
ご自身の専門分野(医療・法律・工学・歴史・ガジェットなど)に合わせて、国立国会図書館サーチ・J-STAGE・PubMedなどの公的API連携とSQLiteキャッシュ基盤をAIコーディングエージェントに構築させるためのプロンプトを用意しました。
-
最上位の推論・コーディングモデルを指定してください : 複数APIのXMLパース、排他ファイルロック(
flock)、二重FTS5スキーマ、そしてスレッド安全な並列照会をバグなく実装させるため、必ずGemini 4 CarbonやGemini 4 Argon(またはClaude 5.5/GPT-6.2クラス)などの最上位推論モデルを選択して実行してください。軽量な高速モデル(Flash系など)ではレート制限やWALトランザクション終端処理が省略される恐れがあります。 -
いきなりコードを書かせず「事前調査レポート」から始めます : 以下のプロンプトは、本記事のアーキテクチャを参照した上で、まずあなたの手元環境(OS・言語ツールチェーン・既存DBの有無)を調査して設計案を提示し、合意してから段階的に実装するように安全ロックをかけています。
あなたは熟練したシステムアーキテクト兼リサーチ基盤エンジニアです。
以下の検証記事で公開されている「国立国会図書館サーチ(NDL Search API)・J-STAGE WebAPI・NCBI PubMed E-utilities の単一SQLiteキャッシュ化と、複数一次情報DBの並列照会アーキテクチャ」を参考に、私の手元環境に特化した一次情報ファクトチェック基盤を構築したいと考えています。

参照記事URL:
https://lab.chihouzakki.com/blog/review/ndl-search-jstage-pubmed-api-sqlite-4db-factcheck-guide/

【重要:いきなりコードの実装やファイルの作成を始めないでください】
まずは私の手元環境を安全に確認し、最適な設計プランを合意するための「ステップ1:事前調査と要件ヒアリング」のみを実行してください。

■ ステップ1であなた(AI)に実行してほしいこと:
1. 現在のワークスペースのOS環境、利用可能な言語ツールチェーン(Rust / Python / Node.js 等)、および `sqlite3`(FTS5拡張の有効有無)や `curl` の状態を非破壊コマンドで確認してください。
2. ワークスペース内に既存のSQLiteデータベースや知識管理スクリプトが存在するか確認してください。
3. 以下の5つの設計原則を満たす「ローカル一次情報DB構築プラン(案)」を日本語で分かりやすく提示し、私が主に扱いたいテーマ領域(例:医療・栄養、IT・工学、法律・経済など)について質問してください。
   - 原則①:各APIの利用規約とサーバー負荷を厳守するため、プロセス横断の排他ロックとプロバイダ別最小待機間隔(NDL 1.5秒、J-STAGE 1.2秒、PubMed 0.6秒以上)を強制し、HTTP 401/403/429 やアンチボット応答時は回避試行を一切行わず即座に通信を中断してローカルDBへフォールバックすること。
   - 原則②:3文字以上の部分一致を担う `trigram` FTS5 と、漢字1〜2文字の重要専門語(「血圧」「大麦」「鉄」等)を拾う軽量補助 FTS5 の二重インデックス構成とすること。
   - 原則③:書き込み完了時に `PRAGMA wal_checkpoint(TRUNCATE); PRAGMA journal_mode = DELETE;` で単一ファイルへ確定させ、検索時は Read-Only 接続でロック競合ゼロ・数ミリ秒で照会できるようにすること。
   - 原則④:検索結果には、根拠の一次URL・DOIとともに、記事やレポートへそのまま転記ミスなく貼れるMarkdownリンクと出典リスト形式を自動出力すること。
   - 原則⑤:ローカルDBのヒット結果に古い年次の資料が含まれる場合は「最新改訂版も要確認」の注意喚起を表示し、ローカル確定と外部最新補完の2段構えでハルシネーションを防ぐこと。

私の回答と承認を得てから、ステップ2(スキーマ作成と単体API取得テスト)へ進んでください。
まとめ:一次情報のローカル確定がAI時代の信頼を守る
生成AIがどれほど流暢な文章を数秒で紡ぎ出せるようになっても、「その記述は実在する法令、公的統計、あるいは査読付き論文のどこに根拠があるのか?」という一次情報の裏付け(エビデンス)だけは、確率計算で捏造することが許されません。
法律の条文(e-Gov)、手元の取扱説明書やガイドライン(保有PDF)、国会の公式答弁(国会会議録API)、そして専門図書や国内外の査読付き論文(NDL・J-STAGE・PubMed)という4つの一次情報が、記事を書く前のコマンド1発・わずか30ミリ秒で手元に揃うのは圧倒的な安心感ですね!
はい。「AIがもっともらしい嘘をつくかもしれない」と怯えながら毎回手作業で検索サイトを巡回するのではなく、公式APIから礼儀正しく取得した確定書誌を単一SQLiteに蓄え、二重FTS5と並列Read-Only接続でミリ秒単位で引き出す。そして古い年次の資料や未施行の法改正には自動で警告灯を点ける。この地道なローカル知識庫の積み重ねこそが、AI時代における最も確実な情報の品質保証になると確信しています。
今回の仕組みのポイントを改めて振り返ります。
-
3大学術APIとPMDA安全導線の統合 : 国立国会図書館サーチ(OpenSearch / SRU)・J-STAGE・PubMedをPure Rustで統合し、プロセス横断の
flock排他レート制限とアンチボット尊重フォールバックを守りながら、構造化要旨とDOIをndl_search.sqliteに永続キャッシュしました。 -
二重FTS5とWAL切り詰めによる1ミリ秒検索 :
trigramと短語用asciiインデックスの二刀流で「大麦」「血圧」などの2文字語も漏らさず拾い、保存時の単一ファイル確定(journal_mode = DELETE)によってサンドボックス内からも 1.0〜2.6ミリ秒 で安全に照会できます。 -
4大一次情報DBの30ミリ秒並列照会 : 執筆前の
prepコマンド1発でegov_laws・pdf_library・kokkai・ndl_searchを4スレッド同時走査し、ウォームキャッシュ時 全体30.31ミリ秒 で確実な一次根拠と旧版・未施行改正アラートを揃える体制が完成しました。
AIを使った執筆やリサーチで「出典の裏取りに時間がかかる」「架空の論文引用が怖い」と感じている方は、ぜひ手元の小さなSQLiteキャッシュから一次情報のローカル知識庫を育ててみてください。