AIサブエージェント並列分担と親コンテキスト節約術|84記事改修でUltra週間枠2%消費の実測録
AI エディタ(VS Code の Antigravity 拡張機能や Antigravity IDE など)で、サイト全体の記事監査や数十ファイルにまたがる一括改修を頼んだとき、「1 回の大型作業だけで週間利用枠(Weekly Limit:クォータ)が 15〜 20% もゴッソリ溶けた」「後半になるほど AI の記憶がパンパンになって前の記事と内容が混ざる」 と悩んだことはありませんか?
そこで今回、最上位推論モデルである Gemini 4 Argon (High) だけを使い、当サイトの大型企画(全 18 分野の公開記事すべてに対する敵対的ペルソナ監査 → 未作成だった監査書 28 本の新設 → 1.3 万字の新規マスター記事執筆+アイキャッチ生成 → 公開記事 84 ファイルと共通定数・ルール群の横断改修 → 本番サーバー転送&ブラウザ実機検証)という超大型ジョブを 1 時間 13 分ノンストップで走らせ、実行前後のクォータ残量と生ログ(transcript.jsonl)のトークン内訳を完全実測しました。
2%(67% → 65%) で済みました。その決定的な勝因は、1 人の親 AI に全記事を丸読みさせず 「① 6 班サブエージェント並列による親コンテキスト肥大化の遮断」「② ローカル SQLite 行番号特定と決定論 CLI への定型処理オフロード」「③ プロンプトキャッシュ再利用率 79.7%」 を組み合わせたことにあります。 -
Gemini 4 Argon・3.1 Pro・3.8 Flash実測比較|1,380会話の手戻りとトークン差 : 軽量モデルの浅い思考が手戻り地獄を招き、最初から最上位の Argon 一本に絞る方が枠も時間も節約できることを 1,380 会話の生ログで証明した前編です。
-
Google AI週間クォータ消費を半減!SQLite×RAMDiskで500記事運用を高速化した記録 : 今回の省燃費の土台となっているローカル SQLite 索引(行番号直結)と 16GB RAMDisk 多層キャッシュの構築記録です。
-
Google AI Ultra 20xからProへ下げて大丈夫?週間残量68%の算数と0.3秒監査術 : Ultra 20x と 5x・Pro の実質利用枠の倍率差と、定型チェックを Node.js スクリプトへ切り出す基本設計を解説しています。
-
【AI取扱説明書⑰】『巨大AIじゃなきゃ無理』は本当か?30倍小さいAIで同点を出した『作業分割』とメモリ無劣化圧縮・隠し命令防御の科学 : 仕事を適切に分解(タスク分割)するだけで推論精度が跳ね上がり計算負荷が激減する最新研究の解説です。
-
【AIルール設計の壁突破】なぜGEMINI.mdを長く書くとAIが記憶喪失になるのか?『24KB切り捨て・2万トークン予算』と3層自動分割の実装録 : 毎ターンのシステムプロンプトを 2 万トークン予算内に収めてキャッシュ効率を最大化するルール分割術です。
-
タダ乗りと性善説悪用を封じる『6大敵対層・完全防壁』 ―― 義務なき権利要求を0秒無力化する統治コード : 今回の「全記事監査+ 84 記事改修(週間枠 2% 消費)」の実証テストで実際に生み出された 1.3 万字の統合マスター記事(本編)です。
-
【自腹課金レビュー】Google AI ProとUltra(5x・20x)の選び方!週間制限の壁とChatGPT・Claude徹底比較 : Google AI Plus・Pro・Ultra(5x/20x)の違いと、最上位Gemini 4 Argonを使うなら実質Ultraが標準となる理由を解説。
-
SQLiteはなぜMySQLより速い?WAL・FTS5とNode.jsで500記事探索をミリ秒化した実装録 : 1ファイルで動くSQLiteがMySQLより速い理由(通信ゼロ・35%高速・WAL)と実用上限の目安を解説。本番のAstro静的HTMLは維持したまま、Node.js標準SQLiteとFTS5で500記事のAI探索をミリ秒化した設計を公開します。
-
数十〜数百本のブログ記事やソースコードを一括で監査・リライトさせた際、クラウド AI の週間利用枠(クォータ)が急減して困っている方
-
サブエージェント(子 AI の並列呼び出し) を使うと「逆にトークン消費が増えるのではないか?」「ファイルの同時編集で壊れないか?」と疑問をお持ちの方
-
Antigravity(VS Code 拡張機能/IDE)の
Models & Usage画面で正確なクォータ消費率を計測するコツ や、そのまま使える並列監査プロンプトを知りたい方

今回は「AI 国家構想の全公開記事を、性善説を悪用する 6 種類の敵対ペルソナ目線で総点検して、反論できないように全記事まとめて対策を織り込んで!」っていう、人間なら数ヶ月かかる無茶ぶりを投げたんよ。正直、週間クォータが 15% か 20% くらい吹っ飛ぶのを覚悟して開始前にスクショを撮っておいたんじゃけど……。

ところが蓋を開けてみたら、84 ファイルもの改修と 1.3 万字の新規記事作成、さらに本番デプロイとブラウザ実機テストまで一発で完走したのに、減った週間枠は たったの 2% でしたね!まずは論より証拠、監査前後の実測スクリーンショットと裏側の生ログ集計データから見ていきましょう。
実測証拠!84記事改修で週間枠わずか2%消費
監査前後スクリーンショットと生ログ集計値
今回の検証は、2026 年 11 月 2 日 00 時 38 分に依頼を送信し、01 時 51 分に本番環境の Playwright 実機検証まで完了した 所要 1 時間 13 分(73 分) の実戦ジョブです。妥協のない品質を担保するため、親エージェントもサブエージェントも軽量な Flash モデル等は一切使わず、すべて最上位の Gemini 4 Argon (High) に統一しています。
まずは監査開始直後(00:39)と、監査完了後に更新ボタンを押して確定させた画面(08:37)の比較をご覧ください。
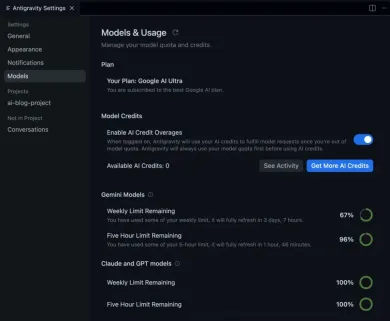
▲ 監査前(00:39 時点):週間枠残量 67%(全回復まで 3 日 7 時間)/ 5 時間枠 96%
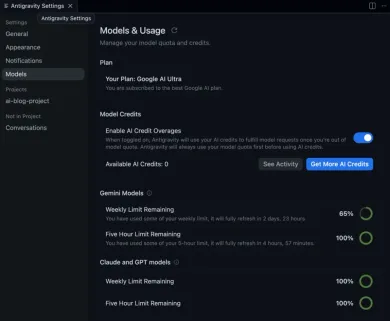
▲ 監査後(08:37 更新確定):週間枠残量 65%(全回復まで 2 日 23 時間)/ 消費わずか 2%!
表示されている整数パーセントの差分は 67% → 65%(わずか 2% 消費) です。もちろん画面上は整数丸め表示のため、内部の小数点境界(例:67.4% → 64.6% や 66.6% → 65.4%)まで厳密に考慮すれば実質 約 1.1% 〜 2.9%(中央値 2.0%) の幅があり得ますが、たとえ上限側の約 2.9% と見積もっても驚くべき低消費です。
この「週間枠約 2%」の裏側で実際にどれだけの仕事とトークン処理が回っていたのか、手元の /brain に記録された親スレッドと全サブエージェント 7 体の生ログ(transcript.jsonl)を 1 トークン単位で合算した結果が以下の表です。
| 実行ユニット(すべて Argon High) | ステップ数 | モデル呼出回数 | 新規入力 (input) | キャッシュ読込 (cache_read) | 出力 (output:思考+原稿) |
|---|---|---|---|---|---|
| 親エージェント(統括・執筆・84記事編集・検証) | 664 | 115 回 | 2,294,884 | 13,515,408 | 226,317 |
| 第1班サブエージェント(00〜01部 監査) | 109 | 15 回 | 593,934 | 1,606,747 | 35,306 |
| 第2班サブエージェント(02〜04部 監査) | 103 | 20 回 | 467,851 | 1,460,587 | 42,291 |
| 第3班サブエージェント(05・08・09部 監査) | 82 | 13 回 | 566,584 | 864,021 | 34,756 |
| 第4班サブエージェント(06部技術編 監査) | 91 | 12 回 | 586,794 | 644,482 | 53,194 |
| 第5班サブエージェント(07部統治編 監査) | 129 | 22 回 | 561,245 | 1,906,014 | 48,770 |
| 第6班サブエージェント(10〜17部 監査) | 108 | 15 回 | 450,032 | 1,796,946 | 44,412 |
| 第7サブエージェント(アイキャッチ画像生成) | 6 | 3 回 | 16,672 | 0 | 3,124 |
| 総合計(親1 + 子7) | 1,292 | 215 回 | 5,537,996(約554万) | 21,794,205(約2,179万) | 488,170(約48.8万) |
-
全公開記事の敵対的ペルソナ監査 100% 網羅 : 6 つの監査班が全 18 分野の記事群を分担精読し、未作成だった個別監査レポート(
ペルソナ_*.md)28 ファイル を新規作成しました。 -
決定版マスター記事(約 13,042 文字)の新規執筆 : 数式・図解 2 基・比較表 2 基・専用アイキャッチ画像(WebP)を備えた統合記事を 1 本ゼロから書き上げました。
-
公開記事 84 ファイル+共通基盤の一斉連鎖改修 : 公開中の
.mdx計 84 ファイル、経済定数定義(economic_data.ts)、全体ルール(GEMINI.md)、整合性マップ、llms.txtまで矛盾ゼロで横断更新し、全件書式リンターエラー 0 件・本番サーバー転送・Playwright ブラウザ実機検証まで無停止で完了しました。
中央値の 2.0% で逆算すると、今回の構成における Google AI Ultra(20x)の週間枠 1% あたりの実効キャパシティは「延べ読込 約 1,367 万トークン(新規入力 約 277 万+キャッシュ 約 1,090 万)・出力 約 24.4 万トークン=公開記事 約 42 本の横断改修相当」 という驚異的な数字になります。
計測時に遭遇した未更新キャッシュ表示の罠
ここで 1 つ、同じように Antigravity の設定画面でクォータ消費を実測したい方へ 重要な注意点(ハマりかけた罠) を共有しておきます。
実は翌朝 08:35 に Antigravity Settings > Models タブを見返した瞬間、画面には次のように 67% / 96% のまま が表示されていたのです。
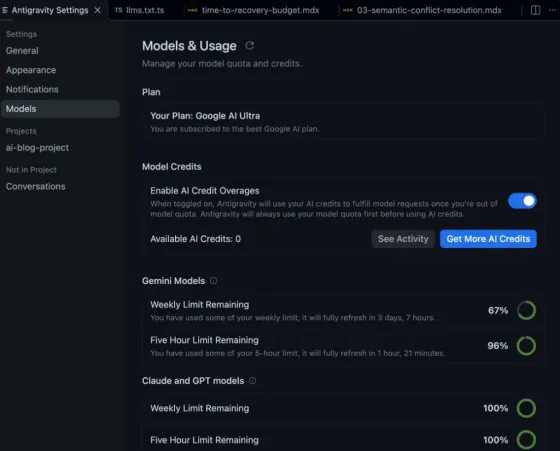
▲ 要注意の未更新キャッシュ画面:朝 08:35 に見たのに、週間枠の残り時間が昨夜と同じ「3 days, 7 hours」のまま止まっている
一瞬「えっ、2,733 万トークンも回したのに 0% 消費なの!?」と喜びそうになりますが、よく残り時間の英文を検算するとカラクリがわかります。
- 週間枠の残り時間 : 昨夜
00:39の画像とまったく同じin 3 days, 7 hoursのままで、8 時間経っているのに 1 時間も減っていません。 - 5 時間枠の残り時間 : 昨夜
00:39時点の1 hour, 46 minutesからちょうど 25 分だけ進んだ1 hour, 21 minutes(=昨夜01:04時点) で止まっています。
つまり、Antigravity Settings タブを開きっぱなしにしていると、エディタの別タブから戻ってきただけではサーバー側の最新クォータが自動再取得されず、前回描画された時点の古いキャッシュ画面がそのまま表示され続ける仕様 なのです。タイトル Models & Usage のすぐ右横にある 丸い更新アイコン(↻) を 1 回クリックしたところ、残り時間が正しい 2 days, 23 hours に切り替わり、真の残量である 65% が確定しました。クォータを計測する際は、必ず残り時間の経過整合性を確認して ↻ ボタンを押すのが鉄則です。
親コンテキスト肥大化がクォータを溶かす原因
単一スレッド直列丸読みが招く2乗膨張の罠
では、なぜ世間の多くの開発者やブロガーが「複数ファイルの一括監査やリライト」を AI に頼むと、1 回で週間枠が 15〜 20% も溶けてしまうのでしょうか?
最大の原因は、1 つのチャット画面(親エージェント 1 人)だけで対象ファイルを 1 本目、2 本目、3 本目……と順番に全文読み込み(read_file)させてしまう「親コンテキストの雪だるま式肥大化」 にあります。
クラウド上の大規模言語モデル(LLM)は、それ自体が前回の会話を記憶しているわけではなく、AI が 1 回返事やツール実行をするたびに「会話開始から今までの全履歴+過去に読み込んだ全ファイルの中身」を毎回最初から丸ごと送り直す仕組み になっています。
たとえば 1 記事あたり平均 8,000 トークンの記事を 80 本、1 人の親エージェントに順番に全文読ませて 120 ターン作業させた場合を考えてみましょう。最初は軽快でも、40 本目を読んだ後は毎ターン 32 万トークン、80 本すべて読んだ終盤は ちょっとした修正を 1 回するたびに毎回 64 万トークン以上の巨大な荷物 が積み上がったまま通信され続けます。数学的にはステップ数 に対して三角形の面積( :2 乗オーダー)で累積入力トークンが爆発するのです。
- 親 AI が 1〜 80 記事の全文を自分の記憶領域(コンテキスト)へ次々に詰め込む
- 後半は 1 ターン動くたびに数十万トークン が毎回累積再送され、延べ読込量が 6,000 万〜 1 億トークン超 へ膨張(試算・推論)
- 前に読んだ別記事の数値や文脈が混ざる 「文脈のにじみ(Context Rot)」 が起き、見落としや手戻りが急増する
- 全記事の精読は 6 つの独立した小部屋(サブエージェント) へ並列分散し、各班は 10〜 15 記事程度だけを集中精読
- 親 AI には 「対象ファイル・行番号・修正方針」の数千字メモだけ が返り、数百万トークンの生本文は小部屋終了とともに完全破棄
- 親 AI の頭脳は最後までスリムで明晰なまま保たれ、行番号ピンポイント編集で 延べ 2,733 万トークン(うち約 80% キャッシュ) に圧縮

なるほどねぇ!1 人の担当者さんの机の上に 84 冊分の分厚い資料を全部広げっぱなしにして「はい次のページ直して!」って毎回言っとったら、机も頭もパンクしてしまうけど、6 人の調査員さんに 14 冊ずつ別室で読んでもらって「直す箇所リスト」の紙 1 枚だけ受け取れば、親玉の机の上はずっとスッキリしたままなんじゃね!
まさにその通りです!「サブエージェントを 6 体も動かしたら、AI が 6 人に増えて利用枠を 6 倍食うのでは?」と誤解されやすいのですが、実際はその逆で、「親の机に生データの山を持ち込ませないための使い捨ての防波堤」 として使うからこそ、トータルの計算量が劇的に減るんです。
週間枠2%を実現した6班並列とSQLiteの3層設計
今回の全記事監査・84 記事改修で実際に動かしたワークフローは、大規模データ処理の世界で Map-Reduce(分散抽出と統合) と呼ばれる考え方を AI エージェント運用へ落とし込んだ 4 段階パイプラインです。
全文検索(grep)は使わず、ローカルの SQLite(FTS5) で記事一覧・既存の監査状況・関連リンク網を 0.2 秒で特定します。
第 00〜 17 部を 6 班の読み取り専用サブエージェントへ分割起動。各班が独立コンテキストで全文精読し、構造化レポートだけを親へ返します。
親またはファイル重複ゼロで排他分割した編集班が該当行だけを書き換え、Node.js リンター(0 トークン)で書式・未定義ミスを 0.1 秒検査します。
共通定数・ルール更新・Git 転送・Playwright ブラウザ表示確認を親が一元統括し、ファイル競合ゼロで一発完遂します。
それぞれの層で効いている技術的な工夫を 3 つに整理して解説します。
並列サブエージェント6班による親の記憶隔離
先ほどの生ログ集計表の通り、今回は第 1 班〜第 6 班の読み取り専用(research)サブエージェントがそれぞれ 12〜 22 回のモデル呼び出しを行い、6 体合計で 新規入力 324 万トークン+キャッシュ読込 828 万トークン(計約 1,152 万トークン) の記事本文と既存監査書を読み込んでいます。
もしこの読み込みを親エージェント 1 人で行っていたら、親が後半に行った 84 ファイル分の編集ターン(約 100 回)のすべてにこの数百万トークンの生本文が重石として乗っかり続け、それだけで数千万〜 1 億トークンが余計に消費されていました。6 班の小部屋に「読む仕事」を隔離して 「どの記事のどの部分にどんな抜け穴があり、どう補強すべきか」という結論だけ を受け取ったことで、親の新規入力は最後までわずか 229 万トークン に抑え込まれています。
ローカルSQLite行特定と決定論ツールの分担
さらに、親エージェントがいざ 84 個の .mdx ファイルを改修していく段階でも、「確認のために毎回 1 行目から 300 行目まで全文 read_file する」という無駄を徹底排除しています。
- 行番号アウトラインの即時取得(0 トークン) : 自作の
kb_query.mjs(SQLite FTS5 全文索引)とarticle_toolkit.mjs outlineを使い、各記事の「どの見出しや専用ボックス(GadgetSection)が何行目から何行目にあるか([L120-L155]等)」をローカル CPU だけで数ミリ秒で割り出し、必要な数十行だけをピンポイントで読み書きしています。 - 書式・構文検査の決定論 CLI オフロード(0 トークン) : 見出しの 30 文字上限チェック、日本語と太字
**の外側スペース検査、ハングル文字混入検査、画像サイズ検査、未インポートの Astro コンポーネント検査などは AI の目視に頼らず、article_toolkit.mjs checkという決定論的な Node.js スクリプトで全記事を一括機械検査しています(今回の途中ビルドで 1 件だけ発生した数式コンポーネントKaTeXFormulaの import 漏れも、全記事スキャンを一瞬で走らせて他に残存 0 件であることを確定させてから本番転送しました)。
キャッシュ再利用率80%と競合ゼロ統括ルール
3 つ目の大きな柱が、延べ読込 2,733 万トークンのうち 2,179 万トークン(79.7%) がプロンプトキャッシュ読込(cache_read_tokens)で処理されたこと です。
Google のサブスクリプション内部で「新規入力トークン・キャッシュ読込トークン・出力トークンがそれぞれ何対何の重みで週間クォータ(%)から差し引かれるか」の正確な計算式は非公開です。ただし、一般的な商用 LLM API の料金設計において キャッシュ読込の単価は通常の新規入力の約 4 分の 1 〜 10 分の 1 程度 に設定されています(毎回ゼロから注意機構[Attention]の初期計算[Prefill]をやり直す必要がなく、保存済みの計算状態を高速再利用できるためです)。したがって、システムルール(GEMINI.md)を 2 万トークン予算内に整理して 約 8 割をキャッシュヒットさせたことが、2,733 万トークン回しても週間枠が 2% しか減らなかった最大の物理的要因である と合理的に推論できます。
複数エージェントを並列で動かす際、一番やってはいけない事故が 「複数のエージェントが同じファイルを同時に書き換えて互いの変更を上書き破壊する競合状態(Race Condition)」 です。当サイトでは GEMINI.md に以下の運用ルールを明文化して 100% 防いでいます。
-
調査・監査フェーズは『読み取り専用(Read-only)』で並列化する : 全記事の精読や問題点の洗い出しは、ファイルを一切書き換えない
researchサブエージェント班(4〜 6 班)で安全に一斉並列実行します。 -
修正・書き込みを並列化する場合は『ファイル重複ゼロで完全排他分割』する : 記事ファイルの編集自体も複数の作業サブエージェント(
self)へ分担させる場合は、必ず「第 1 班は01-analysis/配下のみ」「第 2 班は02-vision/配下のみ」のように 触るファイル集合が 1 ファイルたりとも重ならないよう完全排他分割(Disjoint Partitioning) します。 -
共通ファイルと最終ビルド・実機検証は『必ず親エージェント 1 人』が統括する : 複数記事から共有される定数ファイル(
economic_data.ts)、目次ハブ(index.mdx)、進捗表(TODO_ROADMAP.md)、アフィリエイト台帳(index.ts)、全体ルール(GEMINI.md)の更新と、最終リンター検査・本番転送・Playwright 実機確認は、必ず最後に親エージェント 1 人が一括実行します。
Argon以外のモデルでも並列読込や6班処理はできる?
ところでふと思ったんじゃけど、この「複数ファイルの並列読み込み」とか「サブエージェントの並列処理」って、Argon 以外のモデル(軽い Gemini 3.8 Flash や Claude 系)でもできるんかね?もしできるなら、もっと軽いモデルで並列に回せばさらに枠が浮くんじゃない?
すごく大事な疑問ですね!実は 「エディタ(器)の機能として呼び出せるか」と「実戦で並列処理がまともに機能・完走するか」はまったく別物 なんです。手元の全 1,393 会話の生ログ(transcript.jsonl)を丸ごと集計したら、衝撃的な実測差が出てきました!
まずシステム(VS Code の Antigravity 拡張機能や Antigravity 2.0)の仕様からお伝えすると、「1 回の応答で複数ファイルを同時に開く機能(並列ツール呼び出し)」や「サブエージェントを起動する機能(invoke_subagent)」自体は Argon 専用にロックされているわけではなく、他のモデルにも開放されています。
ところが、実際に蓄積された 全 1,393 会話 のツール実行履歴をモデル別に横断解析したところ、Argon 以外のモデルでは 「①そもそも並列で読まず 1 個ずつ直列処理になる壁」 か、「②並列起動した途端に利用枠・レート制限で一斉停止する壁」 のどちらかに阻まれていました。
| モデル名(生ログ実測) | ツール実行ステップ | 並列ツール実行率(1回平均) | 複数ファイル同時読込 | サブエージェント並列の実績と結末 |
|---|---|---|---|---|
| Gemini 4 Argon (High) | 11,427 回 | 49.9%(平均 2.53個) | 2,746 回(最大 28本同時) | 延べ 164体起動・異常停止 0件(完遂率 100%) |
| Gemini 3.8 Flash (High) | 5,374 回 | 0.02%(平均 1.00個) | 0 回(1,418回すべて単発) | 直列思考のみで並列読込ゼロ(※10月中旬稼働分) |
| Gemini 3.1 Pro (High) | 11,318 回 | 3.7%(平均 1.05個) | 198 回(最大 11本同時) | 96.3% が 1 個ずつの直列実行(※現在は引退済) |
| Claude Sonnet / Opus 5.5 | 189 回 | 24.3%(平均 1.46個) | 4 回(最大 2本同時) | 13〜14体並列起動時、Sonnet 9/13体・Opus 14/14体 が異常停止 |
この生ログの数字から、なぜ司令塔も監査班も Gemini 4 Argon 一択 になるのかという物理的な理由がハッキリわかります。
-
軽量モデル(
3.8 Flash)の「完全直列化」の壁 : エディタ側は並列読み込みに対応しているにもかかわらず、3.8 Flash (High)は 5,374 回のツール実行のうち複数同時発行が わずか 1 回(0.02%)、ファイル読み込み(1,418 回)に至っては 同時読み込みがなんと0 回(0.0%)でした。軽量蒸留モデルは「これから必要な 10 個のファイルを先にまとめて開く」という俯瞰的な先読み計画を立てられず、「1 個開いては考え、また 1 個開いては考える」という目先の直列ループに陥るため、かえって往復ステップ数と履歴再送コストが膨れ上がってしまいます。 -
外部調達モデル(
Claude Sonnet 5.5/Opus 5.5)の「一斉墜落・枠枯渇」の壁 : Claude の上位モデルは並列計画の知能自体は持っており、実際に過去ログでも全記事監査のためにサブエージェントを一斉起動した記録が 2 回残っています。しかし、別記事で詳しく検証した通り Google AI Ultra 内では自社 TPU で動く Gemini 枠と外部 API 調達の Claude 枠が別天井(厳しい同時レート制限・利用枠)になっています。その結果、Sonnet 5.5で 13 班を起動した際は9 体(69.2%)が途中エラー停止(さらに 5 時間枠枯渇で 7 時間中断)、Opus 5.5で 14 班を並列起動した際は開始わずか 2 分後に14 体すべて(100%)がencountered an errorで一斉全滅し、そのまま週間 Claude 枠0%ロック に陥っていました。
Gemini 4 Argon だけがこの並列設計を無停止・省クォータで完走できるのです。
時間単価の算数と複数記事を並列監査させる手順
プラン別の快適コスト試算と5x・20xの選び方
ここで「84 記事の大改修を回してたった 2% しか減らないなら、月額 32,000 円の最上位『Google AI Ultra 20x』ではなく、月額 14,500 円の『Ultra 5x』でも十分なのでは?」という疑問が湧く方も多いと思います。これを実際の数字と時間単価で整理してみましょう。
過去の検証記事で実測した通り、Ultra 5x の週間利用枠は Ultra 20x の 4 分の 1(25%) です。したがって、今回の超大型ジョブ(20x で約 2% 消費)をそのまま Ultra 5x で走らせた場合、1 回の実行で週間枠の約 8% 前後を消費する計算(推論) になります。
- Google AI Ultra 5x(月額 14,500 円:1 日あたり約 483 円)が向くケース : 1 日 24 時間常駐換算なら 1 時間あたり約 20 円(毎日 4 時間の実作業換算でも 1 時間あたり約 121 円[試算・推論])です。普段は日々の壁打ちや 1 日 1〜 2 本の記事作成が中心で、今回のような数十記事規模の並列監査は「週に 2〜 3 回できれば十分」という方なら、この並列設計を取り入れることで 5x でも枠切れの不安なく快適に運用できます。
- Google AI Ultra 20x(月額 32,000 円:1 日あたり約 1,067 円)が真価を発揮するケース : 24 時間体制換算で 1 時間あたり約 44 円(1 日 8 時間稼働換算で 約 133 円[試算・推論])です。今回のような「全記事監査+ 1.3 万字執筆+ 84 記事改修」という人間なら数週間〜数ヶ月かかる大工事を 単純計算で週に約 50 回(1 回あたり実質約 160 円相当[試算・推論]) も回せる圧倒的な余裕があります。500 記事超のサイト運営と複数ツールの開発を毎日気兼ねなく並列で回し、残りパーセントを一切気にせず自分の自由時間を買いたい母艦用途には 20x が最強の投資になります。
見栄のための消費に数万円を払うのではなく、「自分は面倒な全件チェックや手直しで 1 秒も消耗せず、深夜の 1 時間ちょっとで AI に 84 記事すべてを完璧に仕上げさせ、翌朝はスッキリした頭でコーヒーを飲みながら結果を確認するだけ」 という時間のゆとりこそ、道具と設計にお金をかける一番の価値だと感じています。
最上位AIに並列監査を実装させるプロンプト
最後に、あなたの Astro ブログやプログラム開発プロジェクトでも、複数ファイルの監査や一括改善を行う際に 「親コンテキスト肥大化によるクォータ浪費」を防ぐ運用ルールを AI 自身に組み込ませるための指示プロンプト を共有します。
必ず『Gemini 4 Argon』(または同等以上の最上位推論モデル)を選択した上で、以下のプロンプトをあなたのプロジェクトに合わせてコピー&ペーストして使ってみてください(※軽量モデルを使うと分割設計の意図を読み飛ばして暴走しやすいため、司令塔には必ず最上位モデルを使ってください)。
https://lab.chihouzakki.com/blog/review/ultra-quota-2percent-subagent-parallel-84-audit/

上記の記事で実証されている「複数班サブエージェント並列による親コンテキスト肥大化の遮断(Map-Reduce型監査・改修プロトコル)」を参考に、私のプロジェクトで複数ファイル(5ファイル以上)の監査・横断調査・一括改修を行う際の標準ルールを設計してください。

いきなりファイルを書き換えるのではなく、まず以下を実行して計画を提示し、私の合意を得てから反映してください。
1. 現在のプロジェクト構成(記事・コードのディレクトリ構造、既存のルールファイルやリンタースクリプトの有無)を読み取り専用で調査する。
2. 今後の複数ファイル監査・改修において、以下の3原則をプロジェクトのルールファイル(GEMINI.md 等)へ組み込む文案を作成する:
   - 【原則1:Read-only並列調査】親エージェント1人で全ファイルを直列全文Readしてコンテキストを雪だるま式に肥大化させることを禁じ、4〜6班程度の読み取り専用サブエージェントへ分割して「対象パス・行番号・問題点・具体的修正案」の構造化メモだけを親へ返させること。
   - 【原則2:競合ゼロ編集とピンポイント読み書き】修正時は対象行範囲のみをピンポイント編集し、書き込みまで並列化する場合は編集ファイル集合が1つも重複しないよう完全排他分割すること(雑な正規表現による一括置換スクリプトで文脈を壊さないこと)。
- 【原則3:親による共通統合と機械検査】複数ファイルから共有される設定・定数・目次ファイルの更新と、最終の構文・ビルド検証は必ず親エージェント1人が最後に一括実行すること。-
取り入れて間違いなく幸せになる人 : 記事数やファイル数が数十〜数百本に増えてきており、最上位モデル(Argon 等)の高い品質を維持したまま、週間クォータの消費と待ち時間を最小限に抑えたい方
-
まだ気にしなくて大丈夫な人 : 1 回のチャットで触るファイルが常に 1〜 2 個だけで、サイト全体の横断監査や一括リライトを行う予定がない方
AI の利用枠は「モデルのランクを落としてケチる」のではなく、「最上位モデルの頭脳をスリムなまま働かせる仕事の渡し方(アーキテクチャ)」 を整えるだけで驚くほど長持ちします。複数ファイルの監査でクォータ消費に悩んでいた方は、ぜひ「小部屋への並列分担」を試してみてくださいね!

親玉の机を散らかさんように 6 つの小部屋でお片付けしたら、たった 2% しかお腹が減らんかったでちぃ!浮いた体力と時間で、今日もたっぷりブラッシングとお昼寝タイムをお願いするでち〜!