Geminiチャット履歴の永久保存術|Google TakeoutとTime MachineのWAL復元
毎日 AI と何時間も壁打ちして積み上げた設計メモやトラブル解決の記録は、後からお金では買えない「自分だけの一次知識資産」です。ところが Web 版のチャット履歴には保持期間の壁(標準 18 か月自動削除など)があり、ローカルの AI エディタもマシンの買い替えや高速化(RAMDisk 運用)の隙間に古いログが埋もれてしまいがちです。
結論からお伝えすると、AI との対話資産を一生失わないための最強構成は、「Web 版は Google Takeout の定期出力×ローカル自動和集合マージで永久蓄積し、エディタ版は Time Machine の SQLite WAL 結合・Protobuf 全文再構築と SSD アーカイブ層で一元統合すること」 です。本記事では、2 台の Mac から 794 会話を無欠損で救出し、合計 2,165 スレッドをミリ秒検索できる知識庫へ統合した全手順を公開します。
-
AIエディタの会話ログでRAMDiskが満杯?直近3日保持とSSD自動退避で空き容量を2倍にした構築録 : 完了済みの古い会話フォルダとSQLiteをWAL統合・完全一致検証付きでSSD保管庫へ自動退避し、2,199件の全文検索を維持したままRAMDiskの空き容量を4GBから8GBへ倍増させた実践録です。
-
Google AI週間クォータ消費を半減!SQLite×RAMDiskで500記事運用を高速化した記録 : 統合した知識&履歴 SQLite を 512MB〜 1GB のメモリマップで高速化し、AI への累積入力文字数を 51.2% 削減したチューニング実践録です。
-
【AIエディタ改造録】使いにくい標準チャット履歴を克服!macOSメール風3カラム拡張機能『Convo Mail』を自作した全記録 : 本記事で救出・統合した全 2,165 会話を、Mac の純正メールアプリ感覚で 3 カラム検索・ピン留めできる自作拡張機能の実装録です。
-
【16GB RAMDisk 爆速化術】64GBメモリの余剰でSSD寿命を守りビルドを30秒で終わらせる設計 : 内蔵 SSD の寿命を守りつつ揮発リスクを 5 分周期同期で防ぐ、RAMDisk 運用の基本設計を詳しく解説しています。
-
【iMac 27インチ延命&周辺機器】PRO-G40 SSD実測3,000MB/sとLuna Display活用 : Time Machine バックアップや大容量アーカイブの母艦として愛用している Thunderbolt 3 対応 SSD の実測レビューです。
-
SQLiteはなぜMySQLより速い?WAL・FTS5とNode.jsで500記事探索をミリ秒化した実装録 : 1ファイルで動くSQLiteがMySQLより速い理由(通信ゼロ・35%高速・WAL)と実用上限の目安を解説。本番のAstro静的HTMLは維持したまま、Node.js標準SQLiteとFTS5で500記事のAI探索をミリ秒化した設計を公開します。
-
MacのSafariブックマークをChrome・Firefoxへ移行する手順|権限不要&Time Machine復元 : MacのSafariからChromeやFirefoxへお気に入りを移行する際、フルディスクアクセス権限を渡さず安全に移すHTML書き出し手順を解説。消えたBookmarks.plistをTime Machineから復元するコツも網羅します。
-
Web 版 Gemini や AI エディタで日々壁打ちをしており、過去の大切なやり取りがいつか消えてしまう不安 を感じている方
-
Google Takeout の手動ダウンロードや解凍が面倒で、半自動・ノータッチで手元の検索データベースへ取り込みたい Mac ユーザーの方
-
旧マシンの Time Machine バックアップ内に眠っている AI エディタの過去ログ(
.jsonlや.db-wal)を欠損なく復元・統合したい 方
AIチャット履歴が気づかぬうちに消える2つの盲点
「クラウドにログインしていれば昔のチャットもずっと残っているはず」「エディタの中に履歴一覧が出ているから大丈夫」と思い込んでいると、ある日突然、半年前に苦労して導き出した解決策が見つからなくなる事態に直面します。実際に運用していて突き当たった消失リスクは大きく 2 つありました。
| 履歴の種類 | 潜んでいる消失・分断リスク | 放置した場合の末路 | 本記事で構築した恒久対策 |
|---|---|---|---|
| Web 版 Gemini 履歴 | アクティビティ保持期間(初期設定 18 か月等)による古い順からの自動削除・API 非公開 | 1 年半前の壁打ちログがクラウド上から静かに消滅する | Takeout 定期出力+launchd 監視+和集合(Union)永久マージ |
AI エディタ(/brain 等) | PC 移行時の隠しフォルダ取りこぼし・RAMDisk 初期構築時の退避漏れ・強制終了時の未統合 .db-wal | 旧機の Time Machine 奥底に眠ったまま検索不能になる | PRAGMA wal_checkpoint 結合+SSD アーカイブ層+オンデマンド復元 |

Web 版の Gemini って、気づかんうちに古い会話から順番に消えていく設定になっとることがあるんよね。「あの時の計算式どこだっけ?」と探しても出てこん時の絶望感は半端ないんじゃ。

しかも Google データ エクスポート(Takeout)はセキュリティ仕様上、外部から API で完全自動取得することができません。だからこそ、「Google 側の毎月(または 2 か月ごと)の定期書き出し機能」と「Mac 側のフォルダ監視スクリプト」をリレーで繋ぐ設計 が驚くほど効いてくるんです!
Google Takeout自動監視と和集合マージの仕組み
毎月定期出力とlaunchdによるゼロタッチ取込
古い解説記事やヘルプの一部では「2 か月ごと(年 6 回)」と案内されていることがありますが、現在の Google データ エクスポート(takeout.google.com)の「② ファイル形式、エクスポート回数、エクスポート先の選択」画面では、以下の 3 つの頻度 からスケジュールを選べるようになっています。
- 1 回のエクスポート(1 回のエクスポート) :今すぐ手動で 1 回だけバックアップを取りたい場合
- 1 か月ごとに 1 年間エクスポート(12 回のエクスポート) :毎月の自動アーカイブに最適(おすすめ)
- 2 か月ごとに 1 年間エクスポート(6 回のエクスポート) :隔月ペースで自動保存したい場合
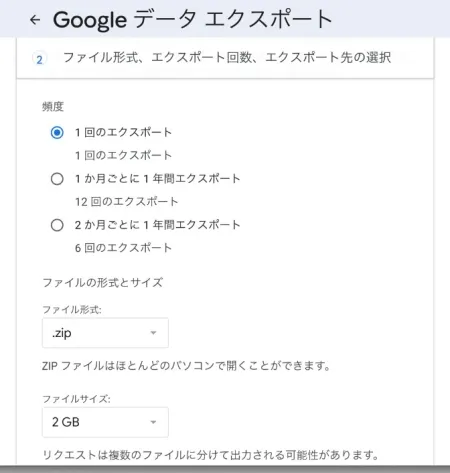
▲ 現在の Google データ エクスポート設定画面。「1 か月ごとに 1 年間(12 回)」と「2 か月ごとに 1 年間(6 回)」の両方が選択できます
あわせて画面下部の「ファイルの形式とサイズ」は、ファイル形式を初期値の .zip のままにしておきます(後述のスクリプトが ZIP 全体を解凍せず内部の記録ファイルだけを直接抜き出すためです)。ファイルサイズは初期値が 2 GB(超過時は複数の .zip ファイルに分けて出力)となっており、そのまま分割されてもスクリプト側で該当ファイルを自動判別して取り込めますが、添付画像等が多く 1 ファイルにまとめたい場合はプルダウンで 10 GB や 50 GB へ引き上げておくと Google ドライブ内の管理がさらにスッキリします。
この定期エクスポート(配信先:Google ドライブに追加)と、macOS デスクトップ版の「Google ドライブ」アプリ、そして標準のバックグラウンド実行機構である launchd を組み合わせると、アーカイブが生成された瞬間に Mac が自動検知してデータベースへ取り込む「ほぼ全自動パイプライン」が完成します。
1か月ごと(年12回)または2か月ごと(年6回)の定期エクスポートにより、GoogleドライブへZIPが自動出力されます。
DownloadsやGoogleドライブ同期領域を監視し、lsof検査で同期完了を確認してから処理を開始します。
ZIP全体をSSDに解凍せず、PythonのzipfileストリームでマイアクティビティJSONだけをRAMDiskへ抜き出します。
スレッド単位で過去ログと和集合マージし、SQLite全文検索DBとMarkdownへ同時保存します。
自動監視を行う sync_gemini_takeout.mjs と launchd の連携では、実運用で踏みがちな 4 つのエッジケース(罠) を潰しています。
-
lsof -F aによる「ダウンロード中・同期中」の誤読防止 : 数百 MB の ZIP ファイルが Google ドライブから同期されている最中に解凍を始めると破損エラーになります。単なるファイルの有無ではなく、lsof -F aで書き込みモード(wまたはu)のプロセスが掴んでいないことを確認してから取り込みを開始します(Finder のプレビュー等の読み取りrモードでは止まらないよう区別しています)。 -
WatchPathsの自己再発火(無限ループ)防止 :launchdのWatchPathsで監視しているフォルダ直下に同期済み管理ファイル(.sync_state.json)を書き込むと、その書き込み自体がファイル変更とみなされて再びスクリプトが起動してしまいます。状態ファイルは必ず 1 階層下のサブディレクトリへ格納し、未更新時は 0.05 秒で静かに終了させます。 -
古い ZIP ヘッダの日本語ファイル名文字化け救済 : Takeout の ZIP 内に含まれる
Gemini アプリ/マイアクティビティ.jsonは、UTF-8 フラグ(0x800)が立っていない環境ではcp437として解釈されて文字化けすることがあるため、デコード処理と Unicode NFC 正規化を挟んで確実に捕捉します。 -
初期値『HTML形式(
マイアクティビティ.html)』の自動変換と非対称タイムスタンプ重複排除 : Google Takeout は出力形式の初期値がHTMLになっているため、うっかりJSONへ変更し忘れてエクスポートしてしまうことがよくあります。そこで ZIP 内および展開済みフォルダのマイアクティビティ.htmlも自動検知して JSON 互換データへ変換しつつ、JSON 由来(ミリ秒精度)と HTML 由来(秒精度・JST 表記)の時刻ズレを「同一秒または ±1.5 秒以内+質問文先頭一致」で突き合わせ、二重登録ゼロで統合できるようにしています。
18か月自動削除に負けないUnion差分マージ
Takeout 連携で最も重要なのが、「最新の ZIP で上書き(置換)してはいけない」 という鉄則です。もし将来クラウド側で古いアクティビティが自動削除された後に新しい Takeout ZIP を取り込んだ場合、単純な上書き方式だと手元の古い会話まで一緒に消えてしまいます。
そこで当サイトの同期スクリプトでは、既存のローカル保存済みレコードと新規 ZIP 内のレコードを「スレッド ID × タイムスタンプ × 本文ハッシュ」で突き合わせる 和集合(Union)差分マージ を実装しました。これにより、クラウド側で何が消えようとも、一度でも手元に取り込んだ Web 版 Gemini の全 818 スレッドは 1 文字も欠けることなく永久に蓄積され続けます。
Time Machineからの794会話救出とWAL結合
未統合の.db-walを欠損ゼロで結合する技術
Web 版の履歴と並んで大捜索を行ったのが、AI エディタ(Antigravity)の過去ログです。先代の iMac 15,1(2026 年 9 月 6 日までのバックアップ)と、現行機 iMac 20,1 の Time Machine バックアップ(外付け SSD)を徹底走査したところ、まだ現在の環境へ統合されていなかった 計 794 件もの会話データ(旧機 500 件+現行機過去分 294 件) が眠っていることが判明しました。
ここで技術的な山場となったのが、conversations/ フォルダ内に保存されている SQLite データベース(<会話ID>.db)の扱いです。バックアップ取得タイミングによっては、本体 .db の横に <会話ID>.db-wal(最大 4.4MB 超の先行書き込みログ) と .db-shm が残ったままスナップショットされていました。

.db ファイルだけをコピーして持ってきたらダメなのかしら?横にくっついている .db-wal って何なの?
そこが一番危ないポイントなんです!SQLite の WAL(Write-Ahead Logging)モードでは、直近の新しい書き込みデータはまず .db-wal 側に追記され、まだ本体の .db には反映されていない状態 があります。.db だけを抜いて .db-wal を捨ててしまうと、会話の後半がごっそり消えたりデータベースが破損したりするんです。
そこで統合スクリプト merge_rescued_brain.mjs では、Node.js 標準の node:sqlite(DatabaseSync)を使い、元の最終更新日時(mtime)を守りながら WAL を本体へ完全統合するチェックポイント処理を実装しました。
// scripts/merge_rescued_brain.mjs(抜粋:未統合の .db-wal を欠損ゼロで本体 .db へ結合)
import fs from "node:fs";
import { DatabaseSync } from "node:sqlite";

function checkpointWalIfNeeded(dbPath) {
  const walPath = `${dbPath}-wal`;
  const shmPath = `${dbPath}-shm`;
  if (!fs.existsSync(walPath) && !fs.existsSync(shmPath)) {
    return { checkpointed: false, walBytes: 0 };
  }

  // チェックポイント実行で mtime が現在時刻に書き換わらないよう、元の更新時刻を退避
  const dbStat = fs.statSync(dbPath);
  const walStat = fs.existsSync(walPath) ? fs.statSync(walPath) : null;
  const targetMtime =
    walStat && walStat.mtimeMs > dbStat.mtimeMs ? walStat.mtime : dbStat.mtime;
  const walBytes = walStat ? walStat.size : 0;

  // WAL内の未反映トランザクションを本体 .db へ完全統合して切り詰める
  const db = new DatabaseSync(dbPath);
  try {
    db.exec("PRAGMA busy_timeout = 5000;");
    db.exec("PRAGMA wal_checkpoint(TRUNCATE);");
    db.exec("PRAGMA journal_mode = DELETE;");
  } finally {
    db.close();
  }

  // 不要になった補助ファイルを掃除し、本来の会話更新日時を復元
  for (const aux of [walPath, shmPath]) {
    if (fs.existsSync(aux)) fs.unlinkSync(aux);
  }
  fs.utimesSync(dbPath, dbStat.atime, targetMtime);

  return { checkpointed: true, walBytes };
}
この処理により、4.4MB や 1.7MB の未反映データが残っていた重要セッションを含む全 793 個の .db ファイルが、1 バイトの取りこぼしもなくクリーンな単一ファイルへと統合されました。
Protobufからの全文再構築と自動復元
さらに今回の救出で劇的だったのが、「brain/(JSONL テキストログ)が消えていた期間の 140 会話も、conversations/*.db 単体から 100% 完全復活できた」 という発見です。
初期の RAMDisk 構築期(9 月中旬〜下旬)は、brain/ フォルダだけを先に RAMDisk(シンボリックリンク)へ逃がしていたため、Time Machine 上には JSONL テキストログが残っていませんでした。しかし、隣で SSD 実体のまま動いていた conversations/<会話ID>.db の内部スキーマを解析したところ、steps テーブルの step_payload カラムに Protocol Buffers(Protobuf)バイナリ形式で 「質問文(step_type=14)」「AI の回答・思考プロセス・ツール呼び出し(step_type=15)」「正確なタイムスタンプ」まで全ステップが丸ごと保存されている ことが分かりました。
そこでバイナリから純正タイトルと全ターンをデコードして transcript.jsonl を自動再生成する処理を組み込んだ結果、失われたと思われていた開発初期の貴重な会話ログまで一字一句欠けることなく蘇りました。
また、救出した 794 件の過去ログをすべて 16GB の RAMDisk(現役の /brain 領域)へ戻してしまうと、貴重なメモリ容量を圧迫してしまいます。そこで以下の 「2 階層ストレージ+オンデマンド自動復元」 を構築しました。
現在進行形で読み書きする会話のみを配置。毎秒30GBクラスのメモリ速度でAIエディタが軽快に動作します。
旧機やTime Machineから救出した794件とTakeout取込分を保管。普段はRAMDisk容量を1バイトも消費しません。
現役・救出・Web版の全2,165スレッドを一括インデックス化し、数ミリ秒〜0.05秒で全文検索できます。
全2165会話をミリ秒検索するSQLite統合基盤
救出と統合を終えた結果、手元の知識データベースは以下の通り、マシン移行期のわずかな空白を除いて初期から現在まできれいに一本の線で繋がりました。
| データ区分 | 収録期間 | 会話スレッド数 | 保管・運用形態 |
|---|---|---|---|
先代 iMac 15,1 救出分 | 2026-08-09 〜 2026-09-06 | 500 件 | SSD アーカイブ保管(必要時自動復元) |
現行 iMac 20,1 TM 救出分 | 2026-09-07 〜 2026-10-01 | 294 件 | SSD アーカイブ保管(WAL結合・Protobuf全文再構築済) |
現行アクティブ /brain | 2026-10-05 〜 現在 | 553 件 | RAMDisk 稼働 ⇄ SSD 定期同期 |
| Web 版 Gemini(Takeout) | 2025-12-30 〜 現在 | 818 件 | Google ドライブ監視+Union 永久マージ |
| 統合データベース 合計 | 全期間横断 | 2,165 件 | conversations.sqlite(約 414MB) |
※その後の進化アップデート :初期統合時は上記のように現行 /brain の 553 件すべてを RAMDisk 上に置いていましたが、スクリーンショット等を含めると約 3.84GB に膨らんでメモリ領域を圧迫するため、現在は 「直近 3 日分(約 95 件)のみを RAMDisk に残し、完了済み 475 件は SSD 永久アーカイブへ自動退避する運用」 へ進化させました(検索対象の欠損ゼロで空き容量を 4GB → 8GB へ倍増させた手順は 直近3日保持とSSD自動退避で空き容量を2倍にした構築録 で解説しています)。

2,100 件を超える大量のおしゃべり記録が、414MB のファイル 1 個にギュッとまとまって、一瞬で検索できるなんて魔法みたいでちね!
まさに Time Machine 用の高速な外付け SSD をしっかり繋いでいたからこそ、1 か月半前の .db-wal まで無傷で掘り起こすことができました。日々のバックアップがいかに最後の命綱になるかを改めて実感しましたね!
大容量の Time Machine バックアップと数千件のアーカイブ移動をストレスなくこなすには、熱ダレせず毎秒 2,500〜3,000MB クラスで安定稼働する Thunderbolt 対応ポータブル SSD が 1 台あると本当に心強いです。
まとめ:AIとの対話資産を一生モノの知識庫にする
AI とのチャット履歴は、単なる「終わった会話の残りカス」ではなく、あなたの思考の軌跡や試行錯誤の結晶そのものです。クラウド側の保持期限や PC の買い替えで大切な記憶が消えてしまう前に、「Takeout の定期出力×和集合マージ」と「Time Machine 外付け SSD による多世代保護」 をぜひ整えておきましょう。
-
導入して幸せになる人 : AI との壁打ちからブログ記事や設計書・個人開発アプリを生み出しており、数年前の議論や数値も 0.1 秒で引き出せる「一生モノの外部脳」を作りたい方
-
別の選択肢が向く人 : AI をその場限りの翻訳や短い調べ物にしか使わず、過去のやり取りを振り返る機会がない方
手元の Mac に Takeout の自動取り込みや過去ログ統合データベースを構築したい方は、以下のプロンプトを最上位モデルの AI エディタへ貼り付けて相談してみてください。
※SQLite の WAL チェックポイント処理や既存シンボリックリンクの保護は繊細なファイル操作を伴うため、必ず 『Gemini 4 Argon』(または同等以上の最上位推論モデル)を使用して安全に進めてください。
以下の記事の設計手順を参考に、私の Mac 環境でも「Google Takeout(Gemini履歴)の自動和集合マージ」および「過去チャットログの SQLite FTS5 全文検索データベース化」を構築したいです。
参照URL: https://lab.chihouzakki.com/blog/review/ai-chat-history-takeout-timemachine-wal-recovery/

【作業ルール(厳守)】
1. まず私の環境(保存先ディレクトリの空き容量、Google ドライブ同期フォルダの有無、Time Machine から取り出したいログの有無)を確認し、既存ファイルを絶対に上書き・削除しない安全な設計計画を提示してください。
2. Takeout ZIP からの抽出時は、lsof による書き込み中チェックと、既存データを消さない和集合(Union)差分マージを必ず実装してください。
3. SQLite(.db-wal 付き)を扱う場合は、必ずドライラン(--dry-run)機能と事前バックアップを組み込み、元のタイムスタンプ(mtime)を保持したまま安全に統合してください。
過去に積み上げた知恵をいつでも自在に呼び出せるようになると、日々の創作や問題解決のスピードが何倍にも加速しますよ!

▲ 大切な記憶の結晶は、消えてしまう前にしっかり手元の金庫へしまっておきましょう