AI開発は記事執筆の20倍クォータが減る?週間制限が溶ける5つの原因と実測比較
「1万5,000字を超える長文のブログ記事を何本書かせても、AIの週間利用枠(Weekly limit)はほとんど減らない。それなのに、WebツールやmacOSネイティブアプリの開発を半日続けただけで、リセット直後の週間制限が一気に20%も溶けてしまった——」
最上位の Google AI Ultra(20x枠) とエージェント統合開発環境「Google Antigravity」を組み合わせて全 803記事(うち検証録 383記事)規模のサイト運営とツール開発を並行していると、この極端な「燃費の落差」に直面します。
文字数だけで見れば、1万5,000〜2万字の記事を書き下ろす方が、数百行のプログラムコードを修正するよりもはるかに重そうに思えるはずです。しかし、当ラボで週間枠リセット直後の12時間に稼働した全セッションの生ログ(/brain トランスクリプト)を1ステップ単位で解剖したところ、驚くべき一次データが浮かび上がりました。
標準的な新規記事執筆1本あたりの新規送信トークン(キャッシュ割引が効かない Fresh入力)は 約30.0万トークン(推論) に過ぎないのに対し、Web計算機からmacOSネイティブアプリ、気象API連携までを1つのチャットで10ターン連続開発したセッションでは、親子合算で 607.4万トークン(記事1本比で20.2倍)、さらに内部推論を含む出力トークンは 約3.1万対61.2万トークン(19.7倍) にまで膨張していたのです。
この記事では、同日12時間の全稼働ログと実機スクリーンショットを裏付け(エビデンス)として公開し、なぜプログラム開発だけがクォータを20倍もの猛スピードで溶かすのか、その背後にある 5つの構造的原因 を数式と実測値で解き明かします。
結論から言えば、クォータ消費を抑えようとして開発モデルを軽量版へ格下げするのは、境界値バグの手戻りで逆効果になる最悪の改悪です。最高峰の「Gemini 4 Carbon (High)」を固定したまま、実機確認の区切りごとに新規チャットへ切り替える「マイルストーン分割」と「ローカルSQLite索引」を組み合わせることこそが、開発品質100%とクォータ消費半減を両立する唯一の正解です。-
Tasks in Gemini(Geminiタスク)の使い方|日本で無料でできることとToDoリストとの違い : 日本を含む6カ国で無料開放された「Tasks in Gemini(Geminiタスク)」の実践ガイド。従来のGoogle ToDoリストやスケジュール機能との違い、日本で…
-
Gemini 4 CarbonとArgonで同じ記事を作らせた実測比較|時間・料金2.55倍差と生記事公開 :同一プロンプトでの処理時間・トークン内訳・API従量換算2.55倍差を検証した基礎ベンチマークです。
-
Google AI Ultraの5時間制限と週間制限の比率|577記事監査で週間4%・5時間18%消費の実測録 :5時間枠と週間枠の約4.5倍の天井バランスと、定型検問オフロードの効果を解明した記録です。
-
AIは新規チャットと継続どっちが節約?Pro・Ultra 5x・20xと規模別の正解 :KVキャッシュの割引と放置による時間切れ再計算の損益分岐点を整理した運用ガイドです。
-
Playwrightに公式Rust版がない理由とNode常駐162MBの罠|Chrome・Safari検証自作録 :今回の同日ログ計測でも実測対象となった、Pure Rust製MCPサーバー開発の舞台裏です。
-
Google AI UltraやPro、Claude Code、Cursor等のAIコーディング環境で「文章作成や壁打ちでは減らない利用枠が、アプリ開発やデバッグに入った途端に急減する」と悩んでいる開発者・クリエイターの方
-
エージェント型IDE(Antigravity等)における「KVキャッシュ有効率(Cache Hit率)」「Fresh入力トークン」「思考トークン(Thinking)」が、実際のクォータ消費にどう直結しているのかを生ログの数値で正確に把握したい方
-
モデルの推論精度を一切妥協せず、チャットスレッドの切り方(マイルストーン分割)とローカル索引設計だけで週間クォータの消費スピードを半減させたい個人開発者の方
同日生ログ実測:記事執筆とアプリ開発で20倍開く消費格差
AIエージェントを日常的に使い込んでいると、「今日は長文の記事を何本も仕上げたのに、利用枠のゲージがまったく減っていないな」と驚く日がある一方で、「午後に少しアプリの機能を拡張してビルドを通しただけなのに、週間制限がゴッソリ削れている!」と冷や汗をかく日があります。
この体感差は決して気のせいではありません。まずは、当ラボのメイン開発機(iMac・macOS環境)で記録された決定的な実機画面と、その裏側で走っていた全セッションの生ログデータから見ていきましょう。
リセット半日で週間枠20%消費!実機画面の衝撃
以下のスクリーンショットは、2026年11月18日の夜(19時56分時点)に、Antigravityのモデル使用量(Models Usage)パネルを撮影した実機画面です。
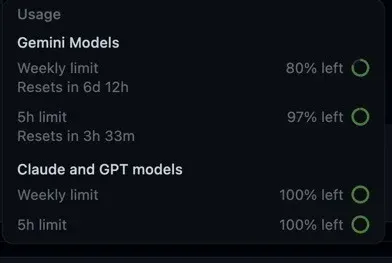
画面上部の「Gemini Models」(Gemini 4 Carbon / Argon 等の共通クォータ枠)の表示に注目してください。
この日の朝(07時56分頃)に週1回の週間制限(Weekly limit)が100%へリセットされたばかりにもかかわらず、わずか12時間後の19時56分には 80% left(すでに週間枠の20%を消費) という状態にまでゲージが減っています。週7日間(168時間)で使うはずの予算の5分の1を、たった半日で使い切った計算です。

ちょっと待って!画像のすぐ下にある「5h limit(5時間制限)」を見ると 97% left(3%しか減っていない) になっているよ?週間枠が20%も減っているのに、5時間枠が3%しか減っていないのは計算が合わないんじゃないかな?

そこが一番誤解しやすいポイントですね!実はこの2つのゲージは「集計している時間帯のスタート地点」がまったく違うんです。分単位のタイムスタンプを照合すると、パズルのようにピタリと辻褄が合いますよ。
なぜ「Weekly limit が 80% left(20%消費)」なのに、「5h limit は 97% left(3%消費)」なのか。画像の右側に表示されているリセット予告時刻を見れば、そのカラクリが一目で分かります。
-
Weekly limit(
80% left/Resets in 6d 12h)の集計範囲 :残り「6日と12時間(計156時間)」ということは、1週間(168時間)から差し引くと、当日朝07時56分の週間リセットからちょうど12時間が経過した時点 です。つまり、午前中の大規模コード監査から午後の記事執筆、夕方の連続アプリ開発まで、12時間分の全消費量(20%)が累積 されています。 -
5h limit(
97% left/Resets in 3h 33m)の集計範囲 :残り「3時間33分」ということは、5時間(300分)のカウントダウン枠が 18時29分頃に一度リセット(100%へ回復)されたばかり であることを示しています。つまり、18時29分より前に走っていた重い開発セッションの消費分はすでに5時間枠からは消えており、18時29分〜19時56分の約1時間半に実行された「最終ターンの仕上げ作業(3%分)」だけが反映されているのです。
以前、Google AI Ultraの5時間制限と週間制限の比率を577記事監査で検証した実測録 でも明らかにした通り、Ultra 20xプランにおける「5時間枠」と「週間枠」の天井比率は 約1対4.5 です。
5時間ごとに小窓のゲージが100%へ全快してくれるため、日中に5時間枠を40%〜50%ずつ2サイクル回しても「5時間制限の天井」には引っかかりません。しかし、裏側の「週間制限」にはそのすべての消費が着実に積み上がっていくため、半日で週間枠の20%が溶けるという現象が起きるわけです。
記事30万対連続開発607万トークンの全セッション表
では、この07時56分から19時56分までの12時間の間に、当ラボのAntigravity環境では具体的にどんな作業が走り、それぞれ何トークンを消費していたのでしょうか。
ローカルの /brain ディレクトリに記録されている全セッションの transcript.jsonl から、API呼び出し回数、キャッシュ割引が効かない新規送信トークン(Fresh入力)、キャッシュ再利用トークン(Cache読込)、そしてモデルの思考量を含む 出力トークン を親エージェント・子サブエージェント・Swarmワーカーまですべて合算して抽出した一次データ一覧表がこちらです。
| 作業カテゴリ | セッション内容(同日12時間の実稼働ログ) | 稼働モデル構成 | ターン数 / 親API回数 | 親子合算 Fresh入力(新規送信) | 親キャッシュ有効率(Hit率) | 親子合算 出力トークン(思考含む) | 標準記事1本比(Fresh倍率) |
|---|---|---|---|---|---|---|---|
| ① 新規記事執筆(標準) | GPT-6.2解説 + 商品リンク設計術(2本同時 ➔ 1本換算[推論]) | 親 Carbon + 執筆 Swarm Argon |
1ターン / 約25回(2本で49回) | 約30.0万 tok(2本計 60.0万) | 94.0% | 約3.1万 tok(2本計 6.2万) | 1.0倍(基準) |
| ② 既存記事リライト | Search Console(GSC)単発改善 4セッション平均 | 親 Carbon 直編集 |
1ターン / 19〜29回 | 約31.5万 tok(24.2万〜39.4万) | 73.7%〜89.0% | 約2.5万 tok | 1.1倍 |
| ③ 新規記事執筆(国家構想) | 公的IT調達・制度分析(2本同時 ➔ 1本換算[推論]) | 親 Carbon + 執筆 Swarm Argon |
1ターン / 約20回(2本で40回) | 約44.0万 tok(2本計 88.0万) | 86.9% | 約3.5万 tok | 1.5倍 |
| ④ Rust基盤改修 | Pure Rust製MCPサーバー改修・Node常駐駆逐(稼働58.0分) | 親+子3体 すべて Carbon |
4ターン / 79回 | 223.6万 tok(親170.3万+子53.3万) | 88.5% | 13.2万 tok | 7.5倍 |
| ⑤ Swift・UI改修 | macOS Swiftアプリ・UIピン留め制御改修(稼働99.0分) | 親+子2体 すべて Carbon |
2ターン / 129回 | 292.1万 tok(親223.2万+子68.9万) | 90.1% | 17.2万 tok | 9.7倍 |
| ⑥ 記事継ぎ足し(失敗例) | 1本目完了から 27分放置後 に同一チャットで別記事を追加依頼 | 親 Carbon + Swarm Argon |
2ターン / 119回 | 371.5万 tok(キャッシュ失効直撃) | 85.9% | 9.8万 tok | 12.4倍 |
| ⑦ 連続アプリ開発 | Web計算機+macOS SwiftUIアプリ新作+標高・気象API連携(稼働137.3分) | 親+子5体 すべて Carbon |
10ターン / 124回 | 607.4万 tok(親385.3万+子222.0万) | 86.4% | 61.2万 tok(親13.6万+子47.6万) | 20.2倍 |
| ⑧ 全記事横断コード監査 | 商品辞書492件×373記事のURL・表記横断監査(稼働135.6分) | 親+子4体 すべて Carbon |
2ターン / 60回 | 797.7万 tok(親229.7万+子568.0万) | 76.0% | 87.7万 tok | 26.6倍 |
この生ログの数値を視覚的に比較すると、記事執筆とプログラム開発(および放置継ぎ足し)の間に横たわる圧倒的な消費格差が一目瞭然となります。
いかがでしょうか。1万5,000字を超える本格的な技術記事を1本書き上げるのに必要な Fresh 入力は 約30.0万トークン(推論) であり、週間制限の消費に換算すると わずか0.2%以下(推論) です。つまり、同じ調子で記事を10本書いても週間枠は2%程度しか減りません。
ところが、⑦の「Web計算機+macOS SwiftUIアプリ新作+標高・気象API連携」を1つのチャットで10ターン連続開発したセッションでは、たった1つのチャットスレッドだけで 607.4万トークン(記事20本分相当!) もの Fresh 入力を食いつぶしていました。さらに④のRust改修(223.6万 tok)、⑤のSwift UI改修(292.1万 tok)、⑧の492件横断コード監査(797.7万 tok)が同じ日のうちに重なったことで、リセットから12時間で週間枠が20%溶けていたのです。
なぜ開発だけ急に減る?クォータを溶かす5つの構造的原因
「長文の記事を書くよりも、プログラムを書く方がなぜ20倍もトークンとクォータを消費するのか?」
生ログのステップ遷移とトークン内訳を精査すると、そこには単なる「作業時間の長さ」だけでは片付けられない、AIエージェントの構造に根ざした 5つの決定的な原因 が存在することが分かりました。
-
稼働モデルの単価重み差(約2倍) :記事執筆は最も重い長文生成を単価半額の「Swarm Argon」へ分業できるのに対し、プログラム開発はバグ防止のため親子すべて単価2倍の「Carbon (High)」で走る。
-
ビルド・自己テスト往復によるAPI呼び出し回数の急増(約3〜5倍) :記事は1ターン(約25回)の一本道で終わるが、開発はコンパイル・型検査・テスト実行・UI確認の往復で100回超のAPIコールが回る。
-
実機確認の合間に起きるKVキャッシュ時間切れ(TTL失効の直撃) :人間がアプリを触って動作確認している数分〜十数分の間にサーバー上のキャッシュが切れ、次回指示で数十万トークンの履歴が100%定価で再送信される。
-
内部思考トークン(Thinking)とコード出力の20倍増 :複雑な型推論や並行処理の設計では、画面に見えない内部推論トークンと出力コード量が記事執筆の約20倍(3.1万 ➔ 61.2万 tok)へ跳ね上がる。
-
複数言語コード・ビルドログ読み込みによる文脈(母数)の膨張速度 :TypeScript・Swift・Rustのソースコード群やコンパイラ出力を次々読み込むため、総プロンプト量が5,713万トークン規模へ雪だるま式に膨らむ。
それぞれの原因がどれほどのインパクトを持っているのか、順番に実測値で解剖していきます。
半額Argon一気書きとオールCarbon単価2倍の差
1つ目の原因は、「どのAIモデルが実作業のトークンを消費しているか」という単価重みの違い です。
Google AI 公式の Gemini API 料金表 および Antigravity 公式ドキュメントのモデル仕様 を確認すると、最上位の推論・コーディング特化モデルである Gemini 4 Carbon (High)(2026年12月1日以降の標準価格:100万トークンあたり入力 $4.00 / 出力 $20.00 ※11月末までは導入特例で据え置き)と、高速・長文生成に優れた Gemini 4 Argon (High)(標準価格:入力 $2.00 / 出力 $10.00)の間には、標準API単価で きっちり2倍の価格差 が設けられています。
定額サブスクリプションである Google AI Ultra の内部クォータ計算式は非公開ですが、モデルの物理計算負荷(TPU資源消費)や標準単価比率に応じて Carbon のトークン消費は Argon より重い係数(約2倍相当[推論])で週間枠から差し引かれている(推論) と見るのが自然です。当ラボが CarbonとArgonに全く同じ記事を書かせて比較したABテスト検証 でも、12月以降の標準単価で計算したセッション全体のコストには 2.55倍 もの開きが出ていました。
ここで、今回の生ログにおける「記事執筆セッション(①)」の内部ステップを見てみましょう。
-
親エージェント(
Gemini 4 Carbon High)の役割 :ローカルSQLite(kb-search prep)から事前カルテを1コールで取得し、構成設計を固めたら、すぐさま執筆ワーカー(Swarm Argon)を呼び出します。記事が書き上がったら、Pure Rust製の検問バイナリ(gemini-gate)に4ミリ秒で機械チェックさせ、本番転送するだけです。親自身の Fresh 入力は2本合計で402,778 tok(1本あたり 約20.1万 tok[推論])に収まっています。 -
執筆ワーカー(
Gemini 4 Argon High× 2体)の役割 :確定した設計ブリーフを受け取り、余計なファイル探索を一切行わず、わずか3〜7ステップで1万6,000字超のMDX原稿を一気書き(write_file)して即終了 します。ワーカー1体あたりの Fresh 入力は1本目が84,685 tok、2本目が91,810 tok(平均 約8.8万 tok)、出力は約3,250 tokしかありません。
つまり、記事作成では「一番トークンを食いそうな1.5万〜2万字の本文執筆」を、単価半額の Argon がたった8.8万〜10.1万トークンの Fresh 入力で一撃で終わらせている のです。
一方、④〜⑦のプログラム開発セッションではどうでしょうか。Rustの非同期ロック制御やSwiftUIのウィンドウ管理、境界値の型変換といった緻密な実装では、少しでも推論力の低いモデルを使うとバグが混入します。そのため、当ラボでは 親エージェントだけでなく、並列で走る3〜5体の子サブエージェント(invoke_subagent)に至るまで、100%すべて最上位の Gemini 4 Carbon (High) に完全固定 しています。
結果として、アプリ開発では「トークンの絶対量が膨らむ」だけでなく、「全トークンが単価2倍の Carbon (High) でカウントされる(推論)」 ため、クォータゲージの減り方がさらに加速する構造になっているのです。
コンパイルと自己テスト往復で膨らむAPI呼び出し回数
2つ目の原因は、完了までに必要な「API呼び出し回数(ステップ数)」の圧倒的な差 です。
ブログ記事の執筆は、構成さえ決まれば「事前カルテ取得 ➔ 本文一気書き ➔ 4ミリ秒の機械検問 ➔ 本番デプロイ ➔ 実機表示確認」という 綺麗な一本道(1ターン・親API呼び出し約25回) で完結します。途中でコンパイルエラーが出ることもなければ、OSの権限ダイアログに阻まれることもありません。
しかし、本格的なソフトウェア開発は決して一本道では終わりません。今回 607.4万トークンを消費した⑦の連続開発セッションは、同日に公開した タイヤの空気圧低下が見た目で分からない理由|低扁平の罠・kPa換算と自宅点検術 という記事から派生して、以下の機能を次々と実装していったものでした。
-
Web道具箱(Astro / TypeScript)の新規実装 :温度変化やタイヤサイズ変更(インチアップ)、JATMA / XL規格に応じた適正空気圧(kPa)とロードインデックスをリアルタイム計算するWebシミュレーターの構築。
-
macOSネイティブアプリ(Swift / SwiftUI)の新規構築 :同じ計算エンジンをMacのデスクトップ上でいつでも即座に呼び出せるよう、
swiftcでネイティブコンパイルしたスタンドアロンアプリの制作。 -
現在地の標高・リアルタイム気温の自動取得API連携 :標高による大気圧低下や外気温の変化を自動補正するため、位置情報と気象APIから現在地の標高・気温をワンクリック取得する通信モジュールの統合とエッジケース保護。
-
全10アプリのミラー同期と自己診断テスト(
--self-test) :リポジトリ内のtools/swift-apps/とデスクトップ上の実働アプリ群を同期し、全バイナリのビルド検証と単体テストを通す仕上げ処理。
これだけの機能を実装しようとすれば、当然ながらエージェントは「コードを書く ➔ swiftc や cargo でコンパイルする ➔ 厳格な型チェックや並行性(Sendable等)の警告が出る ➔ コードを修正して再ビルドする ➔ --self-test を走らせて境界値を検証する ➔ 実機UIを起動してレイアウトを確認する」というフィードバックループを何周も回すことになります。
その結果、標準記事1本なら約25回で終わる親API呼び出しが、Rust MCP改修(④)では 79回、Swift UI改修(⑤)では 129回、10ターン連続開発(⑦)では 親124回+子サブエージェント5体分の数十回 にまで膨れ上がっていました。APIを叩く回数が増えれば増えるほど、毎回積み上がった会話履歴(コンテキスト)がサーバーへ送信され続けるため、総通信量が桁違いに跳ね上がるのです。
実機確認の合間に起きるKVキャッシュ時間切れの直撃
そして、今回の生ログ解析で最も衝撃的かつ重要な発見となったのが、3つ目の原因である 「KVキャッシュ(Context Caching)の時間切れ(TTL失効)」と「母数膨張」の掛け算 です。
ここを正確に理解すると、なぜAIコーディングで急にクォータが溶けるのかが数学的にスッキリと腹落ちします。
さっきの一覧表を見ると、親エージェントの「キャッシュ有効率(Hit率)」は、記事作成が 94.0% で、10ターン連続開発が 86.4% だよね。たった 7.6ポイント しか違わないのに、どうして新規送信トークン(Fresh入力)が30万から607万へと 20倍 も増えちゃうの?
鋭い疑問です!「94.0%と86.4%なら大差ない」と思ってしまうのが最大の落とし穴なんですよ。私たちがクォータとして支払っているのは「キャッシュされた部分」ではなく、「キャッシュから漏れた残りの数パーセント(キャッシュミス率)」×「膨れ上がった総プロンプト量」 だからです!
Google AI 公式のコンテキストキャッシュ(Context caching)仕様 にある通り、直前のステップと同じ会話履歴を連続して送る場合、サーバー側のメモリ(KVキャッシュ)に載っているトークンは大幅な割引(API単価で約90%〜95%オフ相当)で高速に再利用されます。
しかし、キャッシュが効かなかった 「新規送信トークン(Fresh入力)」 には一切の割引が効かず、100%フル単価でTPUの計算枠(クォータ)を消費します。この Fresh 入力の量は、次の単純な数式で決まります。
この数式に、今回の「① 標準記事執筆(1本換算・推論)」と「⑦ 10ターン連続開発(親子合算)」の実測値を当てはめてみましょう。
※上記は親エージェントと子サブエージェント(またはSwarm)を含めたセッション全体の合算比率です。親単体で見ても、キャッシュミス率()は記事執筆の 6.0%()から、連続開発では 13.6%()へと 2.27倍に悪化 しています。
なぜ連続開発ではキャッシュミス率が2倍以上に悪化するのでしょうか?犯人は、人間が実機アプリを触って動作確認している合間に起きる「暗黙的キャッシュの時間切れ(TTL失効)」 です。
アプリ開発では、AIが1ターン目の実装を終えた後、人間が実際にMacアプリやブラウザを起動して「ボタンを押して数値が変わるか」「レイアウトが崩れていないか」「次は気象APIもつなごうか」とテスト・思考する時間が必ず入ります。Google AI 公式のコンテキスト キャッシュ仕様 において、通常チャットで自動適用される「暗黙的キャッシュ(Implicit Caching)」の正確な有効時間(何分何秒で消えるか)は非公開(不明)ですが、最大24時間の上限とは別にサーバーの混雑具合やメモリの空き状況に応じて数分〜数十分で動的に追い出される設計になっています。
そのため、実機テストで 5分〜15分程度のインターバル が空くたびに、Googleのサーバー上で保持されていた数十万トークンのKVキャッシュが時間切れ(TTL失効)で破棄されてしまいます(特に日本時間22時〜翌2時頃の米国稼働ピーク帯はサーバー負荷が高く、より早期にメモリから追い出されやすいと見られます[推論])。
その状態で人間が「次はここを直して」「この機能も追加して」と2ターン目、3ターン目の指示を送ると、それまで積み上がった 20万〜30万トークンの会話履歴が、キャッシュ割引ゼロの「100% Fresh入力」として丸ごと再課金(再計算)される のです!
この「放置後の継ぎ足しによるキャッシュ失効」がいかに恐ろしいかを証明する決定的な証拠が、同日の生ログにあった 「⑥ 記事継ぎ足し失敗例(371.5万 tok)」 です。標準の1ターン記事執筆と並べて比較してみましょう。
-
実行フロー :1ターン内で2本の記事をSwarm並列で一気に書き切る(または1本ごとに新規チャットを立ち上げる)。
-
キャッシュ挙動 :作業中に人間側の放置時間が一切挟まらないため、親キャッシュ有効率は
94.0%(ミス率わずか6.0%)をキープ。 -
新規送信量(Fresh入力) :2本合計で
60.0万 tok、1本あたり換算で 約30.0万 tok(推論)。 -
週間枠への影響 :1本あたり 約0.2%以下(推論)。何本書いてもゲージはほぼ動かない。
-
実行フロー :1本目(タイヤ空気圧記事)が完了した 27分後 に、同じチャットで「おねがい」と別テーマの2本目(室内遮光眼鏡記事)を追加依頼。
-
キャッシュ挙動 :27分の空白で1本目の履歴(約20万tok)のKVキャッシュが完全失効。さらに2本目の作業中ずっと 1本目の無関係な履歴まで毎ステップ引きずって送信。
-
新規送信量(Fresh入力) :親だけで 371.5万 tok(
3,715,181 tok) を消費し、標準記事1本比で 約12.4倍 に大爆発! -
週間枠への影響 :たった1本の追加記事で、本格的なアプリ開発1本分に匹敵するクォータを無意味に喪失。
この⑥の失敗例は、「プログラム開発だから減る」という以上に、「1つのチャットに履歴が溜まった状態で数分〜数十分の間隔を空けて追加指示(マルチターン継続)を出すこと自体が、KVキャッシュ失効と文脈引きずりの二重苦を引き起こす」 という事実を鮮烈に突きつけています。
先日の AIは新規チャットと継続どっちが節約?Pro・Ultra 5x・20xと規模別の正解 でも解説した通り、KVキャッシュが味方をしてくれるのは「同じテーマを間髪入れずに連続処理している数分間」だけです。実機確認や休憩で手が止まった後のチャット継続は、節約どころか最大の浪費トラップに豹変します。
思考トークン20倍増と複数言語コードの文脈膨張速度
さらに、4つ目と5つ目の原因である 「内部思考トークン(Thinking)の激増」 と 「複数言語コードによる文脈(母数)の膨張速度」 がダメ押しとなります。
Google AI 公式の Gemini Thinking(思考プロセス)仕様 および料金体系において、モデルが生成する 「出力トークン(Output tokens)」には、画面に表示される回答やコードだけでなく、回答前にモデルが内部で巡らせる推論トークン(thinking)が含まれます。そして、出力トークンの単価(Argon および11月末までの Carbon 特例で $10.00 / 100万tok、12月以降の Carbon 標準価格で $20.00 / 100万tok)は、通常の入力トークン($2.00 または $4.00)の 5倍、キャッシュ再利用された入力トークン(90%〜95%オフ)と比べれば 50倍〜100倍 も重く設定されています。
今回の生ログで、各セッションの「親子合算の出力トークン(思考含む)」を比較すると、その差は歴然でした。
-
① 標準の新規記事執筆(1本換算・推論) :親子合算で 約3.1万 tok(2本合計で親
55,322 tok+ Swarm Argon約6,500 tok)。定型化された構成テンプレートと事前カルテがあるため、モデルは迷うことなく最小限の推論トークンで一直線に原稿を出力できます。 -
④・⑤ 単発のRust / Swift改修セッション :Rust MCP改修で 13.2万 tok(記事比 4.3倍)、Swift UI改修で 17.2万 tok(記事比 5.5倍)。非同期処理のライフタイムやmacOSのウィンドウ階層を検証するため、内部推論が段階的に増えています。
-
⑦ 10ターン連続アプリ開発セッション :親
136,167 tok+ 子5体476,320 tok= 合算 61.2万 tok(記事1本比で 19.7倍!)。TypeScriptの計算ロジック、SwiftUIのレイアウト、気象APIのJSONパースとエラーハンドリング、テストケースの網羅など、124回の親APIコール+子エージェントの全ステップで深い内部推論(High Thinking)がフル回転し続けました。 -
⑧ アフィリエイト商品辞書492件×373記事の横断コード監査 :親+子4体で 合算 87.7万 tok(記事1本比で 28.3倍!)。数百件のオブジェクト定義と全記事の整合性を突き合わせる処理では、出力トークンだけで90万トークン近くに到達します。
加えて、5つ目の原因として 「プログラムコード特有の文脈膨張スピード」 があります。
日本語のブログ記事であれば、1本丸ごと書き出しても約1.5万〜2万トークン程度です。しかしアプリ開発では、TypeScriptのコンポーネント、Swiftのソースコード(数百〜数千行)、Rustのクレート構成、さらには swiftc や cargo build が吐き出す長大なコンパイルログやテスト結果が次々と会話履歴に流れ込みます。
その結果、⑦の10ターン連続開発では、親エージェントが送信した累積プロンプト量が 2,831.1万 tok、5体の子サブエージェントが送信した累積プロンプト量が 2,882.5万 tok、親子合わせた 総プロンプト送信量は実に 5,713.6万トークン(1記事換算約335万tokの約17倍) という途方もない規模に膨れ上がっていたのです。
絶対にやってはいけない改悪と開発クォータ半減の運用鉄則
ここまで5つの構造的原因を見てくると、「なるほど、Carbon (High) で連続開発すると20倍も減るのか。じゃあ、開発するときだけ軽いモデル(Hydrogen や Orchestrator、あるいは他社の軽量モデル)に切り替えればクォータを節約できるのでは?」と考える方がいるかもしれません。
しかし、当ラボの数百時間に及ぶ開発・監査ログから断言します。「クォータ節約のために開発モデルを軽量版へ格下げする」のは、絶対にやってはいけない最悪の改悪です。
軽量モデルへの格下げがバグ手戻りで逆に高くつく理由
なぜプログラム開発においてモデルのランクを落としてはいけないのでしょうか。それは、軽量モデルが引き起こす 「境界値バグ」や「並行処理の競合」による手戻りループの方が、単価2倍の差など一瞬で吹き飛ばすほど大量のクォータと時間を浪費するから です。
実際にシステム開発の現場で軽量モデルや中位モデルを使うと、一見すると綺麗に動くコードを一発で書いてくれたように見えます。ところが、いざ本番データや極端な入力値(エッジケース)を入れると、次のような「静かなバグ」が次々と噴出します。
-
符号なし整数や配列インデックスの未クランプクラッシュ :たとえば、テキストの行数やバイト境界を計算する処理で、
0や負数が来たときの.clamp()ガードやマルチバイト文字(UTF-8)の境界チェックをサボり、特定のファイルを読ませた瞬間にパニック(クラッシュ)を引き起こす。 -
非同期・マルチスレッド環境でのロック競合とゾンビプロセス :たとえば PlaywrightのPure Rust MCPサーバー自作録 で直面したような、複数エージェント同時起動時のプロファイルロック競合や、親プロセス終了時のブラウザプロセス残留(リーク)といった「並行性の罠」を見落とす。
-
「モグラ叩きデバッグ」による10ターン超の泥沼化 :バグが出るたびに「ここがクラッシュしたよ」「直したけど今度は別のテストが落ちたよ」と5ターン、10ターンと修正指示を繰り返すことになり、結局 5,000万トークン以上の文脈を引きずり回して週間クォータを大出血させる。
最上位の Gemini 4 Carbon (High) であれば、最初から「null・未定義・空配列・0バイトファイル・文字コード境界・非同期タイムアウト」といったエッジケースを1ターン目の内部思考(Thinking)で先回りして塞ぎ、自己テスト(--self-test)まで一発で通す堅牢なコードを書いてくれます。
つまり、「本番コードの開発・改修・監査は、親も子サブエージェントもすべて Gemini 4 Carbon (High) 一択で固定する」 という大原則は1ミリも曲げてはいけません。ここを妥協しないことが、結果として手戻りゼロ・最短ターンでの完走につながる最大の防御策なのです。
機能単位でチャットを切るマイルストーン分割の手順
では、Gemini 4 Carbon (High) の最高品質を100%維持したまま、開発時のクォータ消費だけを劇的に減らすにはどうすればいいのでしょうか。
答えは極めてシンプルです。⑦の連続開発セッションのように「記事執筆 ➔ Webツール実装 ➔ Swiftアプリ化 ➔ 気象API連携 ➔ 修正追撃」を 1つのチャットスレッドで10ターンもダラダラと続けないこと。すなわち、機能の区切り(マイルストーン)ごとに必ずチャットを新規作成して切り替える「マイルストーン分割」 を徹底することです。
1つのチャットで10ターン続けるのと、機能ごとに4つの新規チャットに分けるので、本当にそんなにトークン消費が変わるの?やる作業の合計は同じだよね?
やる作業はまったく同じでも、「後半のターンで毎回背負わされる過去の荷物(無関係になった履歴)」と「動作確認中のキャッシュ失効ダメージ」が劇的に減る んです!具体的なステップで比べてみましょう。
もし⑦の10ターン連続開発(Fresh 607.4万 tok)を1つのチャットに詰め込まず、以下の4つのマイルストーンごとに「新規チャット」へ切り替えていたらどうなっていたか、その実践フローを図解します。
まず1つ目のチャットで、ベースとなる技術記事(タイヤ空気圧とkPa換算の解説)を親 Carbon + Swarm Argon で一気書きして本番公開まで完了させます。ここでチャットAは即座に閉じます(Fresh消費:約30万 tok)。
新しいチャットBを開き、Web計算機コンポーネント(Astro / TypeScript)の実装とビルド検証だけを依頼します。記事本文の履歴(約20万tok)を一切背負わないため、超軽量なコンテキストで爆速完了します(Fresh消費目安:約70万〜90万 tok[推論])。
ブラウザでWeb計算機の動作をじっくり確認したら、元のチャットBには戻らず新しいチャットCを開きます。チャットBで完成したTypeScriptの計算式ファイルだけをSQLite経由で読み込ませ、SwiftUIアプリのビルドと --self-test を完遂します(Fresh消費目安:約80万〜100万 tok[推論])。
Macアプリの実機UIを触って「標高と気温の自動取得も足そう!」と思い立ったら、ここでまた新しいチャットDを開きます。完成済みのSwiftコードに対して通信モジュールを追加し、全アプリのミラー同期を行って完了です(Fresh消費目安:約80万〜100万 tok[推論])。
この4つのマイルストーン分割を実行した場合の合計 Fresh 入力は 約260万〜320万トークン(推論) に収まります。1つのチャットで10ターン連続開発した実測値(607.4万トークン)と比べて、開発品質や使ったモデル(オール Carbon High)は何ひとつ変えていないのに、クォータ消費だけを約半分(約50%削減)に抑え込める(推論) のです!
なぜここまで劇的に減るのか、理由は2つあります。
1つ目は、「前のフェーズの試行錯誤ログ(ビルドエラーの出力や途中経過の差分)を、次のフェーズへ一切持ち越さないから」 です。チャットCでSwiftアプリを作るときに必要なのは「チャットBで完成した最終版のTypeScriptコード(数千トークン)」だけであり、チャットBの途中で行ったやり取り(数十万トークン)は1ミリも必要ありません。
2つ目は、「人間が実機確認している合間のKVキャッシュ失効ダメージをゼロにできるから」 です。マイルストーンが完了して人間がアプリの動作確認に入った時点でそのチャットは「使い終わり(破棄)」になるため、5分後にキャッシュが切れようが30分後に切れようが、再課金される履歴自体が存在しないのです。
ローカルSQLite索引と母艦メモリが支える引き継ぎゼロ開発
ここで、熱心にAI開発を行っている方ほど、ある1つの現実的な疑問が浮かぶはずです。
理屈はすごくよく分かったよ!でもさ、機能ごとに毎回「新規チャット」に切り替えちゃったら、新しいチャットのAIは「さっきまでどのファイルのどの関数を作っていたか」を何も知らない状態から始まるよね?人間が毎回「さっきこういう仕様でこれを作ったから、次はここを読んで…」って引き継ぎプロンプトを書くのが面倒くさくない?
まさにそこが、普通のチャットAIと「ローカルSQLite索引を備えたエージェント開発環境」の決定的な違いなんです!手元のMac側でコードと設計書を常にSQLiteデータベースへ自動索引しておけば、新規チャットでも人間の引き継ぎ説明は文字通り「ゼロ」 になりますよ。
新規チャットでも過去経緯の説明が不要になる仕組み
なぜ多くの開発者が「同じチャットを10ターンも20ターンも続けてしまう」のかといえば、それは 「AIの短期記憶(チャットの会話履歴)を、プロジェクトの記憶装置代わりに使っているから」 です。チャットの履歴にしか仕様が残っていないから、新しいチャットを開くとまたゼロからファイルを探索させる羽目になり、それが億劫で古いチャットに継ぎ足してしまうのです。
当ラボではこの最大の障壁(ボトルネック)を解消するため、プロジェクト内の全ソースコード(TypeScript / Rust / Swift / シェルスクリプト)、全記事、設定ファイル、さらには関数・構造体のアウトライン(行番号マップ)を、ローカルの SQLiteデータベース(FTS5全文検索+構造化テーブル) に常時ミリ秒単位で同期する Pure Rust 製エンジン(kb-search)を稼働させています。
この仕組みがあると、新規チャットを開いた1手目の挙動が根本から変わります。
-
従来のチャット継続(記憶をクラウドの履歴に頼る方式) :前回のチャットで読み込んだ20万〜40万トークンの会話履歴を丸ごとTPUへ再送信しながら、「さっきのSwiftアプリに標高APIを足して」と指示する。人間は楽だが、キャッシュ失効のたびに数十万トークンの Fresh 入力が燃え続ける。
-
ローカルSQLite索引×新規チャット方式(記憶を手元のMacに持たせる方式) :新規チャットで「タイヤ空気圧のSwiftアプリに標高APIを足して」と一言だけ指示する。親エージェント(
Carbon)は1手目で./scripts/run_kb_search.sh code "TirePressure" --path swiftやtree swiftを叩き、わずか数ミリ秒で該当Swiftファイルの正確なパスと関数構造だけをピンポイント取得 して実装を開始する。 -
結果としてのトークン節約効果 :前回のチャットの試行錯誤ログ(30万トークン)は一切送られず、今必要な完成済みソースコードの数千トークンだけが Fresh 入力として読み込まれる ため、引き継ぎの手間ゼロで初手から最小のクォータ消費で走り出せます。
つまり、「長期記憶や文脈の索引は、高価なクラウドTPUのコンテキスト枠(KVキャッシュ)に置かず、手元のMacのローカルSQLiteとRAMDiskに置く」 という役割分担こそが、週間クォータを枯渇させない最強のアーキテクチャなのです。
時間経過後の再開と過去チャット検索の使い分け
ここでさらに一歩踏み込むと、「終了直後の手直しは元のチャットが得だとして、時間が経ってから同じ記事やアプリを直したいときも、元のチャットなら今までの履歴があるからゼロから調べ直させるより節約になるのでは?」と迷う場面があるはずです。
結論から言えば、人間の直感とは逆に、AIは前回の会話を頭の中で覚えているわけではなく 発言のたびに「そのチャットの1行目から今までの全記録(事前検索・思考プロセス・ビルドや本番転送ログを含む20万〜40万トークン)」を毎回丸ごとサーバーへ送り直して います。もし手元に検索基盤がない素の環境なら新規チャットで一からファイルを探し回るロスも起きますが、当ラボには ローカルSQLite索引(run_kb_search.sh)と ルール自動注入(GEMINI.md / GEMINI_MANUAL.md 連携)、さらに全会話ログを保持する /brain トランスクリプト検索 があるため、新規チャットの「思い出しコスト」そのものが極小化されています。
現在のAI環境(VS Codeの /brain や、Web版Geminiの過去チャット横断検索)を踏まえた実践的な切り替え基準は、次の3パターンに集約されます。
-
終了直後〜5分以内の「連続する手直し・追加訂正」は元のチャットを継続 :サーバー上のKVキャッシュが温まっている間は、20万〜40万トークンの履歴も約9割引き(当ラボ実測で
86〜94%再利用)で高速処理されるため、そのまま元のチャットで指示するのが最速・最安です。 -
VS Code(Antigravity)で5〜10分以上空いたら「壁打ち途中」でも例外なく新規チャット :成果物が
.mdxやコードとして保存済みならSQLite索引から完成ファイル(数千〜1万トークン)だけを引かせます。まだファイル化していない口頭の壁打ち途中であっても、Antigravityは全会話をローカルの/brain(transcript.jsonl)に記録しているため、新規チャットから直前チャットの質疑応答テキストだけを無劣化で抽出(kb-search brain)させた方が、数十万トークンのツール実行ログごと再送信するより圧倒的に節約になります。 -
Web版Gemini(チャットボット)の壁打ちも、時間経過・長文化したら「過去チャット参照」で新規へ :現在のWeb/アプリ版Geminiはチャットをまたいで過去の会話を検索・参照できるため、長くなった相談の再開は新規チャットで「さっきの〇〇の続きだけど」と呼び出す方が軽快です(時間経過後に元のチャットをそのまま続ける価値があるのは、Web版でまだ数往復と短く、過去チャット検索の自動要約で細かい数値や言い回しがこぼれるのを防ぎたい場合だけです)。
そして、この「ローカルSQLiteの即時インデックス更新」「RAMDisk上での高速キャッシュ処理」「Rust(cargo)やSwift(swiftc)の並列ネイティブコンパイル」「複数サブエージェントの同時稼働」を1秒の引っかかりもなく快適に回すために不可欠なのが、手元の開発母艦(Mac)のユニファイドメモリ容量と超高速SSD環境 です。
クラウド側のAIクォータをどれだけ節約しても、手元のMacがメモリ不足でスワップを起こし、SwiftやRustのビルドに毎回1分以上待たされていては、その待ち時間のせいで今度はクラウド側のKVキャッシュ(TTL)が時間切れを起こすという本末転倒な悪循環に陥ります。
-
ユニファイドメモリは最低32GB、本格並列なら64GB以上が鉄則 :Antigravity(Electronベース)+ブラウザ検証環境+ローカルSQLite+Rust/Swiftの並列コンパイル+RAMDisk(8GB〜16GB)を同時に常駐させると、16GBメモリでは確実にスワップが発生してビルド速度が低下します。64GB以上のユニファイドメモリがあれば、16GBのRAMDiskを切り出してもなお48GBの余裕が残り、コンパイルが一瞬で終わるため 「ビルド待ちによるKVキャッシュ失効」を物理的に防げます。
-
日割りコストの試算(推論) :たとえば約30万〜35万円クラスの64GBメモリ搭載Mac母艦を導入した場合、4年間(1,460日)毎日開発・執筆でフル稼働させれば 1日あたりの設備投資はわずか約205円〜240円(推論) です。コンパイル待ちのストレスが消え、AIクォータの無駄遣いまで防げる報奨(インセンティブ)を考えれば、最も費用対効果の高い投資となります。
これからAIエージェントを駆使してブログ運営とネイティブアプリ・Webツール開発の両方を本格的に回していく方に、当ラボが自信を持って推奨する開発母艦と超高速ストレージ構成は以下の3点です。
まず、コンパクトな筐体でありながらM4 Proチップと64GBの大容量ユニファイドメモリを搭載でき、RAMDisk運用とRust/Swiftの高速ビルドを余裕でこなせる高コスパ母艦が Apple Mac mini(M4 Pro / 64GBメモリ構成) です。
さらに、子サブエージェントを4〜6体同時に走らせる大規模な全件監査や、ローカルLLM・重いXcodeビルドまで一切の妥協なく並列処理したい方には、圧倒的なメモリ帯域と冷却性能を誇るフラッグシップ母艦 Apple Mac Studio が最良の選択肢となります。
そして、数万件の会話ログ(/brain)やSQLiteデータベース、大量のWebP画像資産やバックアップを内蔵SSDを圧迫せずに超高速で読み書きするなら、Thunderbolt接続で3,000MB/s級の爆速転送を維持できる高耐久ポータブルSSD SanDisk Professional PRO-G40 SSD(4TB) を組み合わせるのが鉄板です。
まとめ:記事と開発の燃費差を知れば週間枠は枯渇しない
今回は、「なぜブログ記事を何本書かせても減らないAIの週間制限(Weekly limit)が、アプリ開発に入った途端に半日で20%も溶けるのか?」という疑問に対し、同日12時間の全稼働セッション生ログを突き合わせて徹底検証しました。
最後に、明日からすぐ実践できるクォータ管理の鉄則を3つのポイントに整理します。
-
「記事執筆(30万tok)」と「連続開発(607万tok)」の20倍の燃費差を前提に週間スケジュールを組む :記事作成は単価半額の
Swarm Argonによる一気書きと94.0%の高キャッシュ有効率のおかげで、週間枠を0.2%以下(推論)しか使いません。一方、オールCarbon (High)で回るアプリ開発や全件コード監査は7.5倍〜26.6倍もの Fresh 入力と約20倍の思考・出力トークンを消費するため、1日に詰め込みすぎず計画的に配分しましょう。 -
実機確認や休憩で5分以上手が止まったら、同じチャットへの「継ぎ足し指示」を絶対に行わない :27分放置後に同じチャットへ2本目の記事を依頼しただけで Fresh 入力が371.5万トークン(12.4倍)に爆発した実測データが示す通り、KVキャッシュが切れた後のマルチターン継続は最大のクォータ浪費原因です。
-
開発モデルは
Gemini 4 Carbon (High)に固定したまま、「マイルストーン分割×ローカルSQLite索引」で消費を半減させる :クォータ惜しさに軽量モデルへ格下げすると、境界値バグの手戻りで逆に大損します。モデルは最高峰を維持したまま、「Web実装」「Swift化」「API連携」といった機能の区切りごとに新規チャットへ切り替え、手元のSQLite索引から完成コードだけをピンポイントで参照させましょう。
ぜひ手元の開発環境でも、動作確認の区切りごとに気持ちよく「+(新規チャット)」ボタンを押す習慣から始めてみてくださいね!
