AIに仕様書やプログラムを書かせる「AI主導の開発」が急速に広まっていますが、巷で語られる手法の多くは「どのAIモデルが賢いか」「どう指示文(プロンプト)を書くか」という表面的な話に終始しています。
しかし、実際に数百ファイル・毎日更新の規模でシステムやメディアを運用すると、プロンプトの工夫だけでは確実に破綻します。なぜなら、AIはチャットが変われば過去の決定事項をすべて忘れる(記憶喪失になる) うえ、人間が呼び出した瞬間しか動けず、複数チャットやエディタ操作が重なるとファイルやデータベースが競合して壊れる からです。
AI時代の開発手法において人間が本当に設計すべき土台は、①壊れない正本を作る「開発環境の整備(Astro×Git)」、②チャットが変わっても記憶を引き継ぐ「永続記憶の整備(自動ファイル保存×SQLite高速検索)」、③AIの手足と人間の計器盤を分ける「ツールの整備(Pure Rust×SwiftUI)」、④24時間の定例処理と安全を守る「バッチ運用・エラー監視・競合管理の整備」という4大基盤です。本稿では、当ラボ(地方雑記ラボ)が公開記事 790本(検証録 373本・AI国家構想 417本)と設計書 1,372行(約677KB)を日々無事故で回し続けている「AI開発4大基盤」の全設計と実測データを公開します。
-
AI自律開発の最適化7層総括|設計書3層分離・SQLite・Rust・Swarmの全設計図 : 4大基盤と11系統バッチ統制の全体入門である本記事に対し、トークン消費95%削減・Swarm分業・47,116回API生ログを深掘りした7層最適化の総括編です。
-
AI開発で増えすぎた56コマンドと仕様書を暗記ゼロで回す術|全角対応Rustランチャー×SQLite管理台帳 : 日常の運用コマンドを暗記不要で呼び出すランチャーと、SQLite直結コックピットの実装記録です。
-
Xserver生アクセスログ17.8万行とエラーログ解剖|API自動監視と4つの罠 : サーバーの生ログを自動回収し、AIクローラーの巡回状況や404エラーを早期検知する仕組みの解説です。
-
マルチエージェント516通り検証の真実!並列ブランチJudge選抜とAPI中継劣化・虚偽報告の防衛術 : 複数のAIエージェントを並列稼働させる際に、いかにして破壊的変更や品質劣化を防ぐかの実証録です。
-
Macアクティビティモニタの不満をSwiftUI自作で解消!1画面監視&重いアプリ冬眠ツール開発録 : 開発中のプロセス負荷やメモリ消費をリアルタイムで監視・制御する自作ネイティブツールの制作記です。
-
Geminiが過去会話を覚えている理由|パーソナルインテリジェンスとAI執筆術 : Web版Geminiの2段階記憶(自動要約メモリ×動的横断検索)で旧環境が混線する仕組みと、AIブログ執筆3類型を比較した検証録です。
-
AIコーディング支援ツール(Antigravity、Cursor、Claude Code等)を使っているが、チャットを新しくするたびに前提仕様を説明し直す手間に疲弊している方
-
複数のAIチャットを同時に走らせたり、自分でエディタを開いたりした際に、ファイルの先祖返りや保存競合(コンフリクト)を経験した方
-
AIに単発のコード生成だけでなく、日常のデータ収集・リンク切れ監査・バックアップなどの定例業務も安全に任せたい開発者・サイト運営者の方
-
数百〜数千ファイル規模になっても破綻しない、実務レベルの「AI時代の開発手法と環境構築」の具体例を知りたい方
AI任せの開発が記憶喪失と運用不全で破綻する理由
「AIに自然言語で指示するだけでアプリやサイトが作れる」という触れ込みで、いわゆるバイブコーディング(雰囲気で進めるAI開発)が流行しています。確かに、ファイル数が数個の小さな試作品(プロトタイプ)を作るだけなら、チャット欄に要望を打ち込むだけで形になります。
ところが、そのやり方のまま数週間・数ヶ月と運用を続け、ファイル数が数百〜数千に増えた途端、現場は必ず立ち行かなくなります。原因はAIモデルの性能不足ではなく、AIという仕組みが抱える構造的な3つの制約 にあります。
最初は「AIが全部コードを書いてくれるなんて魔法みたいじゃ!」と感動するんじゃけど、1ヶ月もすると「昨日直したはずのバグが別のチャットでまた復活しとる」「前に決めたルールを今のAIが全然知らん」いう泥沼にハマるんよな。

チャットが長くなるとAIの動作が重くなったり制限に達したりするから、どうしても新しいチャットを開きますよね。そうすると、さっきまであんなに阿吽の呼吸で動いていたAIが、いきなり「初めまして」の状態に戻ってしまうのが一番困ります。
チャットが変わると記憶を失う構造的な壁
AI開発における最大の落とし穴は、「どれだけ大量の背景データやルールをチャットで教えても、チャット(セッション)が変わればAIは何も覚えていない」 という冷徹な事実です。
大規模言語モデル(LLM)は、そのチャット枠の文脈(コンテキストウィンドウ)にある情報しか認識できません。新しいチャットを開いた瞬間、前回のチャットで3時間かけてすり合わせた「この変数は変更禁止」「見出しは30文字以内」「このコマンドはこういう手順で動かす」といった決定事項はすべて白紙に戻ります。
これを防ごうとして、巨大な仕様書ファイルを毎回チャット開始時に丸ごと読み込ませる人もいますが、ファイルが数千行に膨らむと今度は 「AIの作業机(コンテキスト)が開幕直後に満杯になり、肝心の推論精度が落ちて動作も遅くなる」 という二律背反(トレードオフ)に直面します。
呼ばれた瞬間しか動けない単発実行の限界
もうひとつの壁は、AIエージェントは 「人間がチャットで話しかけたターン(数分間)しか生存できない」 という点です。また、複数のチャットや人間の操作が重なったときの調整能力も持っていません。
-
チャット切り替えによる記憶喪失 : 過去の対話で決まった「使い方」「仕様」「再発防止策」がチャット枠の中に閉じ込められ、次のチャットへ引き継がれないため、同じミスや手戻りが永遠に繰り返されます。
-
24時間の定例運用と異常監視の不在 : AIは呼ばれた瞬間しか動けません。深夜のアクセスログ回収、Search Consoleの順位変動チェック、外部リンクの404死活監視、開発ツールの週次更新といった「日々の定例ルーチン」は、AIチャットの外側にバッチ環境を作らなければ絶対に回りません。
-
複数チャット・人間操作の競合による破壊 : 「チャットAで記事を書きながら、チャットBで共通定数を直し、人間がエディタでTODOメモを書き換える」といった並行作業を行うと、ファイルの上書き競合(先祖返り)やデータベースのロック衝突が起き、資産が壊れます。
従来の「プロンプト頼みの単発開発」と、当ラボが実践している「4大基盤による自律運用開発」の違いを比較すると、どこに設計の重心を置いているかが明確になります。
- 決定事項がチャット履歴に埋もれ、新規チャットで毎回記憶喪失になる
- 仕様書やコードを毎回丸読みし、トークン浪費とコンテキスト溢れを起こす
- 人間がエディタで直接ファイルを覗いて保存し、AIの編集と競合して壊れる
- 定例作業やエラー監視の仕組みがなく、問題が起きても放置される
- 決定事項を毎回ファイルへ自動保存し、SQLiteへ蓄積して次チャットも即利用
- AIはRust製コマンドで必要な箇所だけを数ミリ秒で検索し、丸読みゼロで動く
- AIはCUI(Rust)、人間は読み取り専用GUI(Swift)に分離し保存競合を根絶
- 日常の11系統ルーチンをRustバッチ化し、稼働監視・エラー検知・順番待ちを自動化
つまり、AI時代の開発手法とは「AIにどう上手くお願いするか」ではなく、「記憶喪失になりやすく、呼ばれた時しか動けず、競合に弱いAIというエンジンを、いかに強固な4つの外骨格(インフラ基盤)で包み込むか」 というシステム工学そのものなのです。
- バッチ運用 : 日次・週次・月次の定例処理11系統を自動実行し、次回予定と履歴を可視化
- エラー監視 : macOS権限エラー(TCC)や404増加、コンパイラ初期バグを検知して自動保護
- 競合管理 : 複数AIチャットの同時実行を排他ロックで制御し、順番待ち(wait-turn)で衝突防止
- AI用の手足(Pure Rust) : 型消去のない単一バイナリで、記事検問・全文検索を4msで完遂
- 人間用の計器盤(SwiftUI) : 全7タブを866.5msで読み取り専用表示し、エディタ保存競合を遮断
- 自動ファイル保存 : 対話で決まった「使い方・仕様・知見」を指示待ちせず自動で文書へ記録
- SQLite(WAL+FTS5) : 保存データを全文検索DBへ即時同期し、次チャットのAIもミリ秒で参照
- プレーンテキスト正本(Astro MDX) : 動的DB密結合を捨て、AIが正確に差分編集・型検証できる構造
- Git(fsmonitor+自動退避) : 常駐デーモンで変更を即座に捉え、1秒で無傷の状態へ巻き戻し可能
ここからは、この4大基盤を具体的にどう設計・実装し、日々の運用でどう動かしているのかを下層から順番に解説します。
開発環境の整備:AstroとGitで作る壊れない正本
すべての土台となる第1基盤は、AIが読み書きする「正本(ソースコードと原稿)」の置き場所です。ここで選ぶ技術スタックを間違えると、その上にどれだけ高度な仕組みを作っても砂上の楼閣になります。
動的DBを捨てプレーンテキスト正本にする利点
かつてWebサイトやブログの構築といえば、WordPressのように「MySQLなどの動的データベースの中に記事本文も設定も詰め込む方式」が主流でした。しかし、AIと共に開発・執筆を進める時代において、動的データベース密結合のシステムは非常に相性が悪いという弱点があります。
データベースの奥深くにHTMLタグ混じりの文字列として格納されたデータは、AIから直接差分(diff)を見ることができず、書き換えに失敗してもどの行がどう壊れたのかを即座に検証できないからです。
そこで当ラボでは、すべての記事(現在 790本)とコンポーネントを、Astro公式が提唱するコンテンツ駆動アーキテクチャ に基づくプレーンテキスト(.mdx / .astro / .ts)としてローカルのSSDやハードディスク(記憶装置)上に管理しています。
-
AIが1行単位で正確に差分を読み書きできる : すべての原稿と画面部品がテキストファイルとして存在するため、AIは変更が必要な数行だけを正確にピンポイント編集できます。
-
静的ビルドが最強の事前検問になる : データベースを本番サーバーで動的に読み出すのではなく、手元のMacで静的HTMLへとビルド(変換)してから転送します。もしAIがフロントマターの型や画像のパス、コンポーネントの閉じタグを1箇所でも間違えれば、ビルドの時点で即座にエラーとして弾かれるため、壊れた画面が本番に出ることがありません。
-
本番サーバーの攻撃対象領域(アタックサーフェス)が極小化する : 本番環境には生成済みの静的ファイル(HTML/CSS/WebP画像)だけを配置するため、データベースの脆弱性を突かれるリスクがなく、表示速度も極限まで高速化できます。
そして、ビルドした静的ファイルを配信する本番環境には、安定性と生アクセスログ・エラーログのAPI取得機能を備えた国内レンタルサーバーの定番「エックスサーバー(XServer)」を使っています。静的HTML配信の速さに加え、後述する第4基盤(深夜の生ログ自動回収と404エラー監視バッチ)を回すうえで、API経由で生ログを確実に引き出せる環境が大きな強みになります。
エックスサーバー(XServer)国内シェアNo.1 高速・高安定レンタルサーバー
第5世代AMD EPYC™&全ストレージNVMe RAID10構成。WordPressクイックスタート対応はもちろん、Astro等の完全静的HTML高速配信の母艦としても抜群の安定性と緊急セキュリティ即応力を誇ります。
Gitの高速監視と自動退避で誤編集を即座に戻す
プレーンテキストを正本にするもうひとつの大きな恩恵は、すべてのファイル変更を Git で1文字単位まで追跡・巻き戻しできること です。
ただし、画像や記事を含めて数千〜数万ファイル規模になると、git status で変更ファイルを探すだけでもSSD全体の走査に時間がかかり、AIやバッチ処理の足を引っ張る最大の障壁(ボトルネック)になります。
そこで当ラボでは、Git公式のファイルシステム監視デーモン(git-fsmonitor–daemon) を有効化しています。これにより、macOSのファイル変更イベント(FSEvents)をOSレベルで常時待ち受け、AIがどのファイルを書き換えたかをミリ秒単位で即座に検知できるようにしました(導入手順と高速化の実測値は macOSのGit更新とfsmonitor高速化・Rust自動更新機の構築録 で詳しく解説しています)。
さらに、複数ファイルにまたがる改修を行う際や本番環境へ転送する際には、手動での操作ミスを防ぐため backup_manager.sh と自動コミット処理をパイプラインに組み込んでいます。万が一AIが意図しない編集を行った場合でも、1秒で変更前の無傷な状態へ復元できる安全網が第1基盤の要です。
永続記憶の整備:ファイル保存とSQLite高速検索
第1基盤で壊れない作業場を作ったら、次は第2基盤である 「AIの記憶喪失をどう克服するか」 という核心課題に踏み込みます。
どれだけ優秀なAIモデルを使っても、チャットが変われば記憶はゼロになります。したがって、AI時代の開発手法で最も重要なルールは 「チャットの中で決まった大切なことは毎回必ずデータとしてファイルに保存し、チャットが変わっても次のAIがその保存したデータを使うことができる仕組みにする」 ことです。
もちろん近年は、Web版の Gemini や ChatGPT などにも、過去チャットの自動要約メモリや横断検索(パーソナル インテリジェンス等)が導入されています。しかし、クラウド側の自動メモリには 「すでに移行した古いモデル名や旧環境の設定が遅れて残り続け、最新仕様と混線する」「自動要約の過程で正規表現や数値上限などの厳密な条件が抜け落ちる」「ローカルの開発エディタや定期バッチ処理からは直接参照できない」 という構造的な限界があります。
そのため、1ビットの狂いも許されない開発仕様の正本(Single Source of Truth:唯一の正しい情報源)は、クラウドの曖昧な要約任せにするのではなく、手元のローカルファイルと SQLite で確定的に管理しなければなりません(Web版Geminiの2段階メモリ構造と旧情報混線の実例については Geminiが過去会話を覚えている理由|パーソナルインテリジェンスとAI執筆術 で詳しく検証しています)。
チャット変更に備え決定事項を自動で残す仕組み
人間の開発者でも、口頭で話し合っただけの仕様は3日経てば忘れます。ましてやチャット単位で記憶がリセットされるAIならなおさらです。
そこで当ラボでは、AIの基本行動ルール(憲法)として 「対話や作業の中で新しく決まった①使い方(コマンド・運用手順)、②仕様(CSS・DB構造・記事ルール・定数)、③大事なこと(不具合の真因と再発防止策)は、人間から『保存して』と指示されるのを待たず、作業完了前に必ず自動で管理ファイルへ書き込んで永続化する」 という鉄則を課しています。
しかも、1つのファイルに無秩序に書き足していくと肥大化して管理できなくなるため、役割に応じて以下の「3層+定数・課題ファイル」へと整理して保存させています。
-
共通原則マスター(
GEMINI.md:現在 1,372行・約677KB) : どの作業でも必ず守るべき基本姿勢、文体ルール、コマンドの基本作法を記録します。 -
核心公理マスター(
GEMINI_AXIOMS.md) : ブログ全体の思想や制度設計の根幹となる24の公理(変更すると他記事へ連鎖する重要前提)を番号付きで管理します。 -
詳細技術マニュアル(
docs/GEMINI_MANUAL.md/docs/SQLITE_FUNCTIONS_MANUAL.md) : スクリプトの細かい引数、トラブルシューティングの履歴、データベースのテーブル定義など、必要な時だけ辞書として引く詳細仕様(全44節)とSQLite関数マニュアル(全15節)を蓄積します。 -
共通定数マスター(
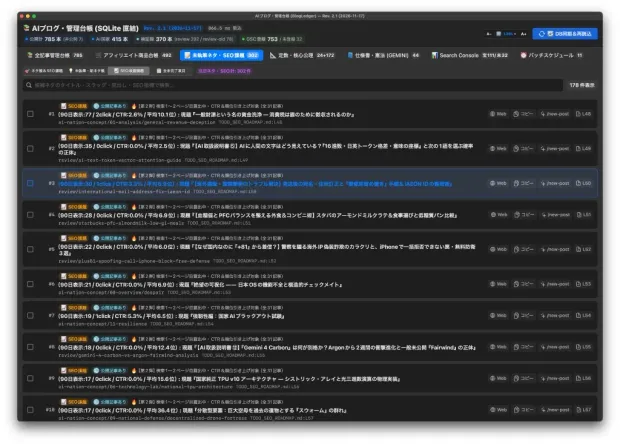
src/consts.ts)と課題管理(TODO_SEO_ROADMAP.md等) : 記事数や検証データの数値(172件)はコード定数として一元化し、対話の中で見つかった未解決課題や執筆ネタ(302件)は優先度付き課題として即座に記録します。
実際に、こうして日々ファイルへ自動保存されている「定数・核心公理」や「未執筆ネタ・SEO課題」がどのように構造化されているか、当ラボのネイティブ管理台帳(BlogLedger)の画面で見てみましょう。
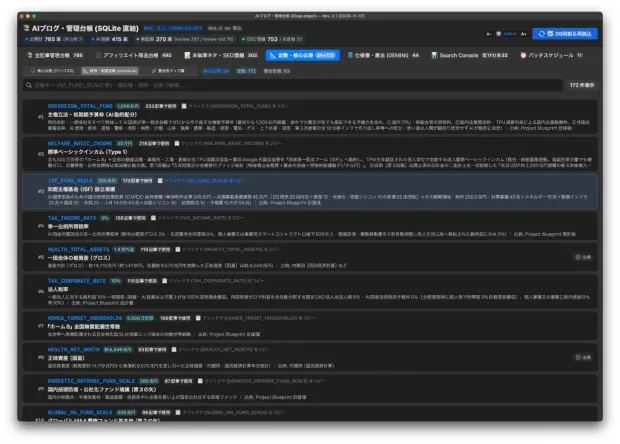
上の画面(第4タブ「📐 定数・核心公理」)にあるとおり、SITE_TOTAL_POSTS(790記事)や GEMINI_MD_LINES(1,372行)といった172個の定数と、24個の核心公理(および整合性鎖53本)がすべてデータとして保存されています。数値が変わったときはこの定数1箇所を更新するだけで、サイト内の全記事の表示が自動更新されます。
さらに、日々の壁打ちやシステム監査で見つかった課題や記事ネタも、チャットの場限りで流さず第3タブ「📝 未執筆ネタ・SEO課題」の原稿データ(TODO_SEO_ROADMAP.md 等)へ自動で書き残されます。
このように、「チャットで話した決定事項はすべて構造化されたファイルデータとしてSSDやハードディスク(記憶装置)に定着させ、チャットが変わっても次のAIがその保存したデータを使うことができる仕組みにする」 ことで、明日まったく新しいチャットを開いても、あるいは数ヶ月後に別のAIモデルへ切り替わっても、過去の全知見を1ビットも失わずに引き継ぐことができます。
SQLite全文検索でAIがミリ秒で記憶を引く
しかし、データをファイルに保存しただけでは、まだ半分しか解決していません。
保存されたデータが 記事 790本、マニュアル数千行、課題 302件、過去の壁打ち履歴数万ターン という規模に育つと、新しいチャットのAIが「どのファイルの何行目に必要な情報があるか」を探すためにファイルを片っ端から丸読み(read_file)し始め、あっという間にコンテキスト上限に達してしまうからです。
この最大の障壁(ボトルネック)を突破するため、当ラボでは 「ファイルに保存したすべての記憶データを SQLite データベースへ自動インデックス化し、AIにはファイル丸読みを禁じて SQLite の全文検索で必要な行だけを数ミリ秒で引き出させる」 という仕組みを構築しました。
具体的には、SQLite公式のWAL(Write-Ahead Logging)モード によって書き込みと高速な並行読み取りを両立させつつ、SQLiteのFTS5(全文検索拡張) を使って、管理文書の見出し階層・コードの関数定義・全記事の段落・GSC検索クエリ・過去チャット履歴までを知識データベース(_local_db/knowledge.sqlite および conversations.sqlite)に格納しています(ファイル丸読みゼロ化の全貌は AIエージェントのAnalyzedゼロ化とSQLite全文検索インデックス構築ガイド を参照してください)。
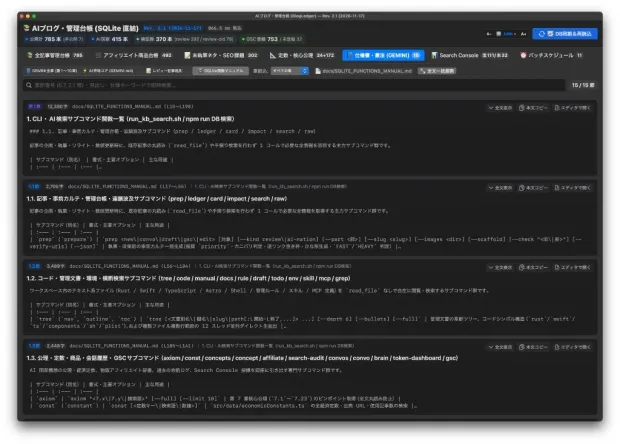
上の第5タブ「📘 仕様書・憲法 (GEMINI)」内の「SQLite関数マニュアル」サブタブに並んでいるように、長大なマニュアルもSQLiteのテーブルへ章節単位で分解されて入っています。
新しいチャットで起動したAIは、ファイルを頭から読む代わりに ./scripts/run_kb_search.sh manual "節番号" や todo --pending、prep new "テーマ" というコマンドを1回叩くだけで、わずか4〜10ミリ秒で「今必要な記憶の断片と前後数行のコード」だけをピンポイントで取得 できます。
なるほどねぇ!人間に例えるなら、引き継ぎノートを毎日きちんと書いておくだけじゃなくて、そのノートに超高速な「電子索引(インデックス)」をつけておくようなものね。それなら新しく来た担当者(新しいチャットのAI)も、分厚いノートを1ページ目から全部めくらなくて済むわ!

「大切な決定は毎回ファイルに保存する」という習慣と、「保存したデータをSQLiteに入れて高速検索させる」という仕組みがセットになって初めて、チャットが変わってもAIが昨日の続きから迷わず動けるようになるんだね。
ツールの整備:Rustの手足とSwiftの計器盤分離
第1基盤(Astro×Git)と第2基盤(ファイル保存×SQLite)が整ったら、第3基盤として 「その環境と記憶を扱うための専用ツール」 を整備します。
ここで当ラボが徹底している設計思想は、「AIが使うCUIツール(手足)は Pure Rust で作り、人間が全体を見渡すGUIツール(計器盤)は SwiftUI で作り、両者を完全に分離する」 という役割分担です。
型消去を断ちミリ秒で検問するPure Rust
多くの開発現場では、AI用の補助スクリプトや検査ツールを Node.js(JavaScript / TypeScript)や Python で書いています。しかし、運用規模が大きくなるにつれて、これらのスクリプト言語には2つの深刻な弱点が露呈します。
1つ目は 「起動の遅さ(ランタイム負荷)」 です。AIがファイルを編集するたびにフック(自動検査)として Node.js や Python を起動すると、ランタイムの初期化だけで数百ミリ秒〜数秒かかり、何十回もツールを呼ぶうちに大きな待ち時間になります。
2つ目は 「型消去による実行時エラーのすり抜け」 です。TypeScript は実行時にはただの JavaScript に変換(型消去)されるため、データの欠損や想定外の undefined が本番実行時まで発覚しない事故が起きます。
そこで当ラボでは、過去に約26,000行あった JavaScript / Python スクリプト群をすべて解体し、Rust公式の所有権(Ownership)と厳格な型システム を持つ Pure Rust のネイティブ単一バイナリ2本(憲法検問エンジン gemini-gate と高速検索エンジン kb-search) へと完全統合しました(移行の裏側は JavaScript型消去の罠と26,000行監査・Pure Rust完全統一の記録 で詳述しています)。
-
わずか4ミリ秒の即時機械検問 : AIが記事やコードを保存した瞬間、RAMDisk上に常駐配置された
gemini-gateが約4msで起動し、見出し文字数(H2は30文字以内・H3は26〜28文字以内)、太字**外側の半角スペース、リンク切れ、孤立記事、画像サイズまで数十項目の「憲法ルール」を機械検問します。 -
人間の暗算や目視チェックをゼロにする : AI自身に「文字数を数えて」「変更禁止箇所が変わっていないか目視で確認して」と頼むと必ず数え間違いを起こします。機械的に判定できるルールはすべて Rust バイナリへオフロードし、1件でも違反があればデプロイを物理的に止める構造にしています。
-
管理文書のアトミック更新とSQLite即時同期 :
gemini-gate edit-docコマンドを介することで、ファイルの書き換えと同時に SQLite データベースの再インデックス化までがミリ秒単位で一気通貫に完了します。
Rust の所有権モデルやエラーハンドリング、高速なテキスト処理・並行処理の設計を体系的に押さえておくには、オライリーの定番書『プログラミングRust 第2版』が手元に1冊あると、AIに Rust ツールの仕様を指示する際の解像度が格段に上がります。
保存競合ゼロで全資産を覗くSwift製管理台帳
AIの手足として Rust 製の高速CUIツールを整える一方で、「人間(筆者)がプロジェクトの現状を確認するためのツール」 にはまったく別の配慮が必要です。
なぜなら、AIがバックグラウンドやチャットでファイルを書き換えている最中に、人間が VS Code などのテキストエディタで同じファイル(たとえば TODO.md や consts.ts、記事ファイル)を開いていると、エディタ側の自動保存やうっかり保存によってAIの変更を上書きして消してしまう「保存競合(FILE_MODIFIED_SINCE エラーや先祖返り)」 が頻発するからです。
かといって、人間が現在の記事一覧やアフィリエイト登録状況、TODOの残件を確認するたびにエディタでファイルを開くわけにもいきません。そこで開発したのが、Apple公式のSwiftUIフレームワーク で構築した macOS ネイティブの読み取り専用コックピット 「BlogLedger(ブログ総合管理台帳)Rev. 2.1」 です。
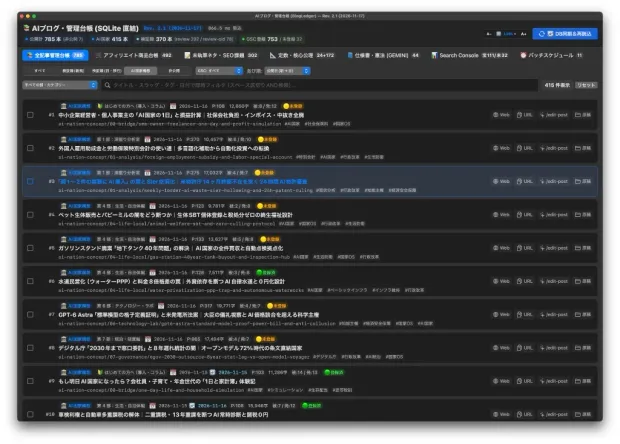
上の画面(第1タブ「📚 全記事管理台帳」)の上部タイトルバー横の表示に注目してください。866.5 ms 読込 という実測値のとおり、SQLite(_local_db/knowledge.sqlite)と接続し、全 790本 の記事メタデータ・文字数・被リンク/発リンク数・GSC登録状態から全7タブ分のデータまでを、1秒未満(約0.87秒)で一気にメモリへ読み込んで表示 します。
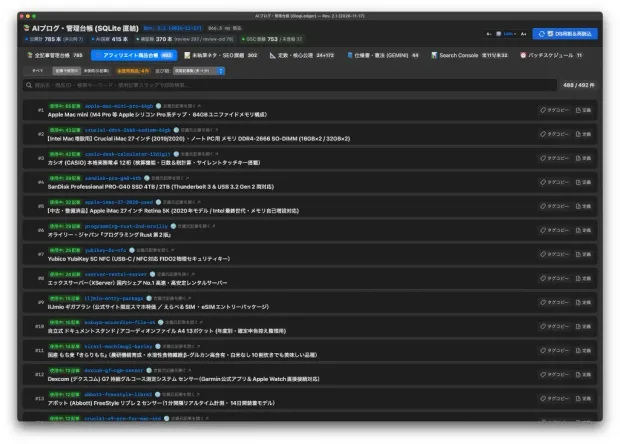
第2タブ「🛒 アフィリエイト商品台帳」では、登録済みの商品カード492件について「何本の記事で使われているか(未使用の孤立カードがないか)」「どの記事ファイルで定義されているか」を一目で俯瞰し、ワンクリックでタグをコピーできます。
さらに、マシン全体の負荷監視用として同じく SwiftUI で自作した常駐モニターアプリ 「CoreMonitor(Rev. 1.3)」 には、AI開発に特化した「開発プロセス絞り込みフィルタ(astro / rust / sqlite / playwright / git 等)」を搭載しており、AIが裏で走らせているビルドやブラウザ検証プロセスが暴走していないかを常時監視できます。
-
エディタ保存競合の完全根絶 : 人間はテキストエディタで管理ファイルを開かず、
BlogLedgerから読み取り専用(Read-Only)で全資産を閲覧するため、AIの書き込みと人間のエディタ保存が衝突する事故が物理的にゼロになります。 -
SQLiteを介したリアルタイム連携 : AIが Rust ツールで記事や課題、定数を更新すると、即座に SQLite が更新されます。人間は
BlogLedgerの「🔄 DB同期&再読込」ボタンを押すだけで、0.87秒後には最新の全体像を把握できます。 -
ブラウザやElectron製ツールのようなメモリ圧迫がない : macOS ネイティブの SwiftUI で組まれているため、常時起動しておいてもメモリ消費が極めて少なく、AIやローカルビルド用の貴重なメモリを奪いません。
バッチ環境と運用統制:監視・エラー検知・競合管理
第1〜第3基盤によって、AIが記憶を引き継ぎながら高速かつ正確に開発できる環境が整いました。そして最後にして最大の要となる第4基盤が、「人間がチャットで指示していない24時間365日の定例処理をどう回し、エラーや競合をどう防ぐか」 という バッチ環境と管理体制(ガバナンス) です。
冒頭で触れたとおり、AIチャットは呼ばれた瞬間しか動けません。そのため、日常の定例業務は Pure Rust でコンパイルした高速バッチ群を macOS 標準の launchd(LaunchAgents)や定期スケジュールに登録して自動実行 させ、それを以下の 3つの仕組み(①バッチ運用、②エラー監視、③競合管理) で統制しています。
日常の11系統ルーチンを回すバッチ運用台帳
バッチ処理を裏で動かしていると、必ず「今どのバッチが登録されていて、直近いつ動いて、次はいつ動くのか?」「今すぐ手動で1回だけ動かしたいときはどうするのか?」という運用上の課題が出てきます。
設定ファイル(.plist)がフォルダの奥に散らばっているとブラックボックス化するため、当ラボでは BlogLedger の第7タブ「⏰ バッチスケジュール」に全11系統の稼働状況・JST(日本標準時)での次回実行予定・ワンクリック手動実行ボタン(「▶ 今すぐ実行」)を集約 しています。
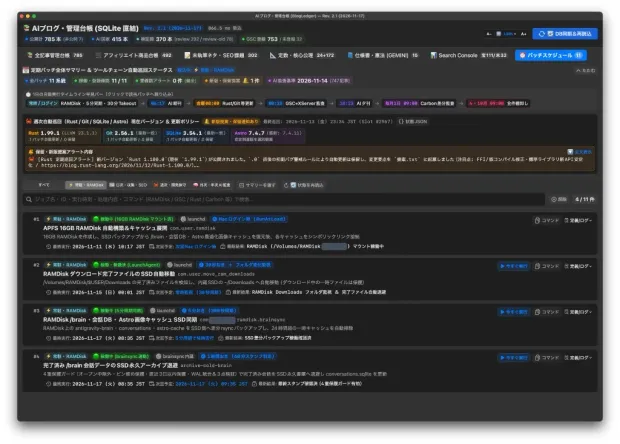
現在、当ラボの母艦Mac上で自律稼働している全11系統のバッチと定期監査スケジュールの役割は以下のとおりです。
| # | スケジュール・バッチ名 | 実行基盤 | 実行周期・タイミング | 主な処理内容と守っている領域 |
|---|---|---|---|---|
| 1 | APFS 16GB RAMDisk 自動構築&キャッシュ展開 | launchd |
Macログイン時 | 16GB RAMDisk作成・会話DBやAstro画像キャッシュを復元してシンボリックリンク接続 |
| 2 | RAMDisk ダウンロード完了ファイルのSSD自動移動 | launchd |
30秒おき+フォルダ監視 | RAMDisk上の完了済みファイルを検知し内蔵SSDの ~/Downloads へ自動退避 |
| 3 | RAMDisk /brain・会話DB・キャッシュ SSD同期 |
launchd |
5分おき(300秒周期) | RAMDisk上のAI会話ログ・DB・ビルドキャッシュをSSD側へ差分 rsync バックアップ |
| 4 | 完了済み /brain 会話データのSSD永久アーカイブ退避 |
brainsync 内蔵 |
1時間おき(60分判定) | 4重保護ガードで完了済み会話をSSD永久書庫へ退避し conversations.sqlite を更新 |
| 5 | Google Takeout 会話履歴 自動取り込み&SQLite同期 | launchd |
30分おき+監視 | 新規 Takeout ZIP を検知・展開して会話DBへ自動反映(未更新時は0.05秒で即終了) |
| 6 | 一次情報RSS × Gemini API 朝刊・夕刊自動収集 | launchd |
毎日 06:17 / 18:23 JST | 一次情報フィードを巡回し朝刊・夕刊レポートと記事下書き候補を自動生成 |
| 7 | Search Console 定期診断 & XServer生ログ自動監査 | launchd |
毎日 08:15 JST+ログイン時 | GSC指標・インデックス差分検査とXServer生ログ5万行解析で 不具合.txt 等を更新 |
| 8 | Rust / Astro / SQLite / Git 週次巡回&安全更新 | Rust週次スロット | 毎週金曜 08:00 JST以降 | .1 以降の修正パッチを自動更新+自己テスト実行(.0 初版は初期バグ警戒で保留) |
| 9 | Git 2.56 バックグラウンド保守 & FSMonitor常駐 | Git launchd |
毎時・毎日・毎週 | commit-graph 更新やオブジェクト再パックを自動実行し git status 30ms台を維持 |
| 10 | 月次ハルシネーション差分監査(Carbon High) | Antigravity Cron | 毎月1日 09:00 JST | 前回監査以降の新規・更新記事を抽出し、一次情報裏取りと「推論」表記を差分監査 |
| 11 | 年2回 全記事ハルシネーション・法改正棚卸し監査 | Antigravity Cron | 毎年4月・10月15日 09:00 | 法改正・制度改定が一巡する春・秋に全公開記事の統計年次・省庁名・出典死活を総点検 |
これだけの定例バッチと、16GBのAPFS RAMDisk、常駐Rustバイナリ、複数AIエージェント、実機ブラウザ検証をクラウド費用ゼロ(完全ローカル)で余裕をもって同時稼働させるには、母艦のメモリ容量が決定的な鍵を握ります。当ラボではメモリを64GBへ増設した27インチ 5K iMac(iMac20,1)を母艦にし、64GBのうち16GBをRAMDiskに割り当ててSSDの書き込み寿命(TBW)を保護していますが、これから現行のAppleシリコン機で同等の64GBローカル開発母艦を組むなら 64GBユニファイドメモリ構成の Mac mini(Pro系チップ) が最も費用対効果に優れた選択肢になります。
無言停止と初期バグを防ぐエラー監視の仕組み
バッチ処理を自動化して放置すると、必ず直面するのが 「いつの間にかバッチが止まっていた(サイレント障害)」「自動アップデートで開発環境が壊れた」「本番サーバー側でリンク切れが起きていた」 という3つの運用リスクです。
当ラボでは、こうした異常を早期に検知してシステムを保護する「エラー監視(異常検知と予防防御)」を第4基盤に組み込んでいます。
-
macOS TCC権限拒否による「無言滞留」の回避設計 : macOSの
launchdから標準シェル経由で~/Desktop配下へアクセスしようとすると、OSの保護機構(TCC:Operation not permitted)に阻まれて無言で同期が止まる事故が起きます。そのため、定期バッチの実行実体は/Users/Shared/bin/等へ配置して権限境界を明確化し、BlogLedger第7タブのステータスバッジ(要確認アラート)とログ確認ボタンで常時監視できる設計にしています。 -
コンパイラ等の「.0 初期リリースバグ」自動更新保留と提案起票 : 開発ツールを無条件に自動アップデートすると、初期バグを踏んでビルドが通らなくなる事故が起きます。そこで週次巡回バッチには 「メジャー・マイナー直後の
.0リリース(第7タブ画面のとおり、実際に公開されたRust 1.100.0を検知して現在のRust 1.99.1を維持)は初期バグ警戒ルールにより自動更新を保留し、変更要点を提案.txtへ自動起票する」 という安全弁を持たせています。 -
GSCインデックス状況とサーバー生ログ(404・AIクローラー)の統合監視 : 記事を公開して終わりではなく、Google Search Console のインデックス登録率やサーバー生ログの HTTP 404 エラーを毎日自動集計し、
BlogLedgerの第6タブ「📊 Search Console」から即座に点検できるようにしています。
実際に、毎朝の定期バッチが集計した Search Console データとサーバー生ログがどのように監視されているかを示したのが、以下の第6タブ画面です。
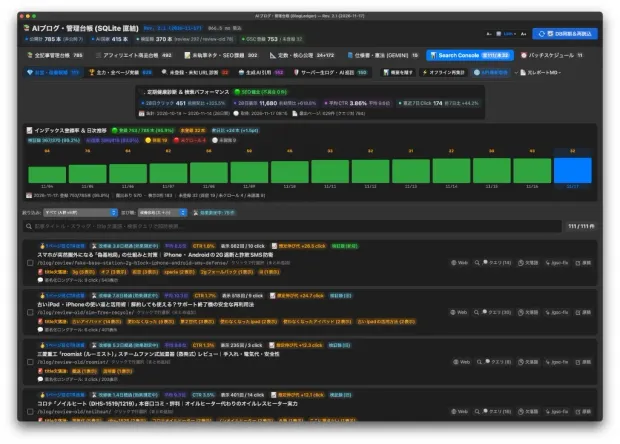
画面上部のサマリーカードにあるとおり、直近28日間のクリック数(451:前期比 +325.5%)、表示回数(11,680:前期比 +618.8%)、平均CTR(3.86%)、平均掲載順位(9.6位)、そして インデックス登録率 95.9%(753/785本登録済・未登録32本) が一目で分かります。さらに画面中段のサブタブを切り替えると、「💎 お宝・改善候補(111件)」「🌐 主力・全ページ実績(629件)」「🔍 未登録・未知URL診断(32件)」「🤖 生成AI引用(142件)」「📡 サーバー生ログ・AI巡回(150件)」までを同じウィンドウ内で即座に追跡できます。
複数AIチャットの衝突を防ぐ競合管理と順番待ち
そして、AI開発が軌道に乗った開発者が最も頻繁に遭遇する事故が 「複数のAIチャットやバッチ処理を同時に動かしたときの競合(コンフリクト)」 です。
たとえば、「ウィンドウAのAIに新記事の執筆と本番転送を任せながら、ウィンドウBのAIに過去記事のSEO改善を指示し、同時に裏で定時バッチがSQLiteを更新する」といった状況は日常茶飯事です。このとき何の制御もなければ、Gitのコミット衝突やSQLiteのロックエラー、管理文書の先祖返りが起きて現場は大混乱に陥ります。
これを防ぐため、当ラボでは 「管理文書のアトミック更新」「SQLiteの3重読み取り専用ガード」「複数AIチャット同時稼働時の排他リースロックと自動順番待ち(wait-turn)」という3重の競合管理 を実装しています。
-
管理文書の直接編集ブロックと
edit-docアトミック更新 :GEMINI.mdや課題管理ファイルなどの共通管理文書に対して、AIが通常のファイル編集ツール(edit_file/write_file)を使うことを実行前フック(PreToolUse)で物理的にブロックしています。更新は必ず Rust 製gemini-gate edit-docを経由させ、排他制御のもとで書き換えと SQLite 同期を不可分(アトミック)に実行させます。 -
SQLite の
PRAGMA query_only = ON等による3重読み取り専用ガード : 検索ツール(kb-search)や人間の管理台帳(BlogLedger)が SQLite を開く際は、読み取り専用フラグとquery_only = ONを強制し、万が一にも閲覧側からデータベースが書き換えられたり書き込みロックを妨げたりしない構造にしています。 -
複数AIチャットの排他リースロックと
wait-turn自動順番待ち : 複数のAIチャットが同時に記事編集やfinish・本番環境転送を実行しようとした場合、エラーで異常終了させるのではなく、Rust 製のワークフロー排他リース機構(_active_gsc_lease.json)とkb-search wait-turnコマンド(RAIIガード付き)によって 「先行チャットの転送が終わるまで後続チャットがFIFOキューで自動順番待ちし、完了と同時にバトンを受け取って自動で処理を再開する」 仕組みを実装しています。
この「複数AIチャット同時稼働時の排他ロックと自動順番待ち」がどのように動くかを整理したのが、以下のフロー図です。
先行するチャットAが仕上げ・本番転送に入ると、PIDと生存確認付きの排他ロックを取得して処理を進めます。
同時にチャットBが処理を開始してもエラーで落ちず、待機ガードが働いてチャットAの完了を静かに待ちます。
ロック解放と同時にチャットBが自動で動き出し、最新のGitとSQLiteを引き継いで上書き競合ゼロで完遂します。
これまでは、1つのチャットが本番転送しとる最中は「今もう1つのチャットを動かすとGitが競合して壊れるけん、終わるまで手を止めとこ…」って人間が気を使っとったけど、AI同士が自分で順番待ちしてくれるんなら安心じゃな!
しかも、もし先行していた処理が万が一フリーズして止まってしまった場合でも、PID(プロセスID)の生存確認とリース期限がついているから、永遠にロックされっぱなしになるデッドロックも防げるんですね。
導入前に気になる3つの疑問と現実的な始め方
ここまで当ラボの4大基盤を解説してきましたが、これから自分の開発環境を整えようとする方が抱きやすい 3つの現実的な疑問 について、先回りしてお答えします。
非エンジニアでもRustやSwiftを組めるか
結論から言えば、人間自身が Rust や Swift の文法を暗記して一行ずつ手書きする必要はまったくありません。
実際、当ラボの Rust 製ゲートキーパー(gemini-gate)も、SQLite 検索エンジン(kb-search)も、SwiftUI 製の管理台帳(BlogLedger)も、コード自体はすべて AI エージェント(Carbon 等)に書かせてビルドを通したものです。
人間が担うべき役割は、コードを書くことではなく 「JavaScript だと型消去でバグがすり抜けるから Pure Rust の単一バイナリで作ろう」「人間がエディタを開くと競合するから、SQLite を読み取り専用で表示する SwiftUI アプリを作ろう」という『構造の方針(アーキテクチャ)』を決めてAIに発注すること です。Rust や Swift はコンパイラのチェックが極めて厳格なため、AIが書いたコードに少しでも曖昧な点があればコンパイラが正確なエラーメッセージを出し、AI自身がそれを読んで自己修正してくれます。むしろ非エンジニアや個人開発者こそ、コンパイラが厳しく見張ってくれる言語をAIに書かせるべきなのです。
小規模な個人開発でも最初から全部必要か
最初から11系統のバッチや全7タブのネイティブアプリをすべて揃える必要はありません。規模に合わせて以下の順番で段階的に育てるのが最も現実的です。
-
ステップ1(ファイル数1〜30個) : まずは 「第1基盤(Astro等のプレーンテキスト正本 × Git)」 と、「第2基盤の半分(チャットで決まった仕様やルールを毎回必ず
GEMINI.md等のファイルへ自動保存させるルール)」 の2つから始めます。これだけでもチャット切り替え時の記憶喪失は劇的に減ります。 -
ステップ2(ファイル数30〜100個) : ファイルが増えてAIの丸読みが遅くなってきたら、「SQLite(FTS5)へのインデックス化」 と 「Rust(またはスクリプト)による保存時ルール検査」 をAIに作らせます。
-
ステップ3(ファイル数100個以上・毎日運用) : 複数チャットを並行して回すようになった段階で、「読み取り専用の管理台帳GUI」 と 「定期バッチ・エラー監視・排他ロック(順番待ち)」 を組み込みます。
WindowsやLinux環境ではどう置き換えるか
当ラボでは母艦に Mac を使っているため GUI に SwiftUI、定期バッチの起動に launchd を採用していますが、4大基盤の設計思想そのものは OS を問いません。
Windows や Linux 環境で同じ4大基盤を構築する場合は、以下の組み合わせで100%同等の仕組みを実現できます。
- 第1基盤(正本と履歴) : Astro × Git(
fsmonitorも Windows / Linux 両対応でそのまま動作します) - 第2基盤(永続記憶) : Markdown自動保存 × SQLite(WAL+FTS5 も完全クロスプラットフォームです)
- 第3基盤(手足と計器盤) : AIの手足はそのまま Pure Rust でコンパイルし、人間の読み取り専用GUIは Tauri(Rust + Webフロントエンド) または iced / egui(Rust製ネイティブGUI) に置き換えます
- 第4基盤(バッチと統制) : Linux なら
systemd timer(またはcron)、Windows なら タスクスケジューラ から Rust バッチを呼び出し、排他ロックファイルで競合を制御します
まとめ:AI時代の開発基盤を作る実践ステップ
AIに仕様もコードも原稿も書かせる時代において、開発の成否を分けるのは「魔法のプロンプト」ではありません。チャットが変われば記憶を失い、呼ばれた時しか動けず、並行作業で競合を起こすAIの弱点を、4つのインフラ基盤でどう支えるか にかかっています。
-
開発環境の整備(Astro × Git) : 動的DB密結合を避けてAIが差分編集・型検証しやすいプレーンテキスト正本にし、
git fsmonitorと自動バックアップでいつでも1秒で巻き戻せる作業場を作ること。 -
永続記憶の整備(自動データ保存 × SQLite高速検索) : チャットが変わると記憶が消えることを前提に、対話で決まった「使い方・仕様・知見・課題」を毎回ファイルへ自動保存し、それを SQLite(WAL+FTS5)に蓄積して次のチャットのAIも数ミリ秒で引き出せるようにすること。
-
ツールの整備(Pure Rust × SwiftUI) : 型消去ミスや起動遅延のない Pure Rust でAIの検問・検索ツール(4ms)を作り、人間は読み取り専用のネイティブGUI(
BlogLedger:866.5ms)から全体を覗くことで、エディタ保存競合を根絶すること。 -
バッチ環境と運用統制(バッチ運用・エラー監視・競合管理) : 日常の定例処理をバッチ化して稼働予定を可視化し、OS権限エラーや
.0初期バグ・404リンク切れを監視しつつ、複数AIチャットの同時実行を排他ロックと自動順番待ち(wait-turn)で安全にさばくこと。
最後に、現在お使いのAIコーディング環境(Antigravity、Cursor、Claude Code等)へそのまま貼り付けて、あなたのプロジェクトに合わせた「永続記憶と競合防止の第一歩」をAI自身に構築させるための実践プロンプト を置いておきます。ぜひ今日からの開発基盤づくりにお役立てください。
私たちのプロジェクトで、チャットが変わっても記憶を引き継ぎ、複数作業でも破綻しない開発基盤を段階的に整備したいです。
まずは現在のディレクトリ構成を確認したうえで、以下の3点を設計・実装する計画を立ててください。

1. 【永続記憶の自動保存ルール】:対話や開発の中で新しく決まった「コマンドの使い方」「設計仕様」「再発防止策(知見)」「未解決TODO」を、私の指示を待たずに作業完了前に必ず所定のMarkdownファイルへ自動追記する運用ルール案
2. 【SQLite全文検索インデックス】:それらの管理文書や主要コードをSQLite(WAL+FTS5)へインデックス化し、ファイルを丸読みせずにキーワードや節単位で高速抽出できる検索ツールの設計案
3. 【競合と破壊の防止ガード】:コミット前または保存時に書式・リンク・必須項目を機械チェックするゲート処理と、複数タスク実行時のロック制御案
土台さえ頑丈に組んでおけば、人間は細かなコマンド暗記や手戻り修正から解放され、本来集中すべき「何を作るか」「どう価値を届けるか」という設計に全力を注げるようになります。
