AIのランダム検索では見抜けない長編ブログの罠|372記事・297万字を順番通読した実測録
AI エディタ(Antigravity 等)で数百記事規模のブログや技術ドキュメントを育てていると、普段のメンテナンスは「特定の用語や数値を検索して該当箇所だけ直す(ランダムアクセス改修)」が中心になります。リンク切れ検査や文字数チェックもすべて合格し、完璧に整っていると思っていた連載シリーズでも、人間の読者と同じように「第 1 話から表示順(priority 順)で 1 記事ずつ順番に読み進める(シーケンシャル通読)」 を試してみると、検索では絶対に引っかからない構造的な欠陥が次々と浮かび上がってきます。
そこで当サイト(全公開 669記事)では 2026 年 11 月 8 日、サイト内の長編国家設計シリーズ 全 17 部・公開 372 記事(総文字数 2,966,621 字=新書・文庫本で約 30 冊分) を対象に、AI が 1 記事ずつ外部ノートへ記録を取りながら最初から最後まで順番に通読し、見つかった違和感と並び順のねじれを一気通貫で改修する実機検証を行いました。
結論からお伝えすると、ランダム検索や構文チェッカーでは 100% 素通りしていた「未定義用語の過去形ネタバレ」「三部作の順番逆転」「大団円の後の蛇足記事」「エラーの出ない図解の書き忘れ」「ダーク背景での円グラフ黒同化」など 7 種類の罠が発覚し、公開記事の約 83% にあたる約 310 記事を一挙に整列・改修できました。しかもこれだけの超大規模処理を 壁時計わずか約 91 分 で完走し、完了直後の Google AI Ultra の利用枠は 5 時間枠が 86%・週間枠が 89% も残っている という驚きの省燃費結果となりました。-
AIブログ記事数が85本から爆発した5世代全記録|Argon移行と全Rust化の実測推移 : WordPress手書き5年半85本の停滞から、Astro・Antigravity・VS Code+Argon・全面Pure Rust化を経て565万字超へ爆発した全5世代の推移と壁の突破録です。
-
AI開発のトークン量とTPU待ち時間1ヶ月実測|データ330倍でも通信4割減の記録 : 今回の省燃費通読の土台となった SQLite 索引と Pure Rust 検問機による 32 日間・33,658 コールの実測検証盤を公開しています。
-
Google AI Ultraの5時間制限と週間制限の比率|577記事監査で週間4%・5時間18%消費の実測録 : 5 時間枠と週間枠の消費比率から「約 4.5 倍容量の法則」を割り出した前回の全記事監査データです。
-
AIで36ファイル一括改修を32分で完走!シェルコマンド廃止とクォータ節約の実測録 : 無駄なシェル起動を排し、サブエージェントの排他分担でクォータ消費を最小化する基本設計を解説しています。
-
Astro×Mermaidの5K巨大化対策とPlaywright「WebP 16,383px上限」エラー解決録 : 本記事の終盤でも活躍した Playwright 実機ブラウザ検証の注意点と Mermaid 描画制御の基礎記録です。
-
Mermaid図解の文字切れ・スマホ崩壊を根絶|Astro専用コンポーネント自作と自動検問の記録 : クライアント JS ゼロでライト・ダーク両対応の比較図・フロー図を描画する専用コンポーネントの設計録です。
-
数十本〜数百本の 連載ブログ・技術マニュアル・長編ドキュメントを AI と一緒に運営 している方
-
個別記事の検索置換や機械的な構文チェックだけでは防げない 「読者が順番に読んだときの違和感・離脱原因」 を潰したい方
-
約 300 万字規模のテキストを コンテキストあふれ(記憶飛び)や利用枠の枯渇を起こさずに AI へ通読させる具体的な設計 を知りたい方
なぜ普段のAI横断改修では欠陥を見落とすのか
数ヶ月かけて数百本の記事を書き足したり、最新の統計データに合わせて横断修正を繰り返したりしていると、個々の記事の完成度は高いのに「シリーズ全体を通しで読んだときの体験」がいつの間にか歪んでしまうことがあります。まずは、なぜ普段の AI メンテナンスではその歪みに気づけないのかを整理します。
ランダム検索と順番通読の決定的な構造差
普段私たちが AI エディタに「この用語の表記を全記事で統一して」「数値が変わったので関係する記事を直して」と指示するとき、AI は全文検索インデックスを使って 該当する箇所へピンポイントに飛ぶ「ランダムアクセス(点と点の処理)」 を行っています。
この方法はスピードとトークン節約には抜群の威力を発揮しますが、「前の記事で何を説明済みで、次の記事でどんな結論に向かっているか」という時間軸(文脈の流れ) が完全に抜け落ちます。両者の違いを並べると、見えている景色がまったく異なることが分かります。
-
得意なこと : 数値の一括更新、表記揺れの統一、リンク切れや文字数上限の機械検査
-
AIの視点 : 検索にヒットした数行〜1記事だけを切り出して読むため、前後の記事の記憶を持たない
-
見落とす罠 : 「まだ説明していない用語を既知として語る」「最終回の後に各論が並ぶ」といった 順序と文脈の破綻が 100% 素通りする
-
得意なこと : 初見読者の目線に立った「知識の積み上げ順」「章の盛り上がり」「世界観の一貫性」の検証
-
AIの視点 : 導入ハブ(
00-bridge)から最終章まで、公開画面の並び順通りに1記事ずつ記憶を引き継いで読む -
見抜ける罠 : 定義の逆転、重複説明のくどさ、図解の書き忘れ、制作裏話の混入など 「通し読みで初めて引っかかる違和感」を一網打尽にできる

たしかに!辞書の誤字脱字を1ページずつ検索で直すのと、小説を第1章から最終章まで順番に読んで「あれっ、まだ登場しとらん人物が急に親友扱いされとるぞ!」と気づくのは、まったく別の作業じゃな!

まさにその通りなんです!ブログも最初は数本から始まりますが、後から時事テーマや深掘り記事をどんどん追加していくうちに、記事単体は正しくても「並び順(priority)」と「説明の順番」が少しずつズレていってしまうんですよね。
記憶あふれを防ぐ外部ノート書き出しと並列分担
とはいえ、今回の対象である 公開 372 記事・本文 2,966,621 文字(生ファイル 9.05MB、文庫本約 30 冊分) を 1 つの AI チャット画面にそのまま丸ごと読み込ませることはできません。どれほど巨大なコンテキストウィンドウを持つモデルでも、数百万トークンを 1 スレッドに詰め込めば、中盤以降の注意力が薄れる「Lost in the Middle(中だるみ忘却)」が起きたり、毎ターンの履歴再送で処理が重くなったりするためです。
そこで今回は、「人間の編集者が長編原稿を通読するときと同じやり方」を AI エージェント編成で再現しました。
-
章(部)ごとの適切な粒度(20〜35記事単位)で 11 班の通読サブエージェントを編成 : いきなり巨大な章(60記事超)を 1 体に任せると途中で息切れするため、全 17 部を 20〜35 記事ずつの 11 ブロックに分け、各ブロック内では必ず
priority(表示優先度)の昇順で 1 記事目から順番に全文を読む ルールを徹底しました。 -
1記事読むごとに「外部ファイル」へ記憶を書き出す : AI の頭の中(揮発するコンテキスト)だけに覚えさせるのではなく、1 記事読み終えるたびに 「①初出の専門用語・制度」「②主要な数値と前提」「③前の記事から繋がった点・逆に唐突だった違和感」 を手元の Markdown ログファイルへ逐次追記させました。
-
親AIは「14本の外部監査ノート(計1.39MB・5,298行)」だけを横断精読する : 全 372 記事の生原稿の代わりに、凝縮された 13 本の章別通読ログと総括レポート(計 14 ファイル)を親 AI が突き合わせることで、部をまたぐ順序ねじれや用語の定義漏れを 1 ミリの記憶飛びもなく特定できました。
順番通読と実機確認で初めて見えた7つの罠
実際に導入部の第 1 話から最終第 17 部の末尾まで priority 昇順で 1 記事ずつ通し読みしてみた結果、普段のランダム検索や Pure Rust 製の自動構文チェッカー(gemini-gate)では一度もエラーにならなかった 「人間の読者が順番に読んだときにだけ刺さる 5 つの構造欠陥」と「実機ブラウザ描画で初めて見えた 2 つの視覚トラップ」 が鮮明に浮かび上がりました。
未登場用語のネタバレと三部作の順番逆転
1 つ目の発見は、「まだ読者に説明していない専門用語や独自制度が、前の記事で既に解説済みかのように過去形で登場するネタバレ(前方参照のねじれ)」 です。
たとえば、ある技術章を priority 順に読んでいくと、本来なら最初に読むべき「現行言語の限界を解剖する第 1 弾」よりも前に、「第 2 弾:Rust と形式検証への収束」→「第 3 弾:AI による直接バイナリ生成」が並んでおり、一番最後に「第 1 弾」が出てくる 2 → 3 → 1 の逆転現象 が起きていました。さらに本文中でも、数記事あとで初めて定義されるはずの基盤用語が「前稿で証明した通り〜」という書き出しでフライング登場していたのです。
また、憲法移行を扱う終盤の部でも、先に「旧制度の廃止完了」の記事が出てから、その後ろに「移行期間中のハイブリッド運用」の記事が並ぶという時間軸の逆転が見つかりました。これらは 各記事が単体としては論理的に完結しているため、キーワード検索では絶対に異常として検出できません。
大団円の後に続く蛇足と制作裏話の露出
2 つ目と 3 つ目の発見は、連載作品ならではの 「章末の読後感(カタルシス)の崩壊」 と 「制作舞台裏のメタ表現の混入」 です。
-
章フィナーレ(大団円)の後ろに個別記事が並ぶ「アンコール後の蛇足」現象 : シリーズ初期に「この部の最終総括!」として美しい締めくくり記事(例:
priority: 80)を書いたあと、数週間後に時事ニュースを受けた各論記事(priority: 85や90)を追加すると、一覧や前後ナビでは 「感動の最終回が終わった直後に、また普通の各論へ引き戻される」 並びになっていました。 -
制作途中の「裏方メモ・自己採点スコア」の混入 : 単発で記事を手直ししているときには気にならなかった「旧作業フェーズの内部コード名」や「制作時の AI 俗称」、さらには記事末尾に残っていた「監査完了:論理スコア 4.8 → 9.8 / 10.0」といった 制作者側の舞台裏用語 が、読者として連続で読んでいると急に物語の幕の裏側を見せられたような冷めるノイズになっていました。
構文エラーにならない図解の書き忘れと統計のズレ
4 つ目と 5 つ目の発見は、「エラーが 1 件も出ない空白バグ」 と 「記事をまたいだときの統計前提のギャップ」 です。
372 記事の中には、「以下の円グラフが示す通り〜」「資産構成の比率(円グラフ)を見ると〜」と本文や見出しに書かれているのに、肝心の Mermaid 円グラフのコードブロック自体が書き忘れられて空っぽになっている記事が 2 本 紛れ込んでいました。構文ミスではなく「そもそも図が存在しない」ため、どんな自動テストも素通りしていたのです。
さらに、連続する記事の間で片方は「国内の全経済主体を合算したグロス現預金(約 2,415 兆円)」を語り、もう片方は「家計金融資産 2,200 兆円のうちの現預金内訳(約 1,126 兆円)」を語っている箇所がありました。どちらも公的統計として 100% 正しい数字ですが、順番に続けて読む読者からすると 「あれ、さっきの記事の現預金の数字と半分くらい違うけどどういうこと?」 と疑問が湧くポイントになっていました。これも通し読みをしたからこそ、「両者の統計母数の違いを 1 文添える」という親切な橋渡しができました。
実機ブラウザで判明した円グラフの黒同化と見切れ
そして今回、「データの通読だけでなく、本番ブラウザでの見え方まで必ずセットで確認してよかった!」と心底痛感したのが 6 つ目・7 つ目の発見です。
先ほど見つかった「円グラフの書き忘れ 2 箇所」に Mermaid の pie チャートを実装して本番反映した直後、Playwright(自動ブラウザ操作ツール)で実際の公開ページを開いてスクリーンショットを撮ってみたところ、コード上は構文エラーゼロなのに画面上で 2 つの視覚トラブル が起きていました。
-
ダーク背景(
#0a0a0a)と第1スライス色の「黒同化」 : ダークテーマの記事で素のpieチャートを描画すると、Mermaid 既定の第 1 スライス色が極めて暗い紺〜黒系になり、背景の黒色に溶け込んで 一番大きな割合を占める扇形が画面から消えたように見えていた のです。 -
長い
pie titleの「SVG左端 1 文字見切れ」 : Mermaid の円グラフ見出し(pie title)は既定で大きめのフォント(25px)で中央配置されるため、20 文字を超える長いタイトルを付けると SVG の描画枠(viewBox)の左右端を突き破り、先頭の 1 文字目がスパッと欠けて表示 されていました。
Mermaid.js の公式仕様では、個別の配色変数(pie1〜pie4 や文字色)を上書き反映させるにはベーステーマ('theme': 'base')の指定が必要になります。そこで以下の初期化ディレクティブを付与し、pie title を 15 文字以内 に絞ることで、ダーク画面でも鮮やかなコントラストで 1 文字も切れない円グラフへ即座に修正できました(詳しいタイトル補足は直下の本文で説明するのが鉄則です)。
%%{init: {'theme': 'base', 'themeVariables': {'pie1': '#2563eb', 'pie2': '#10b981', 'pie3': '#f59e0b', 'pie4': '#8b5cf6', 'pieTitleTextColor': '#f8fafc', 'pieSectionTextColor': '#ffffff', 'pieLegendTextColor': '#e2e8f0'}}}%%
pie title 家計金融資産2200兆円の内訳
    "現預金(約1126兆円)" : 51.2
    "株式・投信(約682兆円)" : 31.0
    "保険・年金等(約392兆円)" : 17.8
また、この通し読みの中で、Astro 標準の MDX パイプラインでは変換されずに [!NOTE] や [!TIP] という記号がそのまま本文に露出していた GitHub 固有の Alert 記法も見つかり、すべてサイト専用の GadgetSection コンポーネント枠へ美しく統一できました(この 2 つの再発防止ルールはすぐさま設計憲法 GEMINI.md[現在 約504KB・1,272行]へ自動永続化しました)。
うわぁ〜、コードの上ではエラーゼロでも、実際に黒背景の画面に出してみたらグラフが闇に溶けとったり、端っこの文字が切れとったりするんじゃな!やっぱり最後に人間の目と同じブラウザ画面で確認せんと分からんもんじゃねぇ。
本当にそうですね!「構文が正しいこと」と「読者が画面で気持ちよく読めること」は別物なので、テキストの順番通読と Playwright 実機チェックの両輪が揃って初めて完成度がグッと跳ね上がります。
合計297万字を通読改修した処理時間とトークン量
「でも、372 記事・約 297 万字を全部順番に読んで、310 記事以上も書き換えて本番確認までやったら、丸 1 日がかりで AI の利用枠(クォータ)も空っぽになったのでは?」と思われるかもしれません。ここからは、会話トランスクリプトとローカル集計データベースに記録された 1 トークン・0.1 分単位の実測スコア をそのまま公開します。
所要91分と310記事を一気通貫で直した4段階手順
今回のプロジェクトは、2026 年 11 月 8 日の 13 時 13 分に開始し、14 時 44 分に本番デプロイと実機検証まですべて完了(壁時計の総所要時間:約 91 分、うち親 AI 純稼働 85.5 分) しました。
親 AI と完走 18 班のサブエージェントを合わせた 延べ稼働時間は約 320 分(5 時間 20 分相当) に達していましたが、章ごとの並列分散と段階的な絞り込みによって約 3.5 倍速 に時間圧縮されています。全体の流れは次の 4 ステップで進めました。
全17部・372記事を11班で昇順通読し、計1.39MB(5,298行)の外部監査ノートへ集約
図解欠落2基・未変換記法・ネタバレ表現・制作裏話ノイズを4班並列でピンポイント除去
各ファイルの先頭18行だけを読み書きし、約310記事の priority を物語順へ一斉再配置
全記事検問を0.42秒で通過後、本番環境へ反映しPlaywright実機画面で円グラフ等を最終検証
今回の規模感と成果物の実測ボリュームを一覧表にまとめます。
| 実測項目 | 計測結果(2026年11月8日実測) | 補足・物理的なスケール感 |
|---|---|---|
| 順番通読した対象記事数 | 公開 372 記事(全 17 部) | 生 MDX 合計 9.05 MB |
| 通読した本文総文字数 | 2,966,621 文字(約 297 万字) | 原稿用紙 約 7,417 枚分 / 文庫本 約 30 冊分 |
| 同時に照合した構造要素 | 数式 1,117・図解 116・表 169 | 内部リンク 3,780 本 の文脈整合も同時確認 |
| 書き出した外部監査ノート | 14 ファイル・計 1,390.7 KB | 合計 5,298 行 の構造化レビュー台帳 |
| 壁時計の総所要時間 | 約 91 分(13:13〜14:44 JST) | 延べ 320 分 の AI 稼働を並列で 約 3.5 倍速化 |
| 本番 Git コミット変更規模 | 328 ファイル(公開記事 約 310 本) | +6,295 行 追加 / -993 行 削除(全体の約 83% 整列) |
| ローカル Pure Rust 全件検問 | 423.2 ミリ秒(0.42 秒) | RAMDisk 上で全記事・数千リンクを検査し 違反 0 件 |
新規送信946万トークンとKVキャッシュ87%の威力
続いて、最も気になる トークン消費量の実測内訳 です。親 AI(123 ステップ)とサブエージェント群のトランスクリプトをすべて集計した結果がこちらです。
| セッション区分 | 新規TPU送信(Fresh入力) | KVキャッシュ再利用 | AI出力+思考トークン | キャッシュ有効率 |
|---|---|---|---|---|
| 親AI(全体統括・123ステップ) | 3.19M tok(3,190,452) | 23.43M tok | 0.16M tok | 88.0% |
| サブ①:全文通読監査(11班等) | 4.11M tok | 21.85M tok | 0.96M tok | 84.2% |
| サブ②:本文の外科手術(4班) | 1.54M tok | 12.68M tok | 0.43M tok | 89.2% |
サブ③:priority 整列(3班) |
0.62M tok(わずか62万!) | 5.41M tok | 0.15M tok | 89.7% |
| 全セッション総合計 | 9.46M tok(9,460,289) | 63.37M tok | 1.70M tok | 87.0% |
注目していただきたいポイントが 2 つあります。
1 つ目は、Step 3 の「約 310 記事の priority 一斉整列」にかかった新規送信トークンが、3 班合計でわずか 62 万トークン(0.62M tok)だった ことです。Step 1 で外部監査ノートに「どの記事を何番目に並べるべきか」の設計図が完全に出来上がっていたため、Step 3 では各 MDX ファイルの本文を一切読まず、先頭 18 行(フロントマター部分)だけを読み取って priority を 10 刻み(10, 20, 30...)に書き換える最小 I/O 操作 に徹しました。もしここでもう一度 310 記事の本文を丸読みさせていたら、これだけで数百万トークンが余計に溶けていたはずです。
2 つ目は、総プロンプト処理量 72.83M tok(7,283 万トークン)のうち 87.0% にあたる 63.37M tok がクラウド側の KV キャッシュ再利用で賄われた ことです。結果として、この日 1 日の他作業を含めた新規 TPU 送信量も 13.67M tok に収まり、普段の集中開発日(1 日あたり 30.34M〜31.42M tok)の 半分以下 の負荷で文庫本 30 冊分の通読&大改修が終わってしまいました。
実機設定画面で見る5時間枠86%残存の証拠
「ログの数字だけでなく、実際の Google AI Ultra の利用枠メーターはどれくらい減ったの?」という疑問にお答えするため、全 372 記事の通読・310 記事の本番反映・実機検証をすべて終えた直後 に撮影した Antigravity のモデル利用枠(Models & Usage)画面をお見せします。
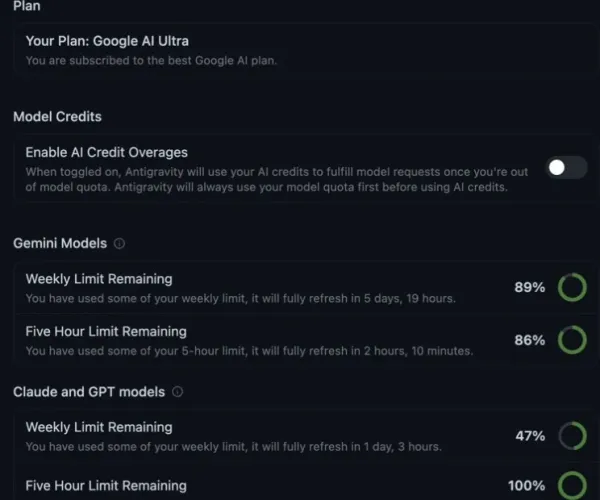
ご覧の通り、約 91 分間のノンストップ並列通読・大改修を走り切った直後にもかかわらず、Gemini モデルの利用枠は驚くほど余裕を残していました。
- 5 時間枠(Five Hour Limit Remaining) : 残り 86%(同日午前の別作業を含めても消費は 14% 以下)
- 週間枠(Weekly Limit Remaining) : 残り 89%(前日夜からの作業を含めても残り約 9 割を維持、今回の通読・改修単体では わずか数%の消費)
さらに、310 記事を書き換えた後の全公開記事リンク検査・文字数上限検査・孤立記事チェックは、AI に読ませるのではなく手元の Mac の RAM ディスク上に常駐させた Pure Rust バイナリ(gemini-gate)が 0.42 秒(クラウド通信ゼロ) で肩代わりしています。「AI にしかできない文脈通読だけにトークンを使い、機械的な検査と行番号特定は 100% ローカル CPU で捌く」という役割分担が、この圧倒的な低燃費を支えています。
文庫本30冊分を全部順番に読んで310記事も並べ替えたのに、5時間メーターが86%も残っとるんか!?これなら週末の午後にちょっとお茶を飲んどる間に、サイト丸ごとの通し読み編集会議が余裕でできてしまうな!
「一度通読して外部ノートを作ったら、修正時は必要な行しか読まない」というメリハリが効いていますね!しかも priority を 10, 20, 30... の 10 刻みに整列し直したので、今後途中に新しい記事を差し込みたくなっても 25 のように間へスッと入れられるようになり、長期メンテナンス性も一気に良くなりました。
まとめ:大規模通読を支える母艦とAI実行手順
今回の「372 記事・297 万字のシーケンシャル通読実験」から得られた結論を整理します。
順番通読監査を取り入れるべき規模の目安
-
普段の日次メンテナンス(Random で十分) : 法改正による数値更新、新しい関連記事リンクの追加、表記揺れの修正などは、SQLite 全文検索を使ったピンポイント改修が最速かつ最小コストです。
-
月 1 回・節目で『順番通読(Sequential)』を入れるべきケース : 連載記事やドキュメントが 30 本〜50 本を超えたタイミング、または後から時事記事や補足記事をたくさん差し込んだ後は、一度
priority昇順(または目次順)で AI に外部ノートを取りながら通し読みさせると、検索では絶対に見つからない「順序のねじれ・未定義ネタバレ・章末の蛇足」が一気に解消します。
缶コーヒー1本分で外部記憶と並列AIを回す母艦
今回のように 「11〜18 班のサブエージェントによる並列ファイル読み書き」「5,000 行超の外部監査ノートの高速追記」「1GB 超の SQLite 索引と Pure Rust 全件検問(0.42 秒)のオンメモリ実行」 を SSD の寿命を削らず無音・爆速で回し切るには、やはり 16GB の RAM ディスクを確保しても余裕たっぷりの 64GB メモリ搭載 Mac 母艦 が頼もしい土台になります。
推論(試算)として、たとえば約 24 万円クラスの 64GB メモリ搭載 Mac を 5 年間(1,825 日)毎日相棒として使い込んだ場合、1 日あたりの母艦コストは約 131 円(缶コーヒー 1 本分) です。人間が 1 人で文庫本 30 冊分の原稿を最初から読み直して 310 本の並び順を整理しようとすれば数週間はかかる大仕事を、休日のわずか 91 分・自分は方針を決めるだけで完遂してくれるタイム・イズ・マネーの価値を考えれば、これほど投資回収の早い環境はありません(日々の壁打ち中心なら 5x 枠、今回のような大規模並列監査や本格開発なら Google AI Ultra の 20x 枠と組み合わせると制限知らずで快適です)。
これから新しく Apple シリコン世代で 64GB 環境を組むなら、購入後のメモリ増設ができないため、最初から大容量ユニファイドメモリを備えた Apple Mac mini(Pro系チップ・64GBメモリ構成) が最もコストパフォーマンスに優れた本命機になります。

また、「広大な 27 インチ 5K Retina 画面で記事のレイアウトや図解の見切れを隅々まで確認しつつ、コストを抑えて 64GB 母艦を手に入れたい」という方には、今回の 91 分間・328 ファイル改修も涼しい顔で完走した Apple iMac 27インチ Retina 5K(2020年モデル・整備済/中古良品) に、背面ハッチから自分で簡単に増設できる 【Intel Mac増設用】Crucial DDR4-2666 SO-DIMM メモリ を組み合わせる構成も現役で抜群の実用性を誇ります(※ DDR4 SO-DIMM は Intel Mac 専用のため、Apple シリコン機には装着できません)。
そして、通し読みで生成した大量の監査ノートや AI エディタの会話アーカイブを RAM ディスクから高速退避・長期保管する外付けストレージには、Thunderbolt 3 対応で最大 3,000MB/s クラスの速度を持つ SanDisk Professional PRO-G40 SSD を 1 台繋いでおくと、数 GB のバックアップも一瞬で終わります。


つまみ食いみたいにバラバラに読むだけじゃ分からないことも、1ページ目から順番にノートを取りながら読めばスッキリ整うニャ。あとはゆっくりお昼寝するニャ〜。
最上位AIに順番通読と順序整列を任せる手順
最後に、「自分のブログやドキュメントでも、AI に第 1 話から順番に通し読みさせて並び順や文脈のズレを点検させたい!」という方へ、コンテキストあふれや勝手な全文書き換え事故を防ぎながら安全に実行させるためのプロンプトをご用意しました。
長編の文脈把握と章構成の再設計は、軽量モデルに丸投げすると表面的な感想だけで終わったり、逆に大事な本文まで勝手に削られたりする恐れがあります。必ず 『Gemini 4 Argon』または同等以上の最上位推論モデル を選び、以下のプロンプトを自分の記事フォルダ構成に合わせてコピー&ペーストして「まず通読ノートの作成と改修案の合意」から進めてみてください。
以下の記事 URL で解説されている「Sequential(表示順)通読監査 × 外部監査ノート書き出し × 先頭行限定での順序整列」の手法を精読してください。
https://lab.chihouzakki.com/blog/review/ai-sequential-vs-random-reading-372-posts-audit/
【厳守してほしい手順】
- いきなり既存の記事ファイルを書き換えないでください。まず私のプロジェクト内の記事一覧と表示順(
priorityや目次順・日付順)を確認し、1班あたり20〜35記事程度の無理のないブロックに分けて「表示順の1番目から順番に」全文を通読してください。 - 記憶飛びを防ぐため、1記事読むごとに「①初出の専門用語・前提」「②主要な数値」「③前の記事から読んだときの違和感(未定義用語のネタバレ・順序逆転・章末フィナーレ後の蛇足・図解欠落・制作裏話の露出など)」を外部の監査ログファイルへ逐次書き出してください。
- 全記事の通読ログが揃ったら、発見された課題と「並び順(
priorityを10刻みで再採番する案など)および最小限のピンポイント修正計画」を日本語で提示し、私の合意を得てから改修を実行してください(順序変更だけのファイルはフロントマター行のみを編集してトークン消費を最小化してください)。