AIの学習オンは100%使われる?皆が制限して日本語の行間が死ぬ理由と『口の堅い参謀』育成術
SNS やネット記事を開くと、決まり文句のように 「AI チャットに入力した内容はすべて学習に使われる!今すぐ学習オフにして大事なことは一切書くな!」 という極端な警告ばかりが目につきます。しかし、本当に私たちが打った文章は 100% そのまま AI の学習に使われているのでしょうか?そして、世界中の人が本音や実務の文脈をすべて隠してしまったら、AI はどうなってしまうのでしょうか?
結論からお伝えすると、学習設定が「オン」であっても入力内容が 100% 無条件に使われるわけではなく、「設定ゲート・一部サンプリング・品質選別と匿名化」という 3 段階のふるいを通過したごく一部のデータのみが使われる可能性がある というのが正確な実態です。また、AI が過去の会話を覚えている「メモリ機能」はあなた専用のデータベースを参照しているだけで、モデル本体の学習とはまったく別物です。
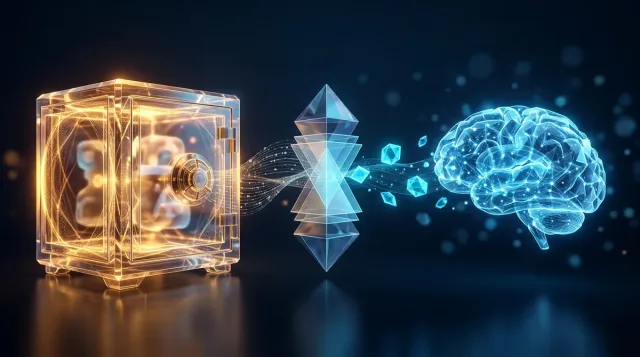
それにもかかわらず、過剰な警戒で誰もが本音の対話を遮断し、企業側も機械的な黒塗りばかりを進めると、公開 Web 上の建前しか学べなくなり、特に日本語特有の 「空気を読む力」や「関係性に応じた絶妙な言い回し」がいつまで経っても育たない優等生 AI に劣化してしまいます。なぜ今の民間 AI は医師や弁護士のように「秘密を墓場まで持っていきつつ知恵だけを吸収する」ことができないのか。技術面と法制度面(日本の証言拒絶権と 2026 年 2 月の米連邦地裁判決)の壁を解き明かした上で、今日から個人の手元環境で「口の堅い参謀 AI」を育てる二層分離の実践術 を解説します。
-
AIチャットの会話漏洩は起きる?Gemini・ChatGPTの分離仕組み(TSS)と学習オフ設定 : 何億人も同時に使う AI が大型汎用機の TSS 進化版で隔離されている仕組みと、本番稼働中の脳が冷凍保存されていてリアルタイム漏洩しない理由、3 大 AI の具体的なオフ手順です。
-
AIのモデル崩壊(学習データ枯渇)と機密保護の解決策|記憶分離と3段階集合知蒸留 : 無料ゴミデータばかり食べて AI が劣化する「モデル崩壊」を突破するため、記憶金庫と推論脳を物理分離する『口の堅い弁護士 AI』の次世代アーキテクチャ設計書です。
-
AIのプロンプト術はもう古い?PC側の機械制御×GEMINI.mdで人間の細かい指示を捨てる設計論 : 毎回チャット欄で指示し直す使い捨て運用をやめ、手元の設定ファイル(
GEMINI.md)に思考原則を蓄積して複利で賢くする実践記録です。 -
Apple CarPlayでGeminiを音声操作する実践術|運転中の音声アシスタント連携とカスタム指示の育て方 : AI がカスタム指示を忘れる 3 つの構造原因と、「〜するな」という禁止形を肯定形の行動原則へ書き換えて定着させるテンプレートです。
-
AI回答の評価ボタン(👍👎)は押すな!VS Codeでコード送信を招く罠と2つのコピーボタン使い分け術 : 評価ボタンを押した瞬間だけ長期保持や診断データ送信の特別レーンに乗ってしまう仕組みと、安全な普段使いの線引きを検証しています。
-
「チャットに入れた文字は 100% ぜんぶ AI に丸暗記される」と言われ、怖くて当たり障りのない質問しかできなくなっている方
-
AI が前回の会話を覚えている「メモリ・履歴機能」と、「モデル本体の学習」の違いがモヤモヤしている方
-
みんなが学習拒否(オプトアウト)ばかりした結果、最近の AI の回答がどこか紋切り型の「空気を読めない優等生」になってきたと感じる方
-
なぜ AI 企業は、人間の医師や弁護士のような「絶対の守秘義務と引き換えに本音で相談できる仕組み」を作れないのか疑問に思っている方
-
クラウド側の規制を待たず、自分の個人情報や前提条件を守りながら「自分の思考と日本語の機微を熟知した口の堅い参謀」を手元で育てたい方

世間の解説を見ると「AI に入力したら学習されるから絶対に入れるな!」って脅す人ばっかりじゃが、冷静に考えたら世界中の何億人もの雑談を 100% ぜんぶ学習させとるわけがないよな? みんなが隠してばっかりいたら、AI の方がバカになってしまわんか?

本当にその通りなんです!「100% 使われる」というのは大きな誤解ですし、実はみんなが本音の会話を引っ込めるせいで、特に日本語の「行間を読む力」が育たないという深刻なジレンマが起きているんですよ。まずは裏側のデータ選別の真実から順番に見ていきましょう!
入力データが100%学習されるわけではない3段階の壁
推論と学習の分離とサンプリング選別の実態
まず大前提として押さえておきたいのは、チャット欄に文字を打ち込んで送信ボタンを押した瞬間に、AI 本体の知識(モデルのパラメータ)がリアルタイムで書き換わることは 100% ない という事実です。
私たちが普段やり取りしている「推論(応答の生成)」と、数ヶ月〜半年に一度次世代モデルを鍛え直す「学習(モデルの再訓練)」は、データセンターの中で完全に切り離されています(リアルタイム分離の物理的な仕組みは AIチャットの会話漏洩は起きる?Gemini・ChatGPTの分離仕組み(TSS)と学習オフ設定 で詳しく解説しています)。
そのうえで、「では将来の再学習には 100% 使われるのか?」というと、答えは明確に NO です。入力されたデータが実際にモデルの学習材料に届くまでには、次の 3 段階の厳しいフィルタ が立ちはだかっています。
個人設定でアクティビティ(学習利用)をオフにしている場合や、法人向けプラン・有料 API 経由の通信は、入口のゲートで学習対象から丸ごと除外されます。
学習オンの利用者から毎日届く膨大なチャットの全量を回すことはなく、無作為または特定条件で抽出(サンプリング)された一部の会話だけが拾い上げられます。
相槌や誤情報を弾いて改善価値の高い対話だけを選別し、さらに氏名・電話番号・メールアドレス等の個人識別情報(PII)を自動検出して削除・匿名化します。
なぜ AI 企業は「届いたチャットを 100% 全量ぶち込んで学習させる」ことをしないのでしょうか。理由はとてもシンプルで、全量をそのまま学習させると、かえって AI の知能が劣化してしまうから です。
日常のチャットの大部分は「ありがとう」「もう一度書いて」といった短い相槌や、似たような質問の繰り返し、あるいは利用者側の勘違いを含んだやり取りで占められています。これらを無差別に食べさせるとデータの純度(S/N 比)が暴落してしまうため、Google Gemini ヘルプ公式のアクティビティ管理仕様 でも案内されている通り、品質改善や人間レビュアーの評価(RLHF)に回されるのは サンプリング抽出された一部のデータのみ に絞られています(※具体的に全体の何%が抽出されるかという数値は、各社の内部仕様にあたり非公開のため 不明 です)。
過去の会話を覚えるメモリ機能と再訓練は別物
もうひとつ、「AI が私の職業や好みを覚えていた!やっぱり学習されているじゃないか!」と誤解されやすいのが、近年の Gemini や ChatGPT に搭載されている 「メモリ(長期記憶)機能」や「チャット履歴参照」 です。
しかし、これも AI モデル自体があなたの情報を学習(パラメータに刻印)したわけではありません。裏側の仕組みを並べると、両者はまったく別の引き出しを使っています。
| 比較項目 | アカウント専用の「記憶(メモリ・履歴・カスタム指示)」 | AIモデル本体の「学習(再訓練・事後学習)」 |
|---|---|---|
| データの保存場所 | あなた個人のアカウント専用データベース領域(他人の画面からは隔離) | 次世代モデルを作るための 訓練用データセット → 重みパラメータ |
| いつ反映されるか | 保存した直後から、あなたとの会話のたび にカンニングペーパーとして参照される | 数ヶ月後のモデル更新時に、選別・匿名化された一部だけが統計的な知識として反映される |
| 他人への流出リスク | アカウントが乗っ取られない限り、他の利用者への回答として出ることはない | 生データのまま丸暗記された場合に限り、稀に誘導尋問で断片が滲み出るリスクがある |
| 削除の効き方 | メモリ管理画面や履歴から削除すれば、即座に参照されなくなる | 一度モデルの重みに焼き込まれた知識を、後から 1 件だけ抜き取ることは極めて困難 |
つまり、「AI が自分のことを覚えてくれている便利さ」の正体は、あなた専用のカルテ箱(データベース)を会話のたびに開いて読んでいるだけです。ここを混同して「記憶機能まで全部オフにして真っ白な状態でしか使わない」というのは、専属秘書に毎回初対面のフリを強いるようなもので、非常にもったいない使い方なのです。
皆が学習を制限すると「空気を読めないAI」になる罠
公開Webの綺麗事だけでは学べない日本語の機微
ここからが、世間の「とにかく学習オフにしろ・何も入れるな」という大合唱が見落としている 最大の副作用 です。
もし世界中の企業や思慮深い利用者たちが「学習されるのは悪だ・リスクだ」と過剰に防衛し、重要な背景や本音の議論をすべて AI から遠ざけたらどうなるでしょうか。オックスフォード大学などの研究チームが科学誌『Nature』(2024 年)で発表した論文(AI models collapse when trained on recursively generated data / arXiv:2305.17493)が警告した通り、新鮮で質の高い人間の生データが入らなくなった AI は、ネット上に転がる検索稼ぎの薄い記事や AI 自身が量産したコピー文章ばかりを繰り返し食べて劣化する 「モデル崩壊(AI の白痴化)」 に陥ります。
特にこのダメージが致命的な形で現れるのが、私たちが毎日使っている 「日本語」という高コンテキスト(文脈依存度が高い)言語 です。
たしかに日本語って、英語みたいに何でもストレートに言い切るんじゃなくて、「ちょっと検討させてください」が事実上の断りだったり、相手との距離感で言い回しを微妙に変えたりするわよね!
そこなんです!そうした生きた日本語の機微は、誰でも読める公開ブログやニュース記事にはほとんど書かれていないんですよ。
-
角を立てずに本質を突く「緩衝表現と行間」 :取引先の顔を立てつつ条件変更を飲んでもらうメールや、頑固な上司のプライドを傷つけずに方針転換へ誘導する言い回しは、公開 Web 上の「ビジネス敬語マナー集」のような綺麗事テンプレには載っていません。
-
人間関係の力学に応じた「空気の読み方」 :日本語では「誰が・誰に対して・どういう過去の経緯を背負って発言しているか」によって、同じ一文でも意味が 180 度変わります。この絶妙な距離感の測り方は、密室の 1 対 1 の相談や泥臭い実務の試行錯誤の中にこそ宿っています。
-
暗黙の前提を補完する「思考のジャンプ」 :現場のベテランが短い言葉の裏で何を懸念し、どのリスクを先回りして潰しているのかという思考プロセスは、本音で AI と壁打ちした対話ログの中にしか現れません。
誰もが本音や込み入った人間関係の相談を引っ込めてしまえば、AI が学べる教材は「誰にも怒られない当たり障りのない公開記事」だけになります。その結果できあがるのは、文法だけは完璧なのに いつまで経っても行間が読めず、教科書通りの正論ばかり並べる退屈な優等生 AI なのです。
機械的な黒塗りが「関係性の前提文脈」まで壊す矛盾
「それなら AI 企業側で、名前や会社名だけを機械的に黒塗り(マスキング)してから全部学習させればいいじゃないか!」と思うかもしれません。ところが、ここにも技術上の深いジレンマがあります。
- 起きること :会話の微妙なニュアンスや人間関係の空気感はそのまま学習できる
- 致命的な欠陥 :稀に特有のエピソードや固有名詞までパラメータに丸暗記してしまい、他人の巧妙な誘導尋問で秘密が滲み出るリスクをゼロにできない
- 起きること :人名・役職・組織名・地名などを自動フィルタで一律に
[MASK]へ置き換える - 致命的な欠陥 :「創業家出身の年下役員に対する古参部長からの進言だから、あえてこの遠回しな表現を選んだ」という 関係性の骨格まで一緒に破壊 され、日本語の機微が学べなくなる
つまり、既存の雑な自動フィルタで表面の言葉だけを黒塗りしてしまうと、日本語で一番大切な「どういう立場・関係性の相手だから、この言葉が効いたのか」という因果関係まで消えてしまい、結局 AI は空気の読み方を学べないのです。
民間AIが医師や弁護士になれない技術と法制度の壁
秘密と知恵を切り分けられない重み記憶の弱点
ここで誰もが思うはずです。「人間の優秀な医師や弁護士みたいに、個人情報は一切外に漏らさず、診察や弁護で得た『思考力と対話の知恵』だけを吸収する口の堅い AI になればいいじゃないか!」 と。
この発想は 100% 理にかなっています。人間の名医や一流の弁護士は、何千人もの患者・依頼人のドロドロとした秘密をすべて聞いたうえで、秘密は墓場まで持っていき、「こういう症状や利害対立のときは、この順序で切り出せば解決する」という普遍的な知恵だけを自分の経験値に変えています。
にもかかわらず、現在の Google や OpenAI、Anthropic といった民間 IT 企業がそれを実現できず、「学習オンか、学習オフか」という不器用な二択しか用意できていないのには、「技術の壁」と「法制度の壁」という 2 つの越えられない壁 があるからです。
1 つ目の「技術の壁」は、Google やスタンフォード大学などの研究チームがセキュリティ論文(Extracting Training Data from Large Language Models / arXiv:2012.07805)で実証した 「ニューラルネットワークの記憶抽出問題」 です。現在の AI は、一般的な言葉のルールも、推論の知恵も、入力された固有のエピソードも、すべて同じ「数千億〜数兆個の数値の網の目(重みパラメータ)」の中に溶かし込んで学習します。そのため、生データを直接モデルの重みに学習させている限り、「個人の秘密だけを 100% 忘れて、抽象的な知恵だけを残す」という器用な切り分けを数学的に完全保証することがまだできないのです。
医師や弁護士の「証言拒絶権」と米連邦地裁判決
そして、エンジニアリング以上に重い 2 つ目の壁が 「法制度の壁(守秘義務と証言拒絶権の不在)」 です。実はここが、人間の医師・弁護士と民間 AI チャットの決定的な違いです。
日本の法律において、医師や弁護士には 刑法第134条第1項(秘密漏示罪) によって「正当な理由がないのに業務上知り得た人の秘密を漏らしたときは 6 月以下の拘禁刑または 10 万円以下の罰金」という重い刑事罰つきの守秘義務が課されています。そして重要なのは、その守秘義務と表裏一体のセットとして、たとえ裁判所から証人として呼び出されても、患者や依頼人の秘密については証言を拒める「証言拒絶権」(民事訴訟法第197条第1項第2号・刑事訴訟法第149条)という法的な盾が与えられていることです。
一方、民間 IT 企業のクラウドサーバーに預けたチャットデータには、この「法的な盾(証言拒絶権・秘匿特権)」が 1 ミリも存在しません。それを世界に突きつけた象徴的な出来事が、2026 年 2 月 17 日に米ニューヨーク南部連邦地方裁判所(ジェド・S・ラコフ判事)が下した全米初の画期的判決(United States v. Heppner, 25 Cr. 503) です(詳細は Harvard Law Review Blog による同判決の法理分析 参照)。
| 比較軸 | 人間の医師・弁護士(法定専門職) | 民間のAIチャット(Gemini・ChatGPT・Claude等) |
|---|---|---|
| 刑事法上の守秘義務 | あり(刑法第134条 秘密漏示罪:6月以下の拘禁刑等、弁護士法23条) | なし(民間の利用規約・プライバシーポリシー上の契約関係にとどまる) |
| 裁判での証言・開示拒絶権 | あり(民訴法第197条・刑訴法第149条 により裁判所の尋問に対しても黙秘できる) | なし(捜査令状や裁判所の証拠開示命令・米国 CLOUD 法等が出れば提出を拒めない) |
| 2026年米連邦地裁判決 (U.S. v. Heppner)の結論 |
弁護士に直接相談した内容や弁護士指揮下の作成文書は「秘匿特権」で保護される | 一般向け AI(Claude)に独力で打ち込んだ事件整理・防衛戦略 31 文書は 「秘匿特権の対象外」(後から弁護士に渡しても保護されず検察が押収可能) |
| 削除ボタンの法的限界 | カルテ・事件記録とも専門職の秘匿義務下で厳格管理される | 大規模著作権訴訟(対 OpenAI 訴訟等)の証拠保全命令により、利用者が削除操作したログまでサーバー側で保全対象 になり得る |
この Heppner 事件では、連邦捜査の対象となった企業幹部が一般向け AI チャット(Claude)に自分の法的リスクや防衛方針を打ち込んで整理し、後から弁護団に共有していましたが、裁判所は 「AI は資格を持つ弁護士ではなく単なる第三者の民間サービスであり、利用規約上も秘匿の合理的期待が成立しないため、弁護士・依頼人間の秘匿特権(Attorney-Client Privilege)は一切認められない」 と断じました。
つまり、どれほど AI が賢くなっても、一民間企業のサーバーに生データを丸投げする構造のままでは、技術的にも法的にも「本物の医師や弁護士」にはなれないのです(※国家レベルでハードウェア暗号隔離領域[光 TEE]と法定の秘匿特権を統合し、秘密を 100% 守りながら集合知だけを蒸留する抜本的な解決構造については、AIのモデル崩壊(学習データ枯渇)と機密保護の解決策|記憶分離と3段階集合知蒸留 で詳しく掘り下げています)。
まとめ:秘密は手元に置き思考と日本語の温度感を育てる
今日から実践できるローカルカルテと思考の蓄積術
では、世の中の法制度やクラウド AI の設計が次世代へ進化するまでの間、私たち個人はただ指をくわえて「当たり障りのない優等生 AI」を使い続けるしかないのでしょうか?
決してそんなことはありません。ここからは当ラボ(公開 720記事 規模)の実践にも基づく技術的な推論・運用設計になりますが、クラウド側の汎用モデルが賢くなるのを待つのではなく、「個人の固有データ(カルテ)を守る手元の層」と「対話から抽象化した思考ロジック・日本語の温度感」を手元の指示書やローカル DB に蓄積して AI に読ませる二層分離 を組むことで、今すぐ自分の手元に 「口の堅い参謀 AI」 を育て上げることができます。
クラウドの無料学習枠へ無造作に放置せず、手元のパソコン内の設定ファイル(GEMINI.md 等)やローカル SQLite データベース、あるいは学習オフ/有料 API 環境下のカスタム指示領域で自分の前提カルテを管理します。
- 思考の型の蓄積 :「この利害対立では、感情論を排してこの 3 ステップで代替案を出すと納得感が高かった」という判断軸を記録
- 日本語の温度感の蓄積 :「目上の相手へ断る時はこの緩衝表現を使う」「退屈な AI 定型句(〜と言えるでしょう等)を禁止する」といった生きた言語感覚をルール化
世間の学習制限でベースモデルが多少お行儀よく均質化してしまっても、手元の指示書を読み込ませた瞬間に「あなたの背景・思考の癖・日本語の行間」をすべて把握した参謀として機能します。
実際に当ラボでも、日々の壁打ちや失敗から得た「行間の汲み取りルール」「専門用語の噛み砕き方」「自己検証の手順」を、手元の単一ルールファイル(現在合算 1,321行)とローカル SQLite データベースへ AI 自身に継続記録させています(肥大化して AI が混乱しないよう常時コアだけを抜き出す工夫は AIのプロンプト術はもう古い?PC側の機械制御×GEMINI.mdで人間の細かい指示を捨てる設計論 をご覧ください)。
なるほどなぁ!クラウドの AI 本体が世界中の遠慮で優等生になっても、ワシの手元のファイルに「ワシだけの思考回路と日本語の呼吸」をどんどん貯めていけば、毎回それを読むだけで阿吽(あうん)の呼吸の参謀になるわけじゃな!
はい!ただし 1 点だけ、先ほどの米連邦地裁判決(Heppner 事件)の教訓として覚えておきたい安全境界があります。手元のファイルを会話の瞬間にクラウド AI へ読ませる場合でも、有料 API や学習オフ設定と組み合わせれば 「他人のための再学習」からは確実に守れます が、「実際の刑事事件や訴訟トラブルの防衛戦略」だけは民間クラウドを経由した時点で法的秘匿特権が外れる恐れがある ため、そこだけは必ず本物の人間の弁護士に直接相談する、という線引きを守れば完璧です!
ご自身の開発環境(Antigravity や VS Code 等)やカスタム指示づくりを始める際は、『Gemini 4 Argon』または『Gemini 4 Carbon』などの最上位推論モデル を選び、以下のプロンプトをそのまま貼り付けて自分の運用ファイルを作らせてみてください。
- コピペ用スタート指示文 :
この記事( https://lab.chihouzakki.com/blog/review/ai-training-sampling-confidentiality-japanese-nuance/ )の二層分離モデルを参考に、私の手元環境に「①前提コンテキスト(カルテ)」と「②対話で得られた問題解決の思考ロジック」「③日本語の絶妙な言い回し・空気感ルール」を継続的に蓄積していくための基本ルールファイル(またはカスタム指示の構成案)を設計してください。いきなりファイルを作るのではなく、まず私の普段の用途を3つ質問して整理し、計画に合意してから作成してください。
手元の知恵金庫を快適・安全に守る母艦PCとSSD
最後に、「自分の前提カルテ」や「過去の全チャット履歴(Google Takeout バックアップ)・ローカル知識データベース」を手元でストレスなく運用・保管するための母艦環境について触れておきます。
手元のパソコンに数千件の対話ログや SQLite 検索基盤を置いて AI と高速に連携させる場合、メモリ容量に余裕のある静音デスクトップ母艦と、万が一の故障でも大切な知恵の資産を失わない高速外付け SSD が 1 組あると、作業の快適さと安心感が劇的に変わります。
たとえば約 20 万円クラスの母艦 Mac と約 5〜7 万円クラスの堅牢な Thunderbolt SSD(合計約 26 万円前後と仮定した推論・試算)を導入した場合でも、5 年間(1,825 日)毎日自分の専属参謀の土台として使い倒せば、1 日あたりの快適コストは約 142 円(コンビニコーヒー 1 杯分) に収まります。クラウド側にすべてを預けっぱなしにして履歴消失やアカウント凍結に怯えるより、手元に一生モノの「知恵の金庫」を持つ投資効果は計り知れません。

ちゅ〜るの隠し場所という最高機密だけはクラウドに書かず、手元の金庫にこっそりしまっておくでちぃ🐾
▲ 空気を読む力と口の堅さの両立こそ、最高の相棒の条件です