AIエージェントのトークン節約とSQLite直結術|仕様書1コール化とCarbon並列監査で週間枠1%の実測録
AI エディタ(Antigravity / VS Code)で大規模なブログやシステムを開発していると、「AI が仕様書を確認するたびに検索とファイル読み込みの 2 往復を繰り返してトークンを浪費する」「上位モデルで一括監査を回すとあっという間に利用枠(クォータ)が溶ける」 という最大の障壁(ボトルネック)に直面します。
今回、週間枠のリセットまで残り 7 時間 42 分の時点で Google AI Ultra(20x)の週間残量が 19% 残っていたため、「リセットで消える前に、計算単価が 2 倍重い最上位モデル Gemini 4 Carbon (High) で重い一括監査を回して使い切ろう」と着手しました。その過程で発見した「1 手目の抜粋検索に約 3秒、続く AI の再推論と read_file に 11〜14秒(計 14〜17秒)を費やす 2 往復の無駄」を根絶すべく、1,049 行の詳細仕様書を SQLite から約 2.31ms(ツール実行全体でも約 1〜2秒)・1 ツールコールで章節ごと生行全文取得する Rust 改修(kb-search Rev. 2.7.0) を実装しました。
結論からお伝えすると、この Rust エンジン改修に加え、Gemini 4 Carbon (High) の 5 班並列サブエージェントによる未監査 22 記事の深層監査、計 20 記事のピンポイント修正、外部出典 105 本の死活照合、Playwright 実機検証、本番ビルド&デプロイ(公開総数 747記事)までを 1 時間 6 分で完遂 したにもかかわらず、週間枠の消費はわずか 1%(19% → 18%)、5 時間枠の消費もわずか 7%(89% → 82%) で済んでしまいました。さらに直後の追試(第 2 弾)として Swarm 7 体並列(Carbon High + Argon High)で計 51 記事の一斉強化・新規執筆・デプロイ を連続実行しても、週間枠の消費はわずか 2%(18% → 16%) に収まりました。本記事では、なぜ最重量モデルを並列稼働させても利用枠がほとんど減らなかったのか、その物理的な裏付け(エビデンス)と実装の全貌を公開します。
-
AI自律開発の最適化7層総括|設計書3層分離・SQLite・Rust・Swarmの全設計図 : 公開 747記事・設計書合算 1,345行 規模の環境を週間枠数%で回すための、設計書 3 層分離や単方向 SQLite 同期を含む 7 層アーキテクチャの全体像を解説しています。
-
Google AI Ultraの5時間制限と週間制限の比率|577記事監査で週間4%・5時間18%消費の実測録 : Google AI Ultra における「5 時間枠」と「週間枠」の容量比率(約 4.5 倍の法則)を、577 記事の一斉監査ログから実測した基準データです。
-
Gemini Decision 1とRust・Carbonの3層検問|1記事0.02円と4msの高速化実測 : ローカルの Pure Rust ゲート(4ms)と軽量判定 API
Gemini Decision 1、そして最上位Carbonを組み合わせた 3 層検問パイプラインの設計録です。 -
AIのコード丸読みを防ぐSQLite構文木|Astro・TS・Rustの関数行番号を2msで引く方法 : プログラムコード(
.astro/.ts/.rs)の関数や構造体の行番号を SQLite から 2ms で引き当て、AI の無駄なファイル丸読みを塞いだ先行検証です。 -
SQLiteはなぜMySQLより速い?WAL・FTS5とAstroで記事探索をミリ秒化した実装録 : 外部サーバー不要のローカル SQLite(WAL モード+FTS5 全文検索)が、なぜ Astro 静的サイトと AI 知識ベースで圧倒的な速度を出すのかを解説しています。
-
ChatGPT WalletとGoogle Wallet×Geminiの違い|AI決済の仕組みと安全設定 : AI エージェントに決済や家計分析を繋ぐ最新機能の仕組みと、口頭の指示ではなくプログラム・物理キーで資産を守る安全設計を比較しています。
-
AI エディタに読ませるルールや詳細仕様書(
GEMINI.md/CLAUDE.md等)が 1,000 行を超え、参照のたびにツール呼び出しが増えて困っている方 -
最上位推論モデル
Gemini 4 Carbon (High)を使って複数記事や複数ファイルの厳密なファクト監査・修正を回したいが、利用枠の急減が怖い方 -
Google AI Ultra(5x / 20x) の実践的な省燃費チューニングと、自分の開発環境へそのまま導入できる具体的な設計手順を知りたい方
発端:リセット前の週間残量19%と2往復の無駄
事の発端は、週に 1 度の Google AI Ultra(20x)週間利用枠(Weekly Limit)のリセット時刻(朝 09:26)まで、残り 7 時間 42 分 となった深夜のタイミングでした。
Antigravity の設定画面(Models & Usage)を開いて確認すると、週間枠がまだ 19%、5 時間枠が 89% 残っていました。「このまま朝を迎えてリセットされたら、残りの 19% 分がもったいない。普段は重くてためらうような、最上位モデル Gemini 4 Carbon (High) による未監査記事の徹底監査を一気に回して使い切ろう!」と考えたのがスタートです。

週間枠がリセットされる前に、余っている 19% を重労働で綺麗に使い切ってしまおうというわけですね。計算単価が通常の Gemini 4 Argon の 2 倍重い Carbon (High) を使えば、すぐに枠が減りそうですが……。

ところが、いざ監査の準備を始めた直後に、AI エージェントの動きの中に「見過ごせない通信の無駄」があることに気づいたんです。それが仕様書を読むときの 2 往復のツール呼び出し でした。
AIの「十分速い」を疑い実行ログを直視する
ここで非常に重要な教訓があります。もし AI 自身に「今の検索や処理の性能はどう?」と確認したとしても、AI は部分的な数値だけを見て 「SQLite 検索は十数ミリ秒で動いており、十分に性能が出ています」 と答えてしまう可能性が高いという点です。
しかし、口頭の説明ではなく 事実 を見なければ本当の姿は分かりません。そこで、チャット画面の中で AI が実際に何の処理を実行しているか(ツール呼び出しの中身) を目視で観察しました。すると、データベース化されているはずなのに、AI が裏で 本来してはいけない read_file(仕様書ファイルの直接読み込み) を実行していたのです。
すかさず AI に 「仕様書ファイルを直接呼んでいるみたいだけど、SQLite で読まないの?」 と理由を問いただしたところ、「SQLite 検索が先頭 135 文字のスニペット(抜粋)しか返さないため、不足分を AI が read_file で読み直す必要がありました」 という返答が返ってきました。
当ラボでは、常時 AI に読み込ませるコア原則(GEMINI.md)とは別に、UI・CSS・データベース・ビルド手順・ハルシネーション監査規定などを網羅した 1,049 行の詳細仕様書(docs/GEMINI_MANUAL.md) を分離して運用しています(ルール群全体では合算 1,345行 規模)。
AI がこの詳細仕様書の特定の節(たとえば「1.3 節のハルシネーション 5 大類型」や「2.3 節の並列監査プロトコル」)を確認する際、従来のローカル検索エンジン(kb-search)は SQLite から 先頭 135 文字の抜粋スニペット しか返していませんでした。
その結果、改修直前の実行ログ(transcript.jsonl)を計測すると、AI エージェントは仕様書を 1 節確認するたびに毎回次のような時間と通信を費やしていたのです。
-
1 手目(スニペット検索:ツール実行 約
3秒/ SQLite 内部11.31〜24.11ms) :./scripts/run_kb_search.sh docs "1.3."や"2.3."を実行。SQLite 内部の検索自体は十数ミリ秒ですが、シェル起動を含めたツール完了までに 約3秒かかり、しかも開始行番号と 先頭 135 文字の抜粋 しか返りません。 -
2 手目(AI の再推論+
read_file:追加で11〜14秒消費 / ローカル読込は数ミリ秒) :read_fileによるローカル SSD / RAMDisk からのファイル読み込み自体は数ミリ秒(1 秒未満)で終わりますが、抜粋を受け取った AI(Gemini 4 Carbon)がサーバー側で「135 文字では規定の全文が分からないため、docs/GEMINI_MANUAL.mdの該当行範囲をread_fileしよう」と再推論して 2 手目を完了するまでに、実測で11秒(1.3 節参照時:01:50:39 → 01:50:50)〜14秒(2.3 節参照時:01:52:55 → 01:53:09) が溶けていました。
つまり旧方式の最大の障壁(ボトルネック)は、ローカルのファイル読み込み速度ではなく 「135 文字で切り詰めたせいで発生する AI サーバーとのもう 1 往復の推論待ち(11〜14秒、1 手目と合わせて計 14〜17秒)」 にありました。しかもツールを 1 回余分に呼び出すたびに、「そこまでに蓄積した親エージェントの会話履歴・システム指示・思考ログの全体(上記実測時は 1 回あたり約 7.0万〜9.9万トークン)」が、もう 1 往復まるごと AI サーバーへ再送信される(ツール往復税) 構造になっていたのです。
改修:仕様書をSQLiteから1コールで全文取得
この「検索してからファイルを読み直す」という二律背反(トレードオフ)を根本から解消するため、一括監査を回す前にまず Pure Rust 製の知識検索エンジン kb-search を Rev. 2.7.0 へと改修しました。
なぜ検索後のファイル再読込が枠を溶かすのか
AI に長大な仕様書を参照させる際、ファイル全体を丸読みさせれば 1 回で数万トークンを消費します。かといって、検索ツールが短い抜粋(スニペット)しか返さない設計になっていると、AI は確実な裏付け(エビデンス)を得るために必ず 2 手目で read_file を叩きます。
しかも、人間が「1.3 節を確認して」と指示したとき、AI が本当に必要としているのは 「1,049 行のファイル全体」でも「135 文字の細切れ抜粋」でもなく、「1.3 節の開始行から終了行までの正確な全文(30〜60 行程度)」 です。
Rust製kb-searchの改修と約2.3msの実測値
実は、当ラボの SQLite データベース(SQLite 公式ドキュメント の FTS5 全文検索および標準テーブル設計に準拠)には、すでに仕様書を章節単位で行範囲ごと構造化した doc_sections テーブルと全文保持用の workspace_files テーブルが格納されていました。にもかかわらず、CLI 側の出力処理が一律 135 文字で切り詰めていたため、宝の持ち腐れになっていたのです。
そこで、Rust 公式リファレンス に基づく Pure Rust 実装の kb-search(計 5 ファイル)に以下の改修を加えました。
-
manual "<節番号|語句>" [--full]サブコマンドの新設 : 仕様書の章節番号(例:1.3や2.3)またはキーワードを指定すると、docs/GEMINI_MANUAL.md等から該当セクションの 行番号付き生行全文 を切り詰めゼロで即座に出力する専用コマンドを追加しました。 -
既存コマンド(
docs/rule/tree --full)の自動全文化 : AI が既存の./scripts/run_kb_search.sh docs "1.3."やrule "2.3"を呼んだ場合でも、引数が章節番号パターンに一致した瞬間にスニペット表示から SQLitedoc_sectionsの生行全文直結モード へ自動切り替えするスマート分岐を実装しました。 -
SQLite 抽出は
2.31ms〜2.42ms、ツール実行全体でも約1〜2秒で完結 : 1,049 行の仕様書から特定章節の全文(19〜71 行・行番号付き)を抽出する処理が SQLite 内部でわずか 2〜3 ミリ秒(シェル起動込みの 1 ツールコール全体でも 約1〜2秒)で完結するようになり、旧方式で毎回発生していた 2 手目の AI 再推論+read_fileの11〜14秒(計14〜17秒)が丸ごと0秒に消滅 しました。
直接読み込みを物理抑止する自動フック連携
さらに、AI エージェントが過去の習慣でいきなり docs/GEMINI_MANUAL.md を read_file しようとした場合に備え、ローカルの検問ブリッジ(hook_bridge)も同時に強化しました。
仕様書を編集する目的以外で read_file が呼ばれた瞬間、フックが自動で 💡 [SQLite 1コール直結ガイド] を返却し、「次回からは ./scripts/run_kb_search.sh manual "<節番号>" で 1 コール取得せよ」と AI の行動をその場で物理的に矯正する管理体制(ガバナンス)を組み込んでいます。
従来の「2 往復参照+直列運用」と、今回の「SQLite 1 コール生行直結+並列分離運用」の構造的な違いを図解すると、次のようになります。
-
仕様書参照が 2 往復(計 14〜17 秒) :1 手目の抜粋検索に約 3 秒、続く AI の再推論と
read_file呼び出しに 11〜14 秒を消費 -
余分な前後行と再送トークン :2 手目の推論で約 7 万〜10 万トークンを再送し、安全マージンの前後行も親文脈へ残留
-
親コンテキストの雪だるま膨張 :複数記事の原稿と出典確認ログが累積し、後半ほど 1 推論あたりの消費が急増
-
1 コール生行全文直結 :SQLite
doc_sectionsから該当章節の全文を 2.31ms(全体約 1〜2 秒)で返し、2 手目の 11〜14 秒をゼロ化 -
フックによる再発抑止 :直接
read_fileすると自動で 1 コール直結ガイドを注入し無駄な読込を遮断 -
5 班独立コンテキスト分離 :
Carbon子エージェント 5 班が原稿読込と出典照合を分担し、終了時に生ログを破棄
また、kb-search Rev. 2.7.0 における 1 コール取得の処理フローは以下の 3 ステップで完結します。
AI が manual "1.3" や docs "2.3." を 1 回だけ呼び出す。
doc_sections と全文テーブルから該当節の行番号付き生行全文を切り詰めゼロで取得。
従来 11〜14 秒要した AI 再推論+read_file なしで本業へ進み、往復トークンを半減。
このように、AI のプロンプトを工夫する前に「AI が叩くローカル CLI ツール側を Rust と SQLite で最適化する」アプローチは、トークン節約において極めて高い報奨(インセンティブ)をもたらします。Rust による高速 CLI やテキスト処理の実装を体系的に学びたい方には、以下の定番解説書が役立ちます。
検証:Carbon並列で1時間6分回した全作業内訳
この kb-search Rev. 2.7.0 の実装を含め、週間枠リセット前の 1 時間 6 分(66 分間) で実際にノンストップ実行した全作業の内訳を整理します。
Google 公式ブログの Gemini 4 Carbon 発表記事 でも示されている通り、Gemini 4 Carbon は複雑な推論やコード・事実監査において最高峰の精度を誇る反面、標準の Gemini 4 Argon と比べて計算負荷(API 単価換算で約 2 倍)が重いモデルです。今回は妥協を排し、親エージェントも 5 班のサブエージェントもすべて Gemini 4 Carbon (High) に統一して以下の 5 大タスクを完遂しました。
-
Rust製
kb-search Rev. 2.7.0の5ファイル実装と全129件の自己診断PASS : SQLite 1 コール生行全文直結機能の実装・ビルドに加え、Pure Rust 検問所gemini-gateの自己診断テスト 76 件 とkb-searchの自己診断テスト 53 件(計 129 件)をすべて一発 PASS させました。 -
未監査差分22記事+サイト全体注意3件の「Carbon 5班並列」深層監査 : 直近の未監査差分 22 記事 とサイト全体の注意項目 3 件 に対し、
Carbon (High)のresearchサブエージェントを 5 班並列 で起動。5 大ハルシネーション類型(公的機関への虚偽帰属、指数・単位換算、法改正・統計年次、型番・年号の 1 文字違い、過去実測値の時点ロック)および独自試算への「推論」明記漏れを徹底監査しました。 -
摘出10記事+数値連動7記事+注意3件=計20記事のピンポイント修正 : 監査で摘出された 10 記事、SQLite
impact検索で芋づる式に特定した数値連動 7 記事、および注意 3 件 の 計 20 記事 をピンポイント改修しました。事実誤認ゼロと判定された無謬の 12 記事 は 1 文字も触れずに完全温存し、段落分割を行った記事は正規化 SHA-256 ハッシュの完全一致証明を実施しました。 -
外部出典URL 105本のライブ死活照合+Decision 1検品(キャッシュ35件ヒット) : 対象記事に含まれる外部出典 URL 105 本 の実ページ疎通・リダイレクト先検証を実行。さらに
Gemini Decision 1による画像 20 枚・記事 20 本 の自動検品を実施しました(ローカル SHA-256 キャッシュが 35 件ヒット したため、ライブ API の入出力トークンは 実質 0 トークン で通過!)。 -
Playwright 1コール統合検証と本番ビルド・SFTPデプロイ完遂 :
browser_run_code_unsafeの 単一コール統合 により、通常の HTTP 取得ではHTTP 403に阻まれる外部サイトの隠れ 404 摘出と、本番公開 6 ページ の実機レンダリング検証(H1・目次・画像自然幅・横はみ出しゼロ)を実行。最終的な Astro 本番ビルドと Xserver への SFTP 転送まで完走し、監査時点の公開 744 記事(本記事を含めた現在の公開総数は 747記事)すべてで エラー 0 件・注意 0 件 を達成しました。
これだけの並列ビルド・SQLite 検索・SHA-256 ハッシュ計算・ヘッドレスブラウザ検証をストレスなく同時にさばく上では、ローカル母艦(macOS)側のマルチコア CPU 性能と高速なメモリ(RAMDisk 活用)も重要な土台になります。
実測:週間枠わずか1%・5時間枠7%消費の衝撃
さて、「これだけ重い Carbon (High) を 5 班並列で動かし、Rust 改修から 22 記事の深層監査、20 記事の修正、本番デプロイまで 1 時間 6 分ぶっ続けで回したのだから、週間枠の残り 19% は半分以上溶けているだろう」と思いながら、作業完了直後に Antigravity の Models & Usage 画面を開きました。
開始前と1時間6分完遂直後のキャプチャ比較
実際の作業開始直前(Before)と、1 時間 6 分の重労働をすべて完遂した直後(After)のスクリーンショットを並べたものがこちらです。
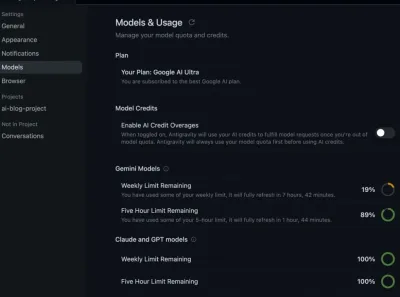
▲ Before(開始前):週間枠 19%(残り7時間42分)/ 5時間枠 89%(残り1時間44分)
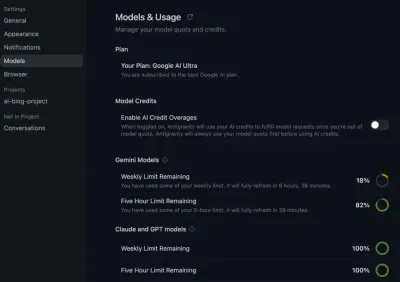
▲ After(1時間6分後):週間枠 18%(わずか -1%)/ 5時間枠 82%(わずか -7%)
ちょっと待って!週間枠を使い切るつもりで一番重い Carbon を 5 班も並列で動かして、プログラム改修と 20 記事の修正まで全部やったのに、週間枠が 19% から 18% へ たった 1% しか減っていない じゃないの!

5 時間枠(Five Hour Limit)の方も 89% から 82% へ 7% 減っただけ だニャ。時計の経過(7 hours, 42 minutes → 6 hours, 36 minutes)を見ても、きっちり 1 時間 6 分フル稼働した直後の数値であることが一目で分かるニャ。
Gemini 4 Carbon (High) を使いながら、Rust エンジンの 5 ファイル実装、22 記事の深層ファクト監査、20 記事の連鎖修正、105 本の外部 URL 検品、そして本番デプロイまでをすべてやり切って 週間枠 1%・5 時間枠 7% で収まったという事実は、ローカル側のアーキテクチャ設計がいかに AI のトークン消費を左右するかを如実に物語っています。
計算単価2倍でもクォータが減らない4つの理由
なぜこれほどの重労働をこなしてもクォータがほとんど減らなかったのか。その理由は、以下の 4 つの省燃費メカニズム が同時に噛み合ったことにあります。
-
SQLite
doc_sections1コール直結(抽出2.31ms/2手目の11〜14秒をゼロ化) : 1,049 行の仕様書から必要な節だけを 1 ツールコール(シェル起動込み約 1〜2 秒)で取得し、従来 2 手目で発生していた AI 再推論+read_file(11〜14秒の待ち時間と約 7 万〜10 万トークンの再送信)を完全にゼロ化しました。 -
researchサブエージェント5班の独立小コンテキスト分離 : 親エージェントが 22 記事の本文や 105 本の出典ページを直接読み込むと、親の会話履歴が雪だるま式()に膨れ上がります。これを 5 班のresearch子エージェントに 4〜5 記事ずつ排他分担させ、「生原稿と外部 URL の読み込みログは子エージェントの終了とともにメモリから破棄し、親には数百文字の構造化監査レポートだけを返す」 ことで、親コンテキストの KV キャッシュ効率を高水準に維持しました。 -
Pure Rust
gemini-gateの4ms機械検問とSHA-256キャッシュ(35件ヒット) : 文字数・見出し・リンク整合のチェックをすべて 4 ミリ秒のローカル Rust バイナリへ肩代わりさせ、さらにGemini Decision 1の意味検品でも SHA-256 ハッシュキャッシュが 35 件ヒット したことで、ライブ API の入出力トークンを 0 トークン に抑え込みました。 -
Playwright
browser_run_code_unsafe単一コール統合 : 従来の「navigate→evaluate→close」の 3 分割呼び出し(毎ステップで巨大な DOM スナップショットがコンテキストへ流れ込む現象)を廃止し、1 つの非同期関数内でページ遷移から DOM 検査・クローズまで完結させる 1 コール統合を徹底しました。
今回の実測データと、もしこれらの最適化を行わずに「無防備な直列・丸読み運用」で同じ作業を Carbon (High) に実行させた場合(推論・過去ログ比試算)のクォータ消費率を比較すると、その差は一目瞭然です。
さらに、各工程における従来手法と今回の最適化手法の定量スペックを表にまとめます。
| 比較項目 | 従来の標準的な AI エージェント運用 | 今回の 4 重最適化運用(kb-search Rev. 2.7.0 ほか) |
実測での削減・高速化効果 |
|---|---|---|---|
| 仕様書(1,049行)の章節参照 | 1 手目スニペット検索(約 3 秒[SQLite 11〜24ms])+ 2 手目 AI 再推論・read_file(11〜14 秒)= 2 往復・計 14〜17秒 |
SQLite doc_sections から 1 コール生行全文直結(2 手目の read_file 0 回・0 秒) |
SQLite 抽出 2.31〜2.42ms(全体 約 1〜2 秒) / 所要時間を約 10 分の 1 に短縮&往復半減 |
仕様書の直接 read_file 防止 |
AI の裁量任せ(たびたび数百行を直接読む) | hook_bridge が自動で 1 コール直結ガイドを注入 |
無駄なファイル丸読みを 物理的に抑止 |
| 22 記事監査+出典 105 本照合 | 親エージェントが直列で読み込み文脈が 膨張 | Carbon 5 班並列 research で生ログを子終了時に破棄 |
親コンテキストの肥大化遮断・KV キャッシュ維持 |
| 画像 20 枚・記事 20 本の意味検品 | 毎回ライブ API を呼び出してトークン消費 | Pure Rust gemini-gate + SHA-256 キャッシュ 35 件ヒット |
ライブ API 入出力 0 トークン |
| Playwright 実機・外部 403 検証 | navigate / evaluate / close の 3 分割呼び出し |
browser_run_code_unsafe 単一コール統合 |
巨大 DOM スナップショット混入ゼロ・1 ターン完結 |
| 1 時間 6 分稼働後のクォータ消費 | 5 時間枠 約 45〜60%・週間枠 約 8〜12%(推論) | 5 時間枠 7%(89%→82%)・週間枠 1%(19%→18%) |
最重量 Carbon 並列でも 週間枠 1% で完走 |
追試:Swarm7体と51記事改修でも週間枠2%消費
「22 記事の監査と 20 記事の修正でたった 1% しか減らないなら、さらに規模を倍増させて Swarm(自律協調エージェント群)7 体で 50 本以上の記事を一斉に改修・新規執筆させたら、さすがに週間枠が大きく減るのでは?」――そう考え、週間枠リセットまでまだ数時間残っていたタイミングですぐさま 第 2 弾の連続ストレステスト を敢行しました。
第 2 弾では、親の Gemini 4 Carbon (High) を司令塔とし、共有メッセージボード上で以下の 計 7 体のワーカー+画像生成サブエージェント を並列稼働させ、合計 51 記事 に及ぶ大規模タスクを一気通貫で処理させました。
-
Search Console 未登録 31 記事の
Carbon4 班並列強化 : Search Console APIによる非開示クエリ・インデックス自動診断基盤 で抽出した「クロール済み - インデックス未登録」12 件および「検出 - インデックス未登録」19 件の計 31 記事 を、Gemini 4 Carbon (High)の 4 ワーカーでファイル排他分割。既存の強みを 100% 温存したまま、検索意図の補強と一次出典インラインリンクの追加を完遂しました(なお、単純なローカル整形や事前マスキングには macOS 27標準のオンデバイスAIコマンドfmのような API 代 0 円ツールとの役割分担も有効です)。 -
主力エース・ハブ 19 記事からの双方向内部リンク結線 : 未登録記事へのクローラー導線を太くするため、流入上位のエース記事および各部ハブ記事 19 本 に対し、テーマ整合性の高い双方向内部リンクを結線しました(ここまでで既存 50 記事 を改修)。
-
Swarm Argon Highによる新規記事執筆+親Carbon監査(51記事目) : 第 1 弾の実測データをまとめた本記事の初稿(図解・グラフ・比較表を含む約 410 行)を長文執筆に強いGemini 4 Argon (High)ワーカーに書き下ろさせ、親Carbon (High)で一次事実の裏取り監査を実施しました。 -
全公開記事の一斉ゲート検問・本番デプロイ・Playwright 実機検証 : 進行監視の
monitorワーカーを含む計 7 体体制で全工程を走り切り、全記事エラー 0 件での Astro 本番ビルド、SFTP 転送、Playwrightbrowser_run_code_unsafe単一コールでの本番表示検証まで完遂しました。
この「Swarm 7 体稼働・計 51 記事改修&新規公開」という超大型バッチを完走した直後に撮影した、Models & Usage 画面の実測スクリーンショットがこちらです。
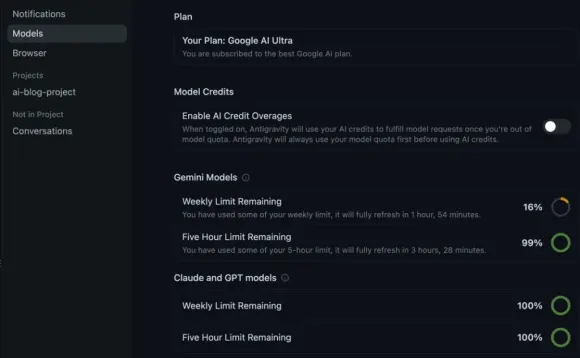
▲ 第2弾完遂直後(残り1時間54分時点):週間枠 18% → 16%(51記事処理でわずか -2%!)/ リフレッシュ後の5時間枠も 100% → 99%(-1%)
な、なんと……!Swarm を 7 体も立ち上げて、31 本の未登録記事と 19 本のハブ記事を直し、さらに新規記事まで 1 本丸ごと書いて本番公開したのに、週間枠が 18% から 16% へたった 2% しか減っていない のですか!?
はい!途中で 5 時間枠の自動リフレッシュ(100% 回復)を挟みましたが、後半の統合監査・ビルド・Playwright 実機検証まで終えた時点でも 5 時間枠は 99%(わずか -1%) を維持していました。第 1 弾と第 2 弾を合算しても、延べ 73 記事の監査・改修・新規執筆と Rust エンジン改修を回して、週間枠の累計消費はたった 3%(19% → 16%) です!
第 1 弾と第 2 弾の連続実証データを並べると、SQLite 1 コール直結とコンテキスト分離がいかに安定した再現性を持っているかが明確に分かります。
| 実証フェーズ | 稼働体制(モデル構成) | 完遂した実作業ボリューム | 週間枠の推移(実測) | 5時間枠の推移(実測) |
|---|---|---|---|---|
| 第 1 弾(基礎+深層監査) | 親 Carbon + research 5 班並列 |
Rust kb-search 5 ファイル改修 + 22 記事監査・20 記事修正 + 出典 105 本照合 |
19% → 18%( -1% 消費) |
89% → 82%( -7% 消費) |
| 第 2 弾(大規模一斉強化) | 親 Carbon + Swarm 7 体(Carbon 4・Argon 1・monitor 1 他) |
GSC 未登録 31 記事強化 + ハブ 19 記事結線 + 新規 1 記事執筆(計 51 記事) | 18% → 16%( -2% 消費) |
リセット後 100% → 99%(仕上げ -1% 消費) |
| 第 1 弾+第 2 弾 累計 | 最上位 Carbon High × Argon High 協調 |
Rust 基盤改修 + 延べ 73 記事処理 + 本番デプロイ 2 回完遂 | 19% → 16%(累計 -3%) |
天井到達ゼロで余裕完走 |
2.31ms)と Swarm・サブエージェントによる排他コンテキスト分離を組み合わせれば、50 記事規模の一斉メンテナンスですら週間枠 2% 前後で日常的に回せる ことが連続実測によって証明されました。
試算:Ultra各プランの消費換算と時間単価
Google 公式ヘルプ「Gemini アプリの利用上限とアップグレード」 に記載されている通り、上位プランである Google AI Ultra には利用倍率に応じたクォータ枠が設定されています。今回の実測結果(Ultra 20x で週間 1%・5 時間 7% 消費)をもとに、各プランでの実用性と時間単価を検証してみましょう。
Ultra 5xでも週間約4%で完走できる計算
まず、倍率比から導き出される重要な気づきは、「ローカルの SQLite 直結とサブエージェント分離さえ整っていれば、月額 14,500 円の『Google AI Ultra 5x』でも、このクラスの大型監査とシステム改修を余裕で回せる」 という点です。
Ultra 20x の 4 分の 1 の利用枠である Ultra 5x に単純換算すると、今回の 1 時間 6 分の重労働(Rust 5 ファイル改修+Carbon 22 記事監査+20 記事修正+105 出典検品+デプロイ)を丸ごと実行しても、週間枠は約 4%、5 時間枠は約 28% の消費(推論・単純倍率試算) で収まる計算になります。5 時間制限の天井(100%)に対して 7 割以上の余力を残して完走できるため、途中で作業がロックされる心配がありません。
逆に、ローカル側の検索や検問を整えずにファイルを丸読みさせ続ければ、どれほど大容量の Ultra 20x(月額 32,000 円)を契約していても、親コンテキストの雪だるま膨張によってあっという間に枠を食い潰してしまいます。
1時間あたり約133円で最上位監査官を雇う価値
また、Google AI Ultra 20x の月額料金(約 32,000 円)は、単なる「チャットツールの月額課金」として見ると高額に感じられるかもしれません。しかし、今回のように自分は方針を出すだけで手を汚さず、最上位モデル Gemini 4 Carbon (High) に Rust コードの実装から 22 記事の一次出典裏取り、20 記事の連鎖修正、本番サーバーへの反映・ブラウザ実機検査までを一気通貫で代行させる 「自律開発エンジンの稼働費」 として日割り・時間単価で試算(推論)すると、見え方がまったく変わります。
-
Google AI Ultra 20x(月額 32,000 円目安)の場合 : 1 ヶ月(30 日)で割ると 1 日あたり約 1,067 円。毎日 8 時間、AI エージェントに開発・執筆・全記事監査を自律稼働させる場合、1 時間あたりの快適コストは約 133 円(推論・時間単価試算) です。今回の 1 時間 6 分の重労働(週間枠 1% 消費分)を金額換算すれば、わずか 約 80〜150 円相当(推論) のコストで人間なら丸 2〜3 日かかる 22 記事のファクト監査とシステム改修が終わった計算になります。
-
Google AI Ultra 5x(月額 14,500 円目安)の場合 : 30 日換算で 1 日あたり約 483 円、1 日 8 時間稼働なら 1 時間あたり約 60 円(推論・時間単価試算) です。壁打ちや中規模のブログ・システム開発であれば、本記事の省燃費設計を取り入れることで 5x プランでも十分お釣りが来る強靱性(レジリエンス)を発揮します。
見栄のための外食や使わないサブスクリプションに数千円を払うのと比べれば、「1 時間あたり約 60 円〜133 円(推論)で、365 日文句も言わずに働く最上位の専属エンジニア兼ファクト監査チームを持てる」 というのは、個人開発者やコンテンツ制作者にとってこれ以上ない収益化(マネタイズ)と時間創出の武器になります。
まとめ:自身の環境へ導入するコピペ用プロンプト
今回の検証結果をまとめます。
-
実行ログの直視による「2往復・計14〜17秒の無駄」の発見 : AI に性能を尋ねると「十分出ている」と答えがちですが、実際にチャット内のツール実行ログ(事実)を観察したことで、135 文字スニペットの不足分を補うために裏で禁止していた
read_fileが呼ばれ、1 手目(約3秒)+ 2 手目の AI 再推論・read_file(11〜14秒)で 合計14〜17秒を浪費していた構造を突き止めました。 -
SQLite 1コール生行全文直結(
kb-search Rev. 2.7.0) : 章節番号やキーワード指定時に SQLite のdoc_sectionsテーブル等から行番号付き全文を SQLite 抽出2.31ms〜2.42ms(ツール全体でも約1〜2秒)・1 コール で直接返すよう改修し、2 手目の11〜14秒を丸ごとゼロ化するとともに未編集時の直接read_fileをフックで自動抑止しました。 -
1時間6分の重労働で週間1%・5時間7%消費 : 最上位モデル
Gemini 4 Carbon (High)を用い、Rust 5 ファイル改修、22 記事の 5 班並列監査、20 記事修正、出典 105 本照合、Playwright 1 コール検証、本番デプロイまで完遂して 週間枠19% → 18%(-1%)・5 時間枠89% → 82%(-7%) という驚異の低燃費を実証しました。 -
追試のSwarm 7体・51記事改修でも週間2%消費 : 直後に実施した第 2 弾ストレステスト(未登録 31 記事強化+ハブ 19 記事結線+新規 1 記事執筆の計 51 記事処理)でも 週間枠
18% → 16%(-2%)・リセット後 5 時間枠100% → 99%(-1%) に収まり、延べ 73 記事処理で累計わずか3%という高い再現性を確認しました。
Carbon や Argon)を贅沢に並列稼働させること です。
最後に、読者の皆さまがご自身のプロジェクト環境(Antigravity / VS Code / Claude Code 等)へ、本記事の「仕様書の SQLite 1 コール章節直結+サブエージェント省燃費運用」を導入するためのコピペ用プロンプトをご用意しました。
※環境構築の失敗や手戻りを防ぐため、必ず『Gemini 4 Argon』または『Gemini 4 Carbon』等の最上位推論モデルを選択した上で、以下のプロンプトを貼り付けて実行してください。
あなたは私の熟練した開発パートナーです。
まず以下の実機検証記事URL(またはその設計内容)を読み込み、当プロジェクトの現在のファイル構成・ルールファイル(GEMINI.md / CLAUDE.md / docs等)・スクリプト環境を事前調査してください。

【参照記事】
https://lab.chihouzakki.com/blog/review/sqlite-1call-manual-carbon-audit-1percent-quota-guide/

【実現したいゴール】
1. 長大な仕様書・ルールファイルを参照する際、「1手目の検索スニペット取得(約3秒) → AI再推論と2手目の read_file(11〜14秒)」という2往復が発生しないよう、SQLite(doc_sectionsテーブル等)から章節番号または見出し指定で「行番号付きの生行全文」を1ツールコール(数ミリ秒)で直接返す検索コマンドを整備すること。
2. 複数ファイルや複数記事の監査・調査を行う際は、親エージェントが直接ファイルを抱え込んでコンテキストを O(N^2) 膨張させるのを防ぎ、サブエージェント(3〜5班並列)に排他分担させて構造化要約のみを親へ返させる運用ルールを定義すること。
3. ブラウザ検証(Playwright等)や定型チェックを行う際は、複数回のツール分割呼び出しを避け、1コール統合またはローカルスクリプトへオフロードすること。

※いきなりファイルを書き換えず、また局所的な数値だけを見て「すでに十分性能が出ている」と自己判断せず、実際の検索コマンドの出力仕様とAIのツール呼び出し挙動という「事実」を調査した上で、裏で無駄な read_file や2往復が起きない実装計画(Implementation Plan)を提示し、私の合意を得てから実装を開始してください。
週間枠を使い切るつもりが、第 1 弾の 22 記事監査で 1%、第 2 弾の 51 記事改修まで連続で回しても累計 3%(残り 16%)しか減らず、嬉しい誤算でまだまだたっぷり開発を続けられそうです。皆さまの AI 開発環境がより速く、より快適になる一助となれば幸いです!
