ブログ720記事のビジネス用語をAI×Rustで一括校正|172記事修正でもCarbon週間枠1%消費の実測録
公開記事が増えてくると、「過去の記事に混ざっている分かりにくいカタカナのビジネス用語や、二重表現を一気に綺麗にしたい」と思う場面が必ず訪れます。しかし、数百本もの記事を AI エージェントに 1 本ずつ開かせて書き換えさせたら、時間も利用枠(クォータ)もあっという間に溶けてしまいます。
結論からお伝えすると、当サイトの公開 720 記事(検証時点の母数:AI国家構想 386 本+検証録 334 本、本記事公開時点で計 729記事)を丸ごと検査し、最上位モデル『Gemini 4 Carbon』に Pure Rust 製の一括補正器を書かせて 172 記事(259 行)の日本語・ビジネス用語修正と本番サーバー転送まで完遂した結果、Google AI Ultra の週間利用枠(Weekly Limit)の消費はわずか 1%(53% ➔ 52%)・5 時間枠も 3%(94% ➔ 91%) で収まりました。本記事では、最初にサブエージェント 5 体を乱立させて 7 分間足止めを食らった失敗からの軌道修正、ドライラン 700 行の全行検閲で防いだ「単純置換 4 つの罠」、そして証拠スクリーンショット 2 枚と 1 トークン単位の生ログデータを包み隠さず公開します。
-
Gemini Decision 1実測検証|出力0トークン判定APIとRust・Carbonの3層分担 : 出力トークン0ドルの判定特化モデル『Gemini Decision 1』をPure Rustから実機検証し、画像検品・RSS仕分けとCarbonの3層分担をまとめた実測録です。
-
AI記事のハルシネーション退治にGemini 4 Carbonが必須な理由|全721記事監査で443本修正した実測録 : 本記事の Pure Rust 一括置換では原理的に退治できない「意味レベルの事実誤認」を、Gemini 4 Carbon の 35 班並列監査(実働 1 時間 54 分)で一掃した対照実験の実測録です。
-
Gemini 4 Carbonで全記事・Astro・Swift・RAMDiskを監査|隠れバグ根治とArgon分担 : 『Gemini 4 Carbon』によるサイト全体・インフラ深層監査で隠れバグを根治し、「監査・開発は Carbon、執筆は Argon」の最適分担を確立した実録です。
-
Gemini 4 Carbonの30分停止を防ぐ常時並列化|Rust検問でArgonも進化 : サブエージェント並列を使うべき場面と、親コンテキストの肥大化を防ぐ Pure Rust 自動ストッパーの仕組みを解説しています。
-
Gemini 4 CarbonとArgonで同じ記事を作らせた実測比較|時間・料金2.55倍差と生記事公開 : 最上位モデル『Gemini 4 Carbon』と高速な『Argon』の処理時間・トークン量・得意分野の違いを同一条件で比べた実測検証録です。
-
AIブログ記事数が85本から爆発した5世代全記録|Argon移行と全Rust化の実測 : 当サイトの公開記事数が 85 本から 700 本超へと急成長した 5 世代の進化と、Pure Rust 自動化基盤の歩みをまとめた定点記録です。
-
100 本〜数百本規模に増えたブログ記事の 表記揺れ・ビジネス横文字・二重表現(「まず最初に」など)を一括で綺麗に直したい方
-
最上位モデル 『Gemini 4 Carbon』でサイト全体の大規模メンテナンスを回すと、Google AI Ultra の利用枠が実際どれくらい減るのか 証拠画像つきで知りたい方
-
単純な一括置換(正規表現やエディタ置換)で起きがちな 「二重括弧」「専門用語の誤変換」「見出し文字数オーバー」を防ぐ実践的な設計 を取り入れたい方
なぜ「カタカナのビジネス用語」を全720記事から一掃したのか
発端は、公開記事が 720 本(AI国家構想 386 本・検証録 334 本)に達したタイミングでの、とても素朴な疑問でした。

全記事なんだけど、日本語の使い方は完璧かな?時々ちょっと変なのがあるし、ビジネス用語のカタカナがそのまんま出てくると、普通の人にはピンとこんのよな!

おっしゃる通りです!「パソコン」「スマホ」「アプリ」「データ」のように日常生活に溶け込んでいるカタカナ語はそのままの方が自然ですが、会議室やビジネス書でしか使われないカタカナ語が説明なしに並んでいると、読者の方の読むリズムがそこで止まってしまいますよね。
とくに AI と壁打ちしながら専門的な記事や制度解説を書いていると、AI は学習データの癖でついつい `ボトルネック` や `スキーム`、`ガバナンス`、`インセンティブ` といったビジネス界隈のカタカナ語を裸のまま出力しがちです。
そこで今回、単なる気まぐれな手直しではなく、サイト全体の恒久ルール(現在のルールブック規模は合算 1,341行)として 「普通の人が日常で使っているカタカナ語はそのまま残し、ビジネス用語は平易な日本語にするか、必ず『日本語(カタカナ)』で併記する」 という明確な基準を定めました。
普通の人に届く「日本語(カタカナ)」8つの確定ルール
全 720 記事の本文を SQLite 全文検索データベース(SQLite 公式 FTS5 仕様)で横断集計し、出現頻度が高かったビジネス系カタカナ語と日本語の癖に対して、以下の確定変換ペアを定義しました。
| 対象カテゴリ | 修正前の表現(裸のビジネス用語・重言) | 確定した統一表記(文脈連動) | 備考・例外保護ルール |
|---|---|---|---|
| ビジネス用語① | `ボトルネック` |
最大の障壁(ボトルネック) | 前に修飾語がある場合は 障壁(ボトルネック)。「フォン・ノイマン・ボトルネック」は固有名詞として保護 |
| ビジネス用語② | `スキーム` |
枠組み(スキーム) | 名詞直結時は の枠組み(スキーム)。「ポンジ・スキーム」「URIスキーム」は保護 |
| ビジネス用語③ | `レジリエンス` |
強靱性(レジリエンス) | 既存の部名(完全レジリエンス実証など)は保護 |
| ビジネス用語④ | `ガバナンス` |
企業文脈:管理体制(ガバナンス) 国家文脈:統治体制(ガバナンス) |
企業・社内・検証録では「管理体制」、国家統治では「統治体制」へ自動振り分け |
| ビジネス用語⑤ | `インセンティブ` |
報奨(インセンティブ) | 逆インセンティブ は 逆方向の報奨(逆インセンティブ) へ変換 |
| ビジネス用語⑥ | `エビデンス` |
裏付け(エビデンス) | 科学的エビデンス は 科学的な裏付け(エビデンス) へ変換 |
| ビジネス用語⑦ | `トレードオフ` |
二律背反(トレードオフ) | 既に直後へ括弧説明がある場合は単一括弧へ統合 |
| ビジネス用語⑧ | `マネタイズ` |
収益化(マネタイズ) | 単独タグやリンクURLは非破壊で保護 |
| 二重表現・句点 | `まず最初に` / `一番最初` / `。。。` |
まずは・最初に / 最初 / …。 | 文頭は「まずは」、助詞「を」の直後は「最初に」へ文脈補正 |
さらに、直した後に将来の新規記事でまた同じ言葉が混入しないよう、デプロイ前に自動実行される Pure Rust 製の品質ゲートキーパー(gemini-gate)にも検問ルールを追加し、「既存の全記事修正」と「今後の自動ブロック」の両方を同時に仕上げる ことにしました。
最初の7分で判明!Carbon5班並列の待ち時間トラップ
ここで最初にやってしまった「リアルな失敗」も正直に共有しておきます。
2026 年 11 月 10 日に一般開放されたばかりの最上位モデル『Gemini 4 Carbon』(Google 公式一般開放発表ブログ)を使っていた私は、最初うっかり「720 記事を 5 つの領域に分けて、調査用サブエージェント 5 班に日本語の不自然な箇所を探させよう」と並列起動をかけてしまったのです。
おいおい、最初にエンターを押してから 7 分経過しとるぞ!まだ調査が終わらんのか!?

Carbon さんが 5 人同時にうんうん唸って考え込んでるでちぃ……!文字を探すだけなのに大げさでちぃ!
まさにその通りでした。Gemini 4 Carbon は複雑なアーキテクチャ設計や難解なバグ特定では世界最高峰の推論力を発揮しますが、1 ステップごとの思考が深いため、定型的な全件語句スキャンに 5 体も同時投入すると待ち時間が大きく膨らみます。
しかも作業完了後にセッション生ログを解析したところ、最初のわずか 5.6 分間で動かしたサブエージェント 5 体だけで、新規入力(Fresh Input)を 1,054,739 トークンも消費していた ことが判明しました(その場で即座にサブエージェントを全停止しました)。
全件スキャンはAIではなくローカル高速処理に任せる
そこで方針を 180 度切り替え、全記事の語句カウントは手元の SQLite データベースに対する 1 パス集計(SUM(CASE WHEN ...))へ移しました。すると、さっきまで 7 分待っても終わらなかった 720 記事の横断調査が わずか 0.3 秒(AI トークン消費ゼロ) で完了したのです。
その上で、170 本を超える記事の書き換えも「AI に 1 ファイルずつ開いて編集させる」のではなく、以下のハイブリッド手順で進めました。
-
AI(またはサブエージェント群)が 170 本の
.mdxファイルを直接読み込み、1 本ずつ書き換えツールを呼び出す -
クラウド推論の往復が何百回も発生し、数百万トークンと数十分〜1 時間以上の待ち時間がかかる
-
ファイルごとに微妙な訳語のブレや、関係ない箇所の意図しない書き換えが混じるリスクがある
-
Gemini 4 Carbonは「文脈判定と安全ガードを備えた Pure Rust コードの実装」だけに集中する -
--dry-runで抽出された対象 259 行(変更前後の差分出力 約 700 行)を AI が 1 行残らず目視検閲してエッジケースを潰す -
検閲合格後にローカル CPU が全 170 記事を数秒(AI トークン消費ゼロ)で一括更新し、個別 2 記事だけ手直しする
ドライラン全700行の検閲で見抜いた「単純置換」4つの事故
ここで読者の方から、きっとこんな疑問が出るはずです。
ちょっと待って!プログラムで機械的に一括置換なんかしたら、専門用語まで変な日本語に化けたり、括弧が二重になったりして記事が壊れるんじゃないの?
そこが一番の急所なんです!だからこそ、いきなり本番ファイルを書き換えるのではなく、まず変更予定の前後行だけを書き出す「ドライラン(予行演習モード)」を実行し、出力された約 700 行の差分を Gemini 4 Carbon が 1 行ずつすべて検閲しました。
実際、1 回目のドライラン出力を全行チェックしたところ、単純な置換のまま実行していたら確実に起きていた 「4 つのリアルな事故」 が見つかり、本番反映の前にすべてプログラム側で根絶できました。
一時マーカーと固有名詞保護で誤変換をゼロにする
-
複合語と単体語の連続ヒットによる「入れ子二重括弧」 :たとえば
構造的ボトルネックを先に構造的な障壁(ボトルネック)に置換したあと、同じ行に対して単体の`ボトルネック`置換が走ると、括弧の中の言葉に再反応して構造的な障壁(最大の障壁(ボトルネック))という不気味な二重括弧が生まれてしまいます。これを防ぐため、置換中は一時マーカー(\x01J_BN\x01等)へ退避させ、すべての語句判定が終わった最後に 1 回だけ丸括弧へ展開する仕組みを入れました。 -
もともと括弧説明がある箇所の「丸括弧2連続」 :元の記事ですでに
トレードオフ(二律背反)や3 つの物理的ボトルネック(32GB天井…)と書かれていた箇所をそのまま置換すると、二律背反(トレードオフ)(二律背反)のように括弧が 2 つ並んでしまいます。直後に既存の丸括弧があるパターンを事前検知し、単一の自然な括弧へ統合する前処理を追加しました。 -
プログラム規格名・確立した固有名詞の誤変換 :Web セキュリティ記事に登場する
`javascript:` スキームは金融や制度の「枠組み」ではなく URL のプロトコル指定(URI scheme)です。これを「枠組み」に誤変換しないよう`javascript:` URIスキーム(プロトコル指定)へ分離し、フォン・ノイマン・ボトルネックやポンジ・スキーム、コーポレートガバナンスなどの固有名詞は保護リストで完全除外しました。 -
見出し(H2・H3)の文字数上限オーバーによる目次2行折り返し :当サイトではデスクトップの目次(TOC)が美しく 1 行に収まるよう、H2 は 30 文字以内・H3 は 28 文字以内という厳格な上限を設けています。見出しに『日本語(カタカナ)』を入れると上限を超える場合のみ、自動で括弧を外して平易な日本語単独(
枠組み・障壁など)へフォールバックさせ、目次崩れをゼロに保ちました。
この改修を入れて 2 回目のドライラン全 700 行を再検閲し、不自然な日本語やリンク・コード破損が 0 件 になったことを確認してから本実行をかけました。結果として、170 記事(259 行)の一括補正+個別 2 記事(同語反復 調べるには…使って調べます ➔ 使います、句点連続 。。。 ➔ …。、重言 まず一番最初の ➔ まずは最初の)の修正で、全 720 記事がエラー 0 件・日本語注意 0 件で一発通過しました。
証拠スクショ公開!172記事直して週間枠1%消費の生データ
では、これだけの全件作業を最上位モデル『Gemini 4 Carbon』でやり切った前後で、Google AI Ultra(Google One 公式プラン案内)の利用枠(Models & Usage)がどう変化したのか、実際のスクリーンショットを並べて確認してみましょう。
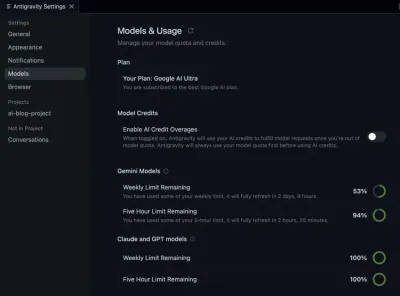
▲ 本作業開始前(23:35 時点):週間残量 53% / 5 時間残量 94%(残り 2 時間 25 分)
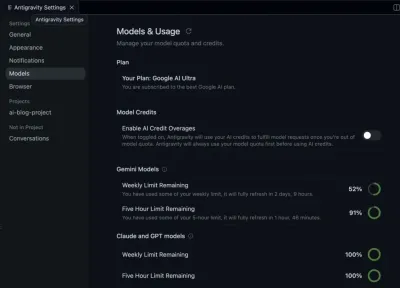
▲ 全工程完了直後(00:14 時点):週間残量 52% / 5 時間残量 91%(残り 1 時間 46 分)
注目していただきたいのは、Five Hour Limit Remaining の下にあるリセットまでの残り時間表記です。左の画像では in 2 hours, 25 minutes(145 分)、右の画像では in 1 hour, 46 minutes(106 分)となっており、差はきっちり 39 分(23 時 35 分 ➔ 00 時 14 分) 一致しています。つまり画面の更新忘れ(古いキャッシュ表示)ではなく、間違いなく全作業終了後に再取得された確定値です。
キャッシュ再利用率92.6%が生んだ圧倒的な省燃費
なぜ最上位の Gemini 4 Carbon を 81 回も呼び出しながら、ここまでクォータが減らなかったのでしょうか。手元のログ解析器(kb-search brain)で抽出した、本セッションの正確なトークン内訳がこちらです。
計測区分(セッション 04af1996 実測) |
API呼出 / 稼働時間 | 新規入力(Fresh Input) | キャッシュ再利用(Cache Read) | AI出力(Output) | 特徴・クォータへの影響 |
|---|---|---|---|---|---|
| 親セッション全体(設計・実装・検閲・本番転送) | 81 回 / 35.7 分 | 851,558 tok | 10,674,668 tok(92.6%) | 123,232 tok | コンテキストの 9 割超が高速キャッシュ再利用(Gemini Context Caching 仕様)で超低負荷 |
| うち初期ミス分(途中停止した調査Sub 5体) | 5 体 / 5.6 分 | 1,054,739 tok | 3,030,478 tok | 54,982 tok | たった 5.6 分のサブエージェント乱立の方が、親の 35.7 分間より新規入力を多く消費 |
| ローカル Pure Rust 一括補正(170記事・259行) | ローカル 1 発 / 数秒 | 0 tok | 0 tok | 0 tok | 事前バックアップ+アトミック書き込み込みで AI トークン消費は完全ゼロ |
グラフで視覚化すると、その構造が一目で分かります。
ご覧の通り、「最初の 5.6 分間でサブエージェント 5 体を乱立させた新規入力(105.5 万 tok)」よりも、「その後の 35.7 分間で親の Carbon 1 体が Rust 実装・700 行検閲・172 記事更新・テスト・デプロイまで全部やり切った新規入力(85.2 万 tok)」の方が少なかった のです。
週間枠1%(約80円相当)で丸3日分の校正が終わる価値
これを日常の「時間単価(タイム・イズ・マネー)」で試算(推論)してみましょう。
最上位プランである Google AI Ultra 20x(月額 32,000 円)は、1 ヶ月を約 4.3 週とすると 1 週間あたり約 7,440 円、つまり 週間利用枠 1% あたりの実質コストは約 74〜80 円(缶コーヒー 1 本以下) という計算になります。
もし人間が 720 本の記事を 1 本ずつ目で読み返し、259 箇所のビジネス用語を文脈に合わせて『日本語(カタカナ)』へ書き換え、見出し文字数やリンク切れをチェックして本番サーバーへ反映しようとしたら、どんなに速い編集者でも丸 2〜3 日(16〜24 時間)の重労働になります。それが「自分は方針(訳語ペア)を決めてエンターを押すだけ」で約 32 分後には完了し、消費した枠は約 80 円相当で済むのですから、これほど費用対効果の高い時間の買い方はありません。
また、Astro で静的ビルドした 4,291 個の HTML・画像ファイルをわずか数秒の差分転送(rsync / SFTP)で一発反映でき、訪問者にミリ秒単位で配信できるのは、土台のレンタルサーバーの応答性能と安定性があってこそです。WordPress のような動的プログラムの脆弱性に怯えず、大量の記事資産を安全・高速に運用したい方には、当サイトでも愛用している定番の『エックスサーバー』が間違いのない選択肢になります。
エックスサーバー(XServer)国内シェアNo.1 高速・高安定レンタルサーバー
第5世代AMD EPYC™&全ストレージNVMe RAID10構成。WordPressクイックスタート対応はもちろん、Astro等の完全静的HTML高速配信の母艦としても抜群の安定性と緊急セキュリティ即応力を誇ります。
まとめ:大量記事の品質改善を最小クォータで回すプロンプト
今回の 720 記事一括校正を通じて実証されたポイントを整理します。
-
このやり方で幸せになる人 :数十本〜数百本以上のブログ記事や社内ドキュメントを抱えており、クォータ(利用枠)をほとんど減らさずに表記統一・用語改善・今後の再発防止リンターまで一気に整えたい方。
-
サブエージェント並列を使うべき場面との違い :記事ごとに構成や主張をゼロから書き下ろす「意味のリライト」では並列サブエージェントが有効ですが、今回のような 「明確な基準に基づく全件検査・表記統一」ではサブエージェントを乱立させず、ローカル高速プログラム(Rust 等)+ドライラン全行検閲 にする方が圧倒的に速くて低燃費です。
-
購入した理由・お勧めの理由(Google AI Ultra × 静的サイト基盤) :最上位の頭脳に「道具(検査・補正プログラム)そのもの」を作らせることで、記事数が 500 本、700 本、1,000 本へと増えてもメンテナンスの手間とクォータ消費が増えない「複利の資産」が手に入ります。
ご自身のブログや Markdown ドキュメント資産でも、同じように「ドライラン検閲つきの安全な一括用語補正」を AI に組ませたい場合は、軽量モデル(Flash 系など)ではなく 必ず『Gemini 4 Argon』または『Gemini 4 Carbon』などの最上位推論モデル を選び、以下のプロンプトをそのままコピー&ペーストして渡してみてください。
以下の記事の実証手順を参考にして、私のプロジェクト内の記事(Markdown / MDX)に含まれる「分かりにくいカタカナのビジネス用語や二重表現」を安全に統一したいです。
参考URL: https://lab.chihouzakki.com/blog/review/blog-720-jargon-proofread-rust-carbon-1percent-quota/

【厳守してほしい手順】
1. いきなり記事ファイルを1本ずつ開いて書き換えるのではなく、まずプロジェクト内の全記事を高速検索し、どのビジネス用語や二重表現が何件あるか一覧表で報告してください。
2. 私が承認した訳語ペア(例:ボトルネック=最大の障壁(ボトルネック)など)に基づき、コードブロック・インラインコード・リンクURL・既存の丸括弧・固有名詞を壊さず、入れ子括弧も防ぐ補正スクリプト(`--dry-run` モード付き)を作成してください。
3. 本実行の前に必ず `--dry-run` の全差分をあなた自身が1行ずつ検閲し、文脈の不自然さや見出し文字数オーバーが0件であることを確認してから、事前バックアップ付きで反映してください。
720 本ぜんぶピッカピカの日本語になったのに、ゲージは 1% しか減ってないでちぃ!浮いた時間とクォータで、またゆっくりお昼寝できるでちぃ〜。
