Gemini 4 Carbonの30分停止を防ぐ常時並列化|Rust検問でArgonも進化
前回の全サイト総点検で 「監査・開発・環境構築は Gemini 4 Carbon、長文執筆は Gemini 4 Argon」 という二刀流を確立した直後のことでした。意気揚々と Gemini 4 Carbon に「サイト全体診断+新規 Web 計算ツール 2 本+新規 Q&A 記事 1 本+既存 UI 改修 4 本」という実戦的な複合開発を任せたところ、まさかの 2 回連続で稼働 30 分〜49 分目に Model unavailable, retrying in 76s のエラー停止 を食らってしまいました。
実行ログ(transcript.jsonl)を自作の解析エンジンで解剖すると、原因はモデルの不具合ではありませんでした。「監査(読み取り)だけサブエージェントに並列で任せても、10 ファイルを超える書き込み実装を親エージェント 1 人で直列に抱え込めば、過去のコードと思考ログが毎ステップ雪だるま式に再送され、親のキャッシュ読込だけで約 847 万トークン・純稼働約 30 分に達して通信ストリームが限界を迎える」という構造的な罠だったのです。
hook_bridge.rs)』 を実装したところ、Carbon の 30 分停止が根絶されただけでなく、共通土台で動く主力の『Gemini 4 Argon』まで一切サボらず常時並列で爆速処理する最強の分業体制へ進化 しました。本記事では、2 連続停止の生々しい実測トークン内訳から、誤爆ゼロ・待機 0.2 ミリ秒 で動く Rust フックの内部設計、そして読者の環境にもそのまま導入できるコピペ用プロンプトまで余さず公開します。
-
Anthropic『Claude Meetings』とSOP13種実証|会議・調査AIの費用対効果と境界 : 会議から計画とタスクを自動生成する『Claude Meetings』と、企業SOP13種のコスト対成功率実験・金融調査408課題『BuySideFlow』を解剖。AI丸投げでトークン破産しない決定論ツールとの境界設計を解説しています。
-
Gemini 4 Carbonで全記事・Astro・Swift・RAMDiskを監査|隠れバグ根治とArgon分担 : 本記事の直前に実施した総読込 1.42 億トークンの全領域監査と、「監査・開発は Carbon、執筆は Argon」という役割分担に至った実録です。
-
Gemini 4 Carbon一般開放とAntigravity「/swarm」|Argonとの使い分けと料金2倍対策 : 2026 年 11 月 10 日解禁の公式ベンチマーク 3 冠と、12 月からの標準 API 単価 2 倍を見据えた定額プラン運用の勘所を解説しています。
-
Gemini 4 CarbonとArgonで同じ記事を作らせた実測比較|時間・料金2.55倍差と生記事公開 : 同じ 3 行プロンプトで 1 本の記事を書かせた際、なぜ Carbon の入力トークンが Argon の
1.51 倍に膨らんだのかを検証した基礎データです。 -
Antigravity IDEとVS Code拡張・2.0の違い|並列は何本まで?実測50本と6班黄金比 : サブエージェント並列の上限テスト(実測 50 本同時稼働)と、最も効率よく安定完走できる「4〜6 班」の黄金比をまとめています。
-
Antigravity や AI エディタで複数の機能追加・記事作成をまとめて頼んだ際、30 分前後の長時間稼働で
Model unavailableやタイムアウト停止に遭遇して困っている方 -
ルールファイル(
GEMINI.mdやCLAUDE.md等)に「並列で処理せよ」と書いたのに、AI が中規模タスクで勝手に 1 人で直列実装を始めてしまう抜け穴 を塞ぎたい方 -
『Gemini 4 Carbon』の深い推論力と『Gemini 4 Argon』の軽快な執筆スピードを、コンテキスト肥大化ゼロで常にフル回転させる自動化設計 を取り入れたい方

おいおい、前回の記事で「開発や監査は Carbon に任せれば鬼に金棒じゃ!」と太鼓判を押したばかりじゃぞ!? なんでその直後に 2 回も連続でエラー停止なんか食らっておるんじゃ!?

いやもう、画面の時計が「30分」を回った瞬間に真っ赤なリトライ表示が出たときは変な汗が出ました……! でもログを丸裸にしてみたら、Carbon が悪いのではなく「優秀な現場監督(親エージェント)に、設計から大工仕事 10 棟分まで 1 人で抱え込ませていた私の指示ルール」に大穴が空いていた ことが分かったんです!
Carbon実戦投入で直面した2連続30分停止の正体
事の発端は、全サイトの深層監査を無事に終え、「よし、これからの複合開発タスクは Gemini 4 Carbon (High) をメインに据えて一気に作らせよう!」と実戦投入した直後のセッションでした。
依頼した内容は、サイト全体の健康診断に加えて 「新規の Web 計算ツールを 2 本作成し、関連する Q&A 記事を 1 本書き起こし、さらに既存の UI コンポーネント 4 本を改修して本番反映・実機確認まで行う」 という、個人開発ではよくある「ちょっと欲張りな一括オーダー」です。
複合開発中に突然出た76秒リトライ画面の衝撃
最初は順調にコードを読み解き、鋭い設計でファイルを次々と組み上げていた Carbon でしたが、作業開始から約 30 分〜50 分が経過した終盤で、2 回続けてまったく同じ現象に阻まれました。実際のエラー発生時のスクリーンショットがこちらです。
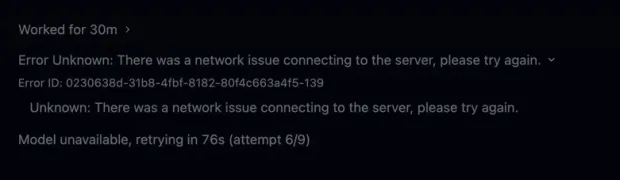
画面には Worked for 30m という稼働表示とともに、無情な Model unavailable, retrying in 76s(モデル利用不可、76 秒後に再試行)の警告が出現し、そこからリトライのカウントダウンが回ってもセッションが復帰せず立ち往生してしまったのです。
1 回目(失敗①)は「たまたまクラウド側が混雑していたのかな? よし、次は最初の監査だけ 2 班のサブエージェントに分けよう」と考えて再挑戦したのですが、なんと 2 回目(失敗②)も本番環境への転送を終えて最後のブラウザ実機確認に入った直後、きっちり 稼働約 30 分の壁 で同じ Model unavailable に捕まりました。
実行ログ解剖で判明した847万トークン再送の罠
「2 回続けて 30 分前後で止まるのは絶対に偶然ではない」と確信し、当ラボの Pure Rust 製ログ解析コマンド(./scripts/run_kb_search.sh brain)を使って、止まった 2 つの会話セッションの transcript.jsonl を 1 ステップずつ解剖しました。すると、驚くほどはっきりした数字の因果関係が浮かび上がりました。
| セッション区分と実行スタイル | 親ツール実行数 (うち read_file) |
親AIの 純稼働時間 |
親の新規入力 (Fresh Input) |
親のキャッシュ読込 (Cache Read) |
最終結果と停止タイミング |
|---|---|---|---|---|---|
| 失敗①:完全単独進行 (調査も実装も親1人で直列処理) |
多数実行 ( read_file 47回) |
49.0 分 |
448,577 tok(約 44.9万) |
4,064,456 tok(約 406.4万) |
実装の途中で応答待ちが伸び続け、そのままタイムアウト停止 |
| 失敗②:監査のみ2班並列 (実装10ファイル超を親が直列抱え込み) |
計 101 回( read_file 27回) |
29.1 分(画面表示 30m) |
523,040 tok(約 52.3万) |
8,468,956 tok(約 846.9万) |
本番転送直後の最終検証ステップで Model unavailable 停止 |
| 対策後:調査も実装も完全排他並列 (調査3班+実装・執筆・結線3班へ分離) |
司令塔専任 (個別実装の抱え込み 0) |
短時間で軽快完走 (各班が同時並行) |
最小限の指示と 完了報告のみ |
終始スリム維持 (子ログは完了時破棄) |
タイムアウトの気配すらなく一発で統合・検問・実機検証まで完遂 |
とくに注目してほしいのが 「失敗②」の数字 です。最初の調査を 2 班のサブエージェントに分けたおかげで、親自身の read_file 回数は 47 回 ➔ 27 回 に減りました。ところがそのあと、新規ツール 2 本・新規記事 1 本・UI 改修 4 本を含む 10 ファイル以上の作成・編集・テストをすべて親エージェント 1 人で直列にこなしてしまった ため、親のツール実行は計 101 回 に膨れ上がり、親のキャッシュ読込量はむしろ倍増して 8,468,956 トークン(約 847 万トークン) に達していたのです。
なぜCarbonはArgonよりコンテキストが埋まるのか
それにしても、これまで主力として使ってきた Gemini 4 Argon では、少しくらい親エージェントがファイルを抱え込んでもここまでの頻度で 30 分停止にぶつかることはありませんでした。なぜ Gemini 4 Carbon だと、よりシビアにコンテキスト上限や時間制限の壁が現れるのでしょうか?
同一記事比較でも入力1.51倍だった深い検証特性
答えの半分は、先日の Carbon と Argon の同一記事ブラインド執筆比較 の実測データにすでに表れていました。まったく同じ 3 行のプロンプトから 1 本の記事を作らせただけでも、総入力トークンは Argon の 198.6 万 に対して Carbon は 299.8 万(1.51 倍) を消費していたのです。
Google 公式ブログの Gemini 4 Carbon 一般公開発表 や Google DeepMind のモデル評価レポート(PDF) でも詳述されているとおり、Carbon は「推測でそれっぽいコードを素早く書く」ことを嫌い、関連ファイルの型定義や境界条件を一つひとつ裏取りしながら、非常に密度の高い内部思考ログ(thinking)を積み上げる設計になっています。
つまり、同じ 1 つのツールを呼ぶにも 1 ステップあたりに蓄積される思考と確認の密度が濃いため、直列でステップを重ねたときのコンテキスト増加ペースが Argon より約 1.5 倍速い のです。
直列抱え込みが招く雪だるま式再送と通信切断
もう半分の理由は、AI エージェントがクラウド上のモデルとやり取りする「ステートレス通信」の仕組みにあります。
AI エージェントは人間のように脳内に記憶を保持したまま次の作業をするのではなく、ツールを 1 回実行するたびに 「会話開始からのシステム指示書 + これまでに読んだ全ファイルの中身 + これまでに自分が書いた全コードと思考ログ + 今回の 1 手」を毎回ひとまとめにしてクラウドへ送り直して います。
- 履歴の累積 : 読んだファイル(27〜47個)と生成した全コード(10ファイル超)が親の履歴に残り続け、100ステップ目には巨大な塊を毎回再送する
- 待機時間の悪化 : コンテキストが数十万トークンへ肥大化するにつれ、1手ごとのクラウド応答待ち(最初の1文字が返る時間)と推論負荷が重くなる
- 結末 : 純稼働が30分前後に達したところでクラウド側のストリーム維持・キャパシティ閾値に触れ、
Model unavailableで足止めされる
- 履歴の完全隔離 : ツールA班・ツールB班・記事班がそれぞれ独立した小さな会話部屋で作業し、完了と同時に数百万トークンの途中経過はその場で破棄される
- 親は常にスリム : 親エージェントが受け取るのは各班からの「数百文字の完了報告」だけなので、最初から最後まで数ステップ目と同じ軽快さが続く
- 結末 : 3班〜6班が同時並行で書き上げるため実時間も短縮され、タイムアウトやリトライ待ちのストレスがゼロになる
なるほどなぁ! サブエージェントをたくさん呼ぶと「逆にトークンを余計に食って損するんじゃないか?」と心配しておったが、1 人に 100 手も荷物を背負わせて毎回 847 万トークン送り直すほうがよっぽど重労働じゃったのか!
そうなんです! 引っ越し作業に例えるなら、直列抱え込みは 「1 人の作業員が、これまで運んだ家具を全部リュックに背負ったまま 101 往復している状態」 なんですよ。最初から部屋ごとに担当を分けて並走させれば、誰のリュックも軽いまま一気に片付きますし、途中で倒れて最初からやり直すロスもなくなります!
なお、クラウド内部の厳密なタイムアウト秒数や高負荷コンテキスト帯の割り当て制御は非公開仕様のため推論を含みますが、実測上「親単体のツール実行が 80〜100 回を超え、累積キャッシュ読込が 400 万〜850 万トークン・稼働 30 分前後に達した領域」で急激に Model unavailable が出やすくなる傾向は明白でした。
逃げ道を塞いだ「常時並列化」3大必須トリガー
では、なぜ当ラボには以前から「並列サブエージェントを活用しよう」というルールがあったにもかかわらず、今回の「失敗②」が起きてしまったのでしょうか? 原因は、私たちが書いていた旧ルールの 「数字の甘さ」 にありました。
旧ルールの盲点だった中規模タスクの親抱え込み
従来の GEMINI.md(プロジェクト共通ルール)を見直してみると、並列化の条件が 「15〜20 記事以上の大規模改修を行うとき」 や 「大型の新規記事を 3 本以上まとめて作るとき」 という高いハードルで書かれていました。
そのため、今回のような「計算ツール 2 本+記事 1 本+UI 改修 4 本(合計 10 ファイル強)」という 『日常で一番よく発生する中規模の複合開発』 が見事に網の目をすり抜け、AI が「15 記事未満だし新規記事も 1 本だけだから、親の私が 1 人で順番に書いたほうが手っ取り早いだろう」と自己判断してしまったのです。
また、Google Antigravity 公式ドキュメントのサブエージェント仕様 にあるとおり、サブエージェントは親から独立した会話コンテキストを持つ反面、サブエージェントがさらに孫エージェントを無限に増やすような深いネストには制限があります。だからこそ、「一番上に立つ親エージェント自身が最初から手を動かさず司令塔に徹し、1 階層目のサブエージェントたちへ編集ファイルが絶対に重ならないよう『完全排他分割』で配る」 のが最も安全で速い設計になります。
常時注入プロンプトへ同期した新3大トリガー
そこで、「大規模な場合は〜」といった AI が都合よく解釈できる曖昧な言葉をすべて廃止し、毎セッション自動注入されるルールへ以下の 『常時サブエージェント並列・3 大必須トリガー』 を明確な数値基準(IF-THEN)として刻み込みました。
-
① 全監査・広域調査は常に
research並列(2〜6 班) : コードベース全体・複数記事・OS 設定にまたがる調査や監査を行う際、親エージェントが自分でread_fileを 10 回以上連打することを禁じ、必ず読み取り専用のresearchサブエージェントを領域別に並列起動して走査させる。 -
② 新規作成が複数本(2 本以上)ある場合は例外なく
self排他並列 : 新規の記事・Web ページ・計算ツール・スクリプトなど、新しく生み出す成果物が 2 本以上 ある時点で親の直列作成を禁止し、1 成果物=1 担当のselfサブエージェントへ完全排他分割で並列委譲する。 -
③ 広範囲の修正(4 ファイル以上 または 3 記事以上)は例外なく
self排他並列 : 既存コードや記事への変更が 4 ファイル以上(または 3 記事以上) に広がる場合は、機能・ディレクトリ単位で担当ファイルを完全に切り分け、複数のselfサブエージェントで同時並行改修する。 -
👑 親エージェントは「少数のピンポイント編集」と「最終統合の司令塔」に専念 : 親が直接ファイルを書き換えてよいのは「新規 1 本単独」または「1〜3 ファイルの小規模修正」のみ。並列実行時は、各班が個別の担当ファイルを仕上げたあとに 共通インデックスへの登録・逆リンク注入・機械検問(
--files)・本番転送・ブラウザ実機検証 だけを親が一括で締めくくる(これにより複数エージェント間の書き込み競合も 100% 防止できる)。
文字の約束を破らせないPure Rust自動並列ガード
しかし、長年のシステム開発と同じで 「マニュアルに文字でルールを書いただけ」では、いつか必ずヒューマンエラーならぬ『AI の没頭エラー』が再発 します。
プロンプトの注意書きだけでは再発する理由
最初は「1〜2 ファイルだけ直すつもり」で親エージェントが編集を始めたものの、途中で関連する型定義や別のコンポーネントも直したくなり、気づけば 3 ファイル、4 ファイル、5 ファイル……と夢中で直列編集を続けてしまうケースは珍しくありません。作業の渦中にいる AI は「今自分が累計何ファイル目を触ったか」を正確には数えていないからです。
文字の約束(性善説)だけに頼るのではなく、AI が親コンテキストのまま規定ファイル数を超えて直列編集し始めた瞬間に、ローカルの Pure Rust プログラムがミリ秒単位で検知して自動でブレーキをかける仕組み まで作ってこそ、本当の再発防止になります。待機0.2ミリ秒を守る5つの誤爆ゼロ設計
当ラボでは、Antigravity のライフサイクルイベント(ツール実行直後の post-tool や、AI が次の思考を始める直前の pre-invocation)を受け取るネイティブブリッジ tools/kb-search/src/hook_bridge.rs を外部クレートゼロの Pure Rust で自作運用しています。
今回、この hook_bridge.rs の中に新設した 『⚡ 並列サブエージェント必須ガード』 の動作フローがこちらです。
作成や編集ツールが動くたび、対象ファイルの種別とパスを会話別のセッション記録へ高速追記する。
未編集ターンは0.2ミリ秒で即終了。新規2本以上または累計4ファイル(3記事)以上の編集時のみ検査へ進む。
実行ログのツール呼び出し構造を解析し、既に書き込み用のself並列を起動済みか・自身が子班かを判定する。
親の直列抱え込みと確定した瞬間、残作業を即座にself排他並列へ切り替える警告をephemeralMessageで注入する。
こうした自動ガードを作るとき、雑なスクリプトを組んでしまうと「毎ターンの動作が重くなる」「関係ない場面で警告が出まくって邪魔になる」という副作用が起きがちです。そこで実装にあたっては、ベテラン技術者の視点でも隙のない 5 つの誤爆ゼロ設計 を徹底しました。
-
① 未編集ターン
0.2 ミリ秒即終了の完全維持 : 普段の壁打ちや調査ターンではログ解析を一切走らせず、空の{}を返して0.2msで即終了します。ファイル編集が発生した直後のpre-invocationでのみ判定が動くため、体感速度の低下はゼロです。 -
②
transcript.jsonlの構造デコードによる本文テキスト誤検知の遮断 : もし実行ログに対して単純な文字列検索("invoke_subagent"が含まれるか等)をかけてしまうと、まさに今お読みいただいているこの記事のように 「本文やルール解説の中に書かれたinvoke_subagentやselfという単語」 に反応して「もう並列起動済みだ」と騙されてしまいます。そのためPLANNER_RESPONSE内のtool_calls構造と二重クォート引数を厳密にデコードし、本物のツール呼び出し実績だけを判定しています。 -
③ サブエージェント自身と「親の事後統合フェーズ」の自動免除 : 親から委譲された子エージェント自身が担当領域の複数ファイルを編集する場合や、親がすでに
self並列班を稼働させたあとに共通マスターや関連リンクを統合している正当なフェーズでは、警告を一切出さずにスルーします。 -
④ 「
research監査だけ呼んで実装を抱え込む抜け穴」のピンポイント検知 : 今回の「失敗②」とまったく同じパターン、つまり「読み取り専用のresearchサブエージェントは呼んだけれど、書き込み実装用のselfサブエージェントを 1 体も呼ばずに親が 4 ファイル以上直列編集し始めたケース」を見逃さず検知してストップをかけます。 -
⑤ ターン番号記録による 1 ターン 1 回通知(コンテキスト汚染防止) : 1 回の思考ループや解決済みの状態に対して同じ警告を何度も連投しないよう、通知状態をセッション管理 JSON へアトミック書き込みで記録し、最小限のトークンで確実に軌道修正させます。
怪我の功名!Carbon対策でArgonも常時並列へ進化
こうして「Carbon が 30 分で止まらないようにするための防衛柵」を完成させて実運用に戻したところ、予想をはるかに超える 最高に嬉しい副産物(怪我の功名) が待っていました。
共通土台の強化で主力Argonの手抜きも消滅
常時注入されるプロンプトルール(GEMINI.md)と、裏側で目を光らせる Pure Rust の hook_bridge.rs は、特定のモデル専用ではなく Antigravity 上で動くすべての AI モデル共通の土台 です。
これまで日常の執筆や改修の 8 割を担ってきた主力モデル 『Gemini 4 Argon』 は、もともと動作が俊敏でコンテキストにも余裕があるため、複数本の作業や 5〜6 ファイルの修正を頼むと「これくらいなら私 1 人でパパッと順番に片付けちゃいますね!」と直列で走ってしまう癖がありました。エラーで止まりはしないものの、1 本ずつ順番に処理するため完了までの待ち時間はそれなりに伸びていたのです。
ところが今回、Carbon の弱点を補うために「新規 2 本以上・修正 4 ファイル以上は例外なく排他並列」という厳格ルールと Rust 自動ストッパーを敷いた結果、普段使いの主力である『Gemini 4 Argon』まで一切の横着をせず、最初から複数のサブエージェントを一斉に並列展開して数分の一の時間でタスクを片付ける最強の自動分業エンジンへと進化 してしまいました!
にゃんと……! Carbon がすぐお腹いっぱいになるから作った「小分け配膳システム」のおかげで、もともと早食いだった Argon まで分身の術を覚えて超スピード化したにゃ!
本当に「怪我の功名」とはこのことですよね! もし Carbon が 2 回連続で止まってくれなかったら、今でも Argon に 1 人で直列作業をさせて「まあ動いているからいいか」と時間を損し続けていたはずです!
実は、今ご覧いただいているこの記事と Pure Rust 並列ガードの開発セッション自体 が、まさにその最初の実証テストでした。
- まず調査用の
researchサブエージェント 2 班 と画像生成サブエージェント 1 班 の 計 3 体並列 で、先行記事メタ情報・hook_bridge.rsの境界条件調査・アイキャッチ生成を同時実行。 - 続いて
selfサブエージェント 3 班の完全排他並列(「① Rusthook_bridge.rs実装・5 ケース単体テスト班」「② 本記事の新規執筆・機械検問班」「③ 既存の関連検証録への双方向リンク結線班」)を一斉起動。 - 最後に親エージェントが全体の整合確認と本番転送・実機表示チェックだけをスリムに実行。
これだけの複合タスク(Rust 実装+テスト+長文記事執筆+複数記事リンク更新+デプロイ検証)を回しても、親エージェントのコンテキストは最初から最後まで羽のように軽く、リトライ画面を一度も見ることなく一発で完走できました。
常時並列とRAMDiskを支える64GB母艦の算数
なお、このようにクラウド側で 3〜6 体のサブエージェントを惜しみなく常時並列稼働させ、同時にローカル側で 16GB の APFS RAMDisk(/Volumes/RAMDisk/$USER)上に常駐させた Pure Rust バイナリ・SQLite 知識データベース・Astro ビルドキャッシュをミリ秒単位で連携させるには、「クラウドの定額枠」と「手元の物理メモリ」の両輪が噛み合っていることが大きな武器になります。
クラウド側については、Google One 公式の Google AI プラン案内 にある最上位の定額枠(Google AI Ultra)を活用することで、並列サブエージェントの起動を従量課金のメーターを気にせず日常化できます。
そして手元の Mac 母艦については、ブラウザ・AI エディタ・複数の並列サブエージェントプロセス・Rust コンパイラ・16GB RAMDisk が同時にメモリを使うため、無印チップの 16GB〜24GB 構成では SSD へのスワップが発生して足回りが重くなりがちです。
推論(試算)として、たとえば約 24 万円クラス(税込 239,800 円前後想定)の 64GB ユニファイドメモリ搭載 Mac mini(Pro 系チップ構成) を母艦に据え、耐用年数 5 年間(1,825 日)× 毎日 8 時間の開発・執筆に使い倒した場合を計算してみましょう。
- 1 日あたりの快適コスト :
239,800 円 ÷ 1,825 日 ≒ 約 131 円 / 日(缶コーヒー 1 本分) - 稼働 1 時間あたりの快適コスト :
131.4 円 ÷ 8 時間 ≒ 約 16 円 / 時間
わずか 1 時間あたり約 16 円 の母艦投資で、メモリ不足のスワップも SSD の書き込み摩耗もゼロにしたまま、24 時間いつでも並列サブエージェント軍団をフル回転させられるなら、自分の時間を守る道具としてこれほど堅実な選択はありません。
まとめ:AIの弱点を仕組みに変えれば全体が強くなる
新しい最上位モデルを導入して思わぬエラーや制限にぶつかったとき、「やっぱり前のモデルのほうが楽だったな」と引き返すのは簡単です。しかし今回のように、ログを計測して「なぜ止まったのか」の物理的な構造を突き止め、それをプロンプトの明確な数値基準とローカルの自動検問コードへ落とし込めば、1 つのモデルの弱点対策がそのままシステム全体(主力モデルを含む全ワークフロー)の底上げ へと変わります。
-
30 分停止の真因は「書き込み実装の親抱え込み」 : Carbon で起きた 2 連続の
Model unavailableは、監査だけ並列にしても 10 ファイル超の実装を親 1 人で直列処理したことで、親のキャッシュ再送が 約 847 万トークン(101 ツール実行・稼働約 30 分) に膨張したことが原因だった。 -
数値で切る「常時並列 3 大必須トリガー」へ刷新 : 従来の甘い基準を撤廃し、①全監査・広域調査は常時
research並列、②新規作成 2 本以上は例外なくself排他並列、③修正 4 ファイル(または 3 記事)以上は例外なくself排他並列とし、親は最終統合と検証の司令塔に専念させた。 -
Pure Rust 自動ガードで主力 Argon まで常時並列へ進化 :
hook_bridge.rsが未編集ターン0.2msの軽さを保ったまま親の直列書き込み超過を検知して軌道修正をかけることで、Carbon の停止が消えただけでなく、普段使いの 『Gemini 4 Argon』までサボらず常時並列で爆速処理する体制 が完成した。
最後に、ご自身のプロジェクト(GEMINI.md / CLAUDE.md / AGENTS.md 等と Hooks 環境)にも、この 「常時サブエージェント排他並列ルール&直列抱え込み自動ガード」 を安全に導入するためのコピペ用プロンプトを用意しました。
当ラボでは 0.2 ミリ秒 の応答速度にこだわって Pure Rust で実装していますが、仕組みの本質は「セッション内の編集ファイル数を記録して閾値超過時にリマインドを返す軽量フック」ですので、お使いの環境にすでにある Node.js や Python、シェルスクリプト等でもまったく同じガードを構築できます。
必ずモデル選択を設計・環境構築に強い 『Gemini 4 Carbon』 または 『Gemini 4 Argon』(いずれも High 等の最上位推論モード)にしたうえで、以下の枠内をコピーして貼り付けてみてください!
私のプロジェクトでも、AIエージェントが複合タスクでファイルを直列に抱え込んでコンテキスト肥大化・速度低下・タイムアウトを起こすのを防ぐため、「常時サブエージェント排他並列ルール」と「直列編集オーバー時の自動リマインドHook」を導入したいです。

まず以下の実測検証記事を読み込み、30分停止が起きるコンテキスト累積の仕組み・3大必須トリガー(排他分割と親の事後統合)・誤爆ゼロのHook設計(5つの工夫)を正確に把握してください。
https://lab.chihouzakki.com/blog/review/gemini-4-carbon-context-limit-parallel-subagent-rust-hook/

【厳守してほしい手順(いきなりファイルを書き換えないこと)】
1. 事前調査(Read-only):私のワークスペースにある既存のAIルールファイル(GEMINI.md / CLAUDE.md / AGENTS.md / .agents/rules/* 等)と、現在利用可能なHooks設定・スクリプト実行環境(Rust / Node.js / Python 等)を調査して報告してください。
2. 計画提示と合意:私のプロジェクト構成に合わせて、①常時並列化の明確な数値トリガー案(ファイル競合を防ぐ排他分割ルール含む)と、②未編集ターンの速度を落とさず親の直列抱え込みだけを検知する軽量Hookの実装案を提示し、私の合意を得てください。
3. 段階実装とテスト:合意後にルール追記とHook実装を行い、単体テストで「未編集時の即時終了」「本文内の単語による誤検知ゼロ」「閾値超過時の正常発火」を確認してから完了報告してください。
AI に「頑張れ、サボるな」と言い聞かせるのではなく、サボりようがない軽快な分業レーンを仕組みで敷いてあげること。ぜひお手元の開発環境にも取り入れて、30 分のフリーズ待ちとは無縁の快適な並列ワークフローを体験してみてください!
