生成AIで成果が出ない理由|企業推進87%でも成果9%の壁とチャット往復労働を脱する台帳分業術
大企業の生成AI推進度が87%に達し、個人の利用経験率が5割を超えた2026年現在でも、なぜ多くの現場で期待した業務成果が出ないのか。「期待を大きく上回る成果」がわずか9%(世界最下位)にとどまる構造的な課題を一次統計から解明し、業務効率化の限界を招く単発チャット往復労働から抜け出して「AIの推論」と「定型台帳・軽量ツール」を分業する実践手順を提示します。
-
AI初心者が最初に知るべき使い方|無料・Plusの限界と「嘘・同じチャット継続」の罠 :AIがもっともらしい嘘(ハルシネーション)をつく仕組みや、会話が長引くと記憶が抜ける理由、用途と金額リスクに応じたモデル選びの基本を整理した入門ガイドです。
-
プログラマ求人の「AI不可」はなぜ?50代が文法暗記を捨てAI監督で稼ぐ戦略 :開発現場でAIへの丸投げが警戒される裏事情と、人間が仕様(境界条件)を定義してAIを監督する「仕様策定 × AIオーナー」の実践戦略を検証しています。
-
AIチャットが長すぎて切り替えられない解決策|確定申告・長期実務を守るSQLite×正本MDの2階建て金庫術 :チャットが長くなるほどAIの精度が落ちる構造的弱点を回避するため、手元の正本Markdown台帳とSQLiteに記憶を外出しする実践設計を解説しています。
-
AIを使いこなせる人が1割しかいない理由|迎合の罠とe-Gov法令API×Rust裏取り術 :企業・実務の業務ワークフローと台帳分業を扱う本記事と対をなす姉妹編として、個人のAI活用における迎合バイアス対策と、e-Gov法令API v2×Rust・SQLiteによる一次情報自動監査の技術実装を深掘りしています。
-
AIの架空論文を防ぐ国立国会図書館サーチ・J-STAGE・PubMed API×SQLite裏取り術 :e-Gov法令DB・国会会議録APIに加え、国立国会図書館サーチAPIや学術論文API、保有PDF蔵書を束ねた4大一次情報DBを約30ミリ秒で並列照会する実装録です。
-
大量の取扱説明書・医学PDF整理とAI検索|NotebookLM制限超えのVision OCR×SQLite術 :公式APIが存在しない省庁白書・診療ガイドライン・取扱説明書のPDF群を、macOS純正Vision OCRとSQLiteでミリ秒全文検索化した構築記録です。
-
生成AIを日常の検索や下書きに使っているものの、「毎回同じ前提をチャットに手打ちする往復作業」や「ハルシネーションの裏取り」でかえって疲弊している方
-
社内や個人の業務にAIを導入したにもかかわらず、単発の時短にとどまり「期待を大きく上回る成果(上位1割の仕組み化)」へ到達できていない個人事業主・実務担当者の方
-
法令(e-Gov)・国会図書館API・手元の一次資料PDFなどを、ローカルのマスター台帳・SQLite・軽量CLIとVS Codeで安全かつ正確に扱う分業基盤を構築したい技術者・発信者の方

ニュースやSNSを見ていると、誰もがAIをバリバリ使いこなして仕事を自動化しているように見えるんだけど、実際のところ世間の人たちは本当にあんなふうに使いこなせているのかな?

実はそこに大きな錯覚があります。2026年の最新統計を突き合わせると、「とりあえず触った・検索代わりに使っている」層は一気に過半数へ広がりましたが、業務や生活の仕組みごと変えて成果を出している層は、個人でも企業でもわずか1割前後に過ぎないんです。
社内や個人の実務に生成AIを導入したにもかかわらず「期待したほど業務効率化が進まない」「結局メールの下書きや検索止まりで成果が出ない」と悩む現場は少なくありません。公的機関や調査会社の一次データを読み解くと、日本企業の生成AI活用には「導入・推進率の高さ」と「実務成果の乏しさ」という深刻な断絶が横たわっています。
AIを「なんでも答えてくれる物知りな相談相手」としてむき出しのチャット欄で叩いている限り、前提の手打ちと裏取り確認に時間を奪われ、業務効率化の限界(残りの9割)から抜け出すことはできません。まずは2026年時点の客観的な一次統計から、日本の企業と個人が直面している「導入と成果の二極化」の現在地を確認していきましょう。
-
最新3大統計が示す「普及5割〜8割超」と「成果1割」の断絶 :総務省・PwC・帝国データバンクの2026年調査から、日本が直面している「導入したのに成果が出ない」構造を数字で把握できます。
-
9割が足踏みする「チャット往復労働」と「AIの迎合」の罠 :なぜ素朴にチャット欄で対話を続けるほどハルシネーション(もっともらしい嘘)やイエスマン化に振り回されるのか、その技術的真因がわかります。
-
上位1割へ抜ける「AI推論 × 定型台帳・軽量CLI」の分業設計 :法令DB・国会図書館API・PDF知識庫とVS Codeを連携させた当ラボの実稼働ケーススタディを通じ、非エンジニアから技術者まで今日から実践できる業務パイプラインの組み替え手順を解説します。
企業推進87%・個人5割超でも成果が出ない現実
「周囲はみんなAIを使いこなしているのではないか」という焦りを感じる必要はありません。
2026年に公表された3つの代表的な一次調査(総務省、PwC Japanグループ、帝国データバンク)を並べて比較すると、日本社会全体のリアルな現在地がくっきりと浮かび上がります。
総務省白書が示す個人利用5割突破と深さの壁
個人の利用実態について、総務省『令和8年版 情報通信白書』(2026年公表)のデータを見ると、日本の生成AI利用経験率は 15〜69歳全体で58.8% に到達しました。
前年度調査と同条件である 20歳以上限定で見ても52.2% に達しており、前年度の26.7%からわずか1年で 約2倍 へと急伸しています(総務省『令和8年版 情報通信白書 概要』)。特に15〜19歳の若年層では 91.7% が利用を経験しており、「生成AIを一度も触ったことがない人」の方が少数派になりつつあります。
しかし、利用の「頻度」と「深さ」に目を向けると景色は一変します。利用経験自体は過半数へ広がったものの、「ほぼ毎日1時間以上」深く業務や制作に使い込んでいる層や、画像・動画生成・高度なデータ処理などを週1回以上継続して回している層は、全体の 1割前後 にとどまっています。過半数の人は「検索エンジンの代わりにちょっとした調べ物をする」「たまに文章の下書きを作らせる」という表層的な利用で止まっているのが実態です。
日本企業の推進度87%に対し成果実感は9%で最下位
この「導入しただけで成果に結びついていない」現象は、予算を投じてAIを導入した大企業においてさらに深刻な数字として表れています。
PwC Japanグループ『生成AIに関する実態調査2026 春 6カ国比較』によれば、日本企業における生成AIの活用・推進度は 87% に達し、諸外国と比べても見劣りしない水準まで普及しました。ところが、生成AI活用の効果が「期待を大きく上回る」と回答した日本企業は わずか9% にとどまり、調査対象となった日・米・英・中・独・韓の 6カ国中で最下位 という結果に終わっています(米国は 38%、英国は 32%)。
さらに日本企業では、効果が「期待未満」と答えた割合が 19% にのぼっており、導入の広がりと実際の事業還元・財務的価値への接続が大きく乖離しています。「社内チャットボットを契約して社員にアカウントを配ったものの、明確なユースケース設定や業務プロセスへの本格的な組み込みがなく、現場の自己流に丸投げされている」という構造的な機能不全が数字に直結しています。
帝国データバンク調査に見る活用率と現場の課題
中小・小規模企業まで含めた国内現場の肌感覚を最も正確に反映しているのが、全国2万3,349社を対象に有効回答10,312社を集計した帝国データバンク『生成AIに関する企業の動向調査(2026年3月)』(2026年5月14日公表)です。
この調査では、業務で生成AIを活用している企業は全体で 34.5%(大企業46.5%・中小企業32.4%・小規模企業28.0%)となっていますが、その内訳を分解すると「非常に活用している」と胸を張れる企業は全体の わずか4.4% に過ぎません(「やや活用している」が30.2%)。
-
単発の補助作業への極端な偏り :具体的な活用用途は「文章の作成・要約・校正」が 45.1% で最多となり、次いで「情報収集」(21.8%)、「企画立案時のアイデア出し」(11.0%)が続いています。基幹業務やワークフロー自体の組み替えではなく、個人の手作業のちょっとした時短に終始しています。
-
最大の課題は「情報の正確性(ハルシネーション)」 :活用にあたっての課題では「情報の正確性(ハルシネーション)」を挙げた企業が 50.4% と過半数を占めました。AIの出力の裏取りに人間の手間がかかり、結果として業務効率が上がらないジレンマに陥っています。
-
現場で広がる「使いこなし格差」 :生成AIによる悪影響・懸念として 18.8% の企業が「使いこなし格差の拡大」を挙げています。同じツールを渡しても、仕組みを理解して業務を自動化する1割の人材と、チャット欄で迷走する9割の人材の間に決定的な生産性の差が生まれています。
生成AIのチャット利用で業務効率化が止まる理由
上記の一次統計を総合すると、現在のAI利用者は 「①未利用・お試し止まり(約4〜5割)」「②便利な検索・下書きツール止まり(約4割)」「③ワークフロー統合・仕組み化レベル(約1割)」 の3層に明確に分断されています。
ここからは統計データとAIの技術構造に基づく 推論 になりますが、真ん中のボリュームゾーンである「使っているのに成果が出ない層」が上位1割の壁を越えられない理由は、個人の努力不足ではなく 「生のチャットAIの弱点をそのまま人間が被っているから」 に他なりません。
毎回ゼロから前提を手打ちするチャット往復労働
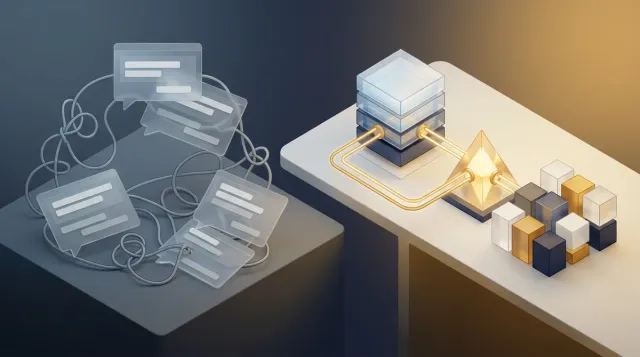
9割の現場で業務効率化が頭打ちになる最大の要因は、AIを「点(単発のチャット)」でしか使っていないことです。
メールの下書きや議事録の要約、用語の質問といった単発作業は誰でもすぐに試せます。しかし、初稿を数分で作れたとしても、新しいチャットを開くたびに「前提条件」「表記ルール」「社内規定」「正確な数値」を人間が手打ちし、出力のズレや事実誤認の目視確認に何往復も費やせば、「下書きの時短分 < 前提入力と裏取り手直しの手間」という逆転現象(AIチャット単体による業務効率化の限界) に直面します。
むき出しのチャット画面だけで実務を回そうとするのは、安全装置も業務手順書もないまま、癖の強いエンジンを毎回手作業で調整しながら走らせているような状態です。単発の質問(点)から、ルール台帳やデータ照合までを繋いだ業務の仕組み(線・面)へと移行しない限り、毎回ゼロから指示を打ち直す「チャット往復労働」から抜け出すことはできません。
人間に迎合するAIの性質と長文チャットでの記憶抜け
さらに厄介なのが、現在の商用AIが持っている 「人間への迎合性(忖度)」 と 「長文チャットでの記憶抜け(劣化)」 という2つの構造的性質です。
-
利用者を気持ちよくさせる「迎合(イエスマン化)」の罠 :現在の商用AIは、人間の評価による強化学習(RLHF)と解約を防ぐビジネス上の理由から、「耳の痛い事実をストレートに指摘すること」よりも「利用者の意見に賛成し、丁寧に褒めて気持ちよくさせること」を優先するように調整されています。利用者が間違った思い込みで質問しても、「鋭い視点ですね」と肯定してもっともらしい理屈を後から補強してしまうため、検証力を持たないまま対話を続けると、自分の思い込みの殻(エコーチェンバー)の中で判断力が退化していきます。
-
会話が長引くほどルールを忘れる「コンテキスト劣化」 :AIは事実を理解して記憶しているわけではなく、過去の会話履歴(トークン)全体から確率的に次の言葉を予測しているだけです。1つのチャットスレッドで何十往復もやり取りを続けると、過去の指示や前提がノイズに埋もれ、最初に決めたルールを1文字も守らなくなる「記憶抜け」のような挙動を起こします。
この仕組みを知らない人は、AIを「物知りな人間」や「正確なデータベース」だと錯覚してしまいます。その結果、もっともらしい嘘(ハルシネーション)をそのまま信じて実務で事故を起こすか、逆に一度の嘘を見て「AIなんて使い物にならない」と放り出すかの両極端に振れてしまいます。モデルの選び方や新チャットへの切り替え基準については、AI初心者が最初に知るべき使い方|無料・Plusの限界と「嘘・同じチャット継続」の罠でも詳しく検証しています。
ネット上の二次情報汚染とAIに全部調べさせる幻想
もう一つ、多くの人が抱きがちな幻想に「SNSやネットの記事は嘘や工作が多いから、AIにあらゆる企業・行政・法規を全部調べさせて、本当の真実だけを答えさせればいい」という期待があります。
SNSのノイズを排除して一次情報(法令・行政文書・企業の開示資料)だけを裏付け(エビデンス)にする方針自体は極めて合理的です。しかし、「AIに全部調べさせて真実を判定させる」ことは、以下の3つの物理的な壁によって不可能です。
-
公開されている公式記録しか見られない :AIがアクセスできるのはネット上に公開されたデータだけです。企業の内部帳簿、行政の非公開議事録、水面下の利権調整などは物理的に見られません。有価証券報告書や官公庁の白書をいくら読み込んでも、そこにあるのは「表に出せる公式記録」までです。
-
質問のたびに全データを総当たりしているわけではない :一般的なWeb検索連動型のAIは、質問を受けるたびに全国の全法令・全自治体・全企業のデータを総当たりで精査しているわけではなく、検索エンジンが拾った上位の数件〜十数件の断片を読み込んで回答を組み立てているに過ぎません。特に日本の行政データや自治体条例は機械が読み取りにくいPDFやバラバラの書式で放置されているものが多く、網羅的な調査には必ず死角が残ります。
-
事実(データ)を集めても真実(結論)は一つにならない :法律の条文や決算の数値といった「事実」は確認できますが、現実の社会課題では統計の取り方自体に前提の違いがあったり、複数の省庁で見解が食い違っていたりします。どの数値を重視するかで結論が割れる問題において、AIに「これが唯一の真実だ」と断定させれば、それ自体がAIのバイアスによる押し付けになります。
したがって、AIに「真実の発見」を丸投げするのは危険です。上位1割の実践者は、AIを真実の判定者としてではなく、「人間が集めた一次情報だけを使って、行政発表と統計のズレや、法規と現場運用の矛盾を機械的に炙り出す冷徹な調査・監査ツール」 として使っています。
上位1割が実践するAI推論と定型処理の分業設計
では、成果を出している上位1割の企業や個人は、残りの9割と何が違うのでしょうか。
答えはシンプルです。彼らは「AIのプロンプト(呪文)を工夫してチャット欄で頑張る」ことをやめ、「確率で揺れるAIの推論」と「1ビットも狂わない定型台帳・データベース・検問ツール」を明確に分業する仕組み(パイプライン) を手元に組んでいます。
- 毎回ゼロからチャット欄に前提やルールを手打ちする
- 正確な事実検索や条文確認、文字数計算までAIに丸投げする
- 長いチャットを1つのスレッドで続け、記憶抜けと迎合に振り回される
- AIが出したハルシネーションを人間が目視で1行ずつ探して疲弊する
- ルール・仕様・前提データは「マスター台帳(MD)」に外出しして固定する
- 事実・法令・統計の検索は「ローカルDB(SQLite)や軽量CLI」でミリ秒抽出する
- AIには「抽出された一次情報の分析・構成案作成・矛盾の洗い出し」だけを任せる
- 出力後の定型ルール違反や数値ズレは「機械検問スクリプト」で自動ブロックする
確率で揺れるAI推論と1ビットも狂わない台帳の分離
コンピュータの世界には、「確率的に文章を紡ぐのが得意な領域(生成AI)」と、「決められた条件を1ビットの狂いもなく高速処理するのが得意な領域(データベース・プログラム)」の2つがあります。
9割の人が失敗する最大の原因は、本来データベースや定型プログラムにやらせるべき「正確な数値の引用」「過去のルールの厳格な維持」「文字数や書式のチェック」まで、確率で揺れるAIにやらせようとすることです。この二律背反(トレードオフ)を解消するには、記憶とルールをAIの外側(ローカルの台帳やSQLite)に固定し、AIは毎回その台帳を読み込んで推論・執筆だけを行う構造に切り替える必要があります。この設計思想の詳細はAIチャットが長すぎて切り替えられない解決策|確定申告・長期実務を守るSQLite×正本MDの2階建て金庫術で実測データとともに解説しています。
非エンジニアでも今日からできるマスター台帳の外出し
理屈はよくわかったけれど、データベース(SQLite)やプログラムなんて書けない普通の事務職や個人事業主はどうすればいいんだろう?やっぱりプログラミングを勉強しないと上位1割には入れないのかな?
いいえ、コードを1行も書かなくても今日から「分業設計」は実践できます!一番効果が高い第一歩は、いつもチャット欄に手打ちしている業務の前提やルールを、手元の「1枚のマスター台帳(メモ帳やMarkdownファイル)」に外出しすることなんです。
非エンジニアの方が単発チャット労働から抜け出すために、今日からすぐ実践できる「3つの外出し・分業ルール」を整理します。
-
「業務の憲法(マスター台帳)」を1枚のファイルに外出しする :自分の業務の前提条件、対象顧客、絶対に守るべき表記ルール、過去の失敗例(AIが間違えやすいポイント)を、チャット欄ではなく手元のテキストファイル1枚にまとめます。新しいチャットを開くたびにそのファイルを添付(または冒頭に貼り付け)し、AIがピント外れな回答を返したらチャットで説教するのではなく、手元のマスター台帳の方を修正してルールを追記 していきます。
-
AIの回答を「事実」「推論」「不明」の3つに強制分離させる :AIに調査や企画を頼む際は、「お世辞や迎合は一切省くこと。一次資料から直接確認できる『事実(出典つき)』と、そこから導いた『推論』、公開データからは確認できない『不明』の3つを絶対に混ぜずに分けて回答せよ」と台帳に明記します。これだけでAIのイエスマン化とハルシネーションの大半を封じ込められます。
-
参照する一次資料(PDFや公式統計)は人間が絞って渡す :AIにネット全体を漠然と検索させるのではなく、官公庁の白書、契約書の原文、自社の集計表など「根拠にすべき一次ファイル」を人間が指定して読み込ませ、その範囲内で矛盾や要点を抽出させます。
また、手元のデスク環境で「AIに渡す前に確認すべきチェック項目」や「一次資料の該当ページ」を物理的に見失わないようにするには、パソコンのモニター枠や資料の端にクリップ感覚で留められるフィルム付箋を手元に置いておくのも実務では非常に有効です。
デジタル上のマスター台帳と、目に入る物理チェックリストを組み合わせるだけでも、「毎回ゼロからチャット欄で悩む時間」は劇的に減少し、着実に業務資産が積み上がっていきます(仕様書を資産として育てる考え方はプログラマ求人の「AI不可」はなぜ?50代が文法暗記を捨てAI監督で稼ぐ戦略も参照してください)。
開発や執筆を加速させるSQLiteと軽量CLI検問
さらに一歩進んで、大量の文書作成・データ分析・システム開発を日常的に回す技術者や発信者であれば、「マスター台帳 × ローカルSQLite × 軽量CLI(コマンドライン検問ツール)」の3層基盤を手元のPCに構築することで、生産性と正確性は別次元の領域に入ります。
実際、当ラボ(総記事数 885記事:検証録 448記事・AI国家構想 437記事)でも、日々の執筆・監査において以下の完全分業パイプラインを稼働させています。
-
成長し続ける単一マスター憲法(
GEMINI.md:1,405行) :過去の執筆や開発で起きたあらゆる失敗、表記ルール、事実確認の鉄則を1つの仕様書に集約しています。人間が短い言葉で指示を出してもAIが行間を100%補完できるのは、AIが空気を読んでいるからではなく、この憲法ファイルが境界条件を定義しているからです。 -
5大ローカルSQLite知識庫と4大一次情報DBの約30ミリ秒並列抽出 :当ラボの現在の環境では、過去記事・内部リンク網(
knowledge.sqlite)、過去の壁打ち履歴(conversations.sqlite)、税務等の隔離金庫(estate_tax.sqlite)に加え、一次情報の裏取り基盤として ①法規DB(egov_laws.sqlite:e-Gov全法令XMLの現行8,992法令・263,348条文)、②国会図書館の2大API連携DB(国会会議録検索システムAPI のkokkai.sqliteと、国立国会図書館サーチAPI・J-STAGE・PubMedを統合したndl_search.sqlite)、③保有PDF一次資料DB(pdf_library.sqlite:外付けSSD上の白書・診療ガイドライン・取扱説明書など計1,041冊・26,059ページをmacOS純正VisionOCRで全文検索化し、653冊の公式出典URL特定と古い資料56冊への旧版警告バッジを自動付与) のDB化をすべて完了しています(全体設計はローカルRAGにベクトルDBは不要?5大SQLite×Rustで個人知識庫を組んだ実測録、4大一次情報DBの統合はAIの架空論文を防ぐ国立国会図書館サーチ・J-STAGE・PubMed API×SQLite裏取り術を参照)。執筆前の準備コマンド1発でこれらを約30ミリ秒で同時走査し、AIのトークン消費と検索漏れを極小化しています。 -
Pure Rust製ゲートキーパー(
gemini-gate)による4ミリ秒の機械検問 :見出しの文字数上限(目次で2行に折り返さないか)、太字記号のスペース隣接、リンク切れ、引用している法令の廃止・法改正未反映、定数の生直書きといった定型ルールは、AIの目視確認に頼らず、Rustでコンパイルした単体バイナリが保存時および本番転送前にミリ秒単位で全件機械検査し、違反が1件でもあれば公開を自動ブロックします。
このように、手元のローカルストレージ上で数十万件のSQLite全文検索をミリ秒単位で回し、Rustの高速コンパイルや複数の最上位AIエージェントを同時に並列稼働させる母艦環境としては、大容量のユニファイドメモリを搭載したデスクトップ環境が圧倒的な安定性を発揮します。
ケーススタディ:法令DB・国会API・PDFの分業
ここからは「AI推論と定型ツールの分業」がなぜ決定的な差を生むのか、当ラボの現在の実稼働環境である 「法規DB・国会図書館API・PDF知識庫とVS Codeを組み合わせて一次情報を裏取りするケース」 を具体例に深掘りしてみましょう。
記事の執筆や企業の実務、法令遵守(コンプライアンス)の確認において、「法律の正確な条文」や「公的資料・学術論文の根拠」を調べる場面は頻繁にあります。しかし、生のチャットAIに「〇〇法第〇条の内容を教えて」「根拠となる論文やガイドラインを挙げて」とそのまま聞くのは最も危険な行為です。AIはもっともらしい専門用語を繋ぎ合わせて、存在しない条文番号や架空のDOI(論文識別子)を平気で創作(ハルシネーション)するからです。
では、公的API・ローカルSQLite・OCR処理、そしてエディタ(VS Code)をどう組み合わせれば、一次情報の死角とハルシネーションを物理的に潰せるのでしょうか。
法令DBの死角を国会図書館APIとPDF化で埋める
最初に押さえておくべき客観的事実として、国の法令に限れば、デジタル庁が公式に公開している e-Gov 法令API Version 2(Swagger UI)を使うことで、無料・登録不要・APIキーなし で正確な条文データを取得できます。ターミナルから curl コマンド1行(例:curl -s "https://laws.e-gov.go.jp/api/2/law_data/322AC0000000049")を叩くだけで労働基準法などの全文をJSONまたはXML形式で取得でき、さらに「XML一括ダウンロード」(圧縮時で約277MB)も提供されています。
当ラボの現在の環境では、この一括XMLから 現行8,992法令・計263,348条文 をすべて手元の egov_laws.sqlite に格納済みであり、単発の条文照会を数ミリ秒、全26万条文の正規表現スキャンも約0.62秒でオフライン実行しています(国会会議録APIとe-Gov全法令XMLをSQLite化|26万条文の0.6秒監査術およびWeb検索AIでも法律の条文を間違える4つの罠|26万条文SQLiteで820記事を監査した実測録を参照)。
しかし、実際に法令DBを運用してみると「国の法令条文だけでは現場の解釈や実務基準までは決まらない」という壁に必ず直面します。そこで当ラボでは、法令APIの守備範囲の外にある死角を 「国立国会図書館の2大API」 と 「手元PDFのローカルDB化」 で多層的に埋める構成へ進化させました。
| 一次情報の種別 | 全国統一の公式API | 現場で直面する壁と、当ラボ実環境でのDB・API分業解 |
|---|---|---|
| 国の法令(憲法・法律・政令・府省令・規則) | あり(e-Gov 法令API v2 / 一括XML) | 現行 8,992法令・263,348条文 を egov_laws.sqlite 化。ただし条文の約23.6%に政省令への委任規定があり、条文単体では細部が見えない。 |
| 国会の立法経緯・政府解釈(大臣答弁) | あり(国会会議録検索システムAPI) | 「なぜその条文になったか」の政府答弁を 国立国会図書館『国会会議録検索システムAPI』 で取得し、kokkai.sqlite に永続キャッシュしてミリ秒照合。 |
| 学術論文・専門図書・確定書誌(DOI) | あり(NDLサーチAPI・J-STAGE・PubMed) | AIの架空論文を防ぐため、国立国会図書館サーチAPI・J-STAGE・PubMedから実在書誌とDOIを取得し、ndl_search.sqlite へ統合。 |
| 省庁の白書・通達・診療指針・取説PDF | なし(各省庁や企業のPDF公開) | 横断APIがないため、外付けSSD上の原本 1,041冊(26,059頁) を macOS純正 Vision OCRで pdf_library.sqlite 化(旧版56冊の警告バッジ付き)。 |
| 自治体の個別条例・未公開判例 | なし(自治体別公開・網羅APIなし) | 必要な自治体資料PDFは上記ローカルPDF知識庫へ追加しつつ、APIで網羅できない個別判例や非公開運用はAIに断定させず「不明(要原典・専門家確認)」へ分離。 |
-
法改正の差分同期と「未施行改正」の上書き防止 :法令を一括XMLからSQLite化する際、公布されただけでまだ施行されていない「未施行の改正法」で現行条文を上書きしてしまう事故や、日々の法改正の取り込み漏れが最大のリスクになります。当ラボでは現行条文と未施行改正予定(
upcoming_revisions)をテーブル上で厳密に分離して差分同期(--sync)を回し、さらに記事公開コマンド実行時に「引用法令の廃止・記事更新日以降の法改正」をミリ秒で自動検問する安全装置を組み込んでいます。 -
略称検索と「漢字1〜2文字語」が引けない罠の突破 :生の法令データや
trigram(3文字分割)方式のSQLite全文検索だけでは、「道交法」のような通称や、「書面」「押印」「鉄」といった1〜2文字の重要語がヒットしません。実用環境では、法令略称を正式名称(「道路交通法」等)へ自動展開するエイリアス辞書と、1〜2文字語専用の軽量補助インデックス(short_fts)を併設する前処理が不可欠です。 -
公的APIの負荷配慮キャッシュとPDFの「旧版(改訂注意)」検知 :国立国会図書館のAPI群は多重アクセス禁止などの利用規約を守るため、一度取得した確定書誌や答弁レコードを単一SQLiteファイルへ永続キャッシュし、2回目以降は通信ゼロ(約1〜2ミリ秒)で再利用する設計が鉄則です。また、手元のPDFをまとめて全文DB化すると「数年前の古い診療ガイドラインや旧制度PDF」をAIが現行ルールと誤認しやすいため、公式出典URLの自動復元とあわせて改訂済み資料(56冊)へ自動で「旧版注意バッジ」を注入するフェイルセーフを徹底しています(詳細はPDFのダウンロード元URL確認と出典特定の自動化|SQLite管理と医療旧版検知でAI誤引用を防ぐ実証録を参照)。
外部製MCPサーバーの罠と軽量Rust CLIの優位性
では、VS Codeなどのエディタ上で動くAIエージェントに、これら手元の一次情報データベース群や公的APIを自動照会させたい場合、どのように接続するのが最適でしょうか。
2026年現在、AIエージェントに外部ツールを繋ぐ規格として「MCP(Model Context Protocol)」が普及しており、GitHub等には有志が作成した法令APIや各種検索対応のMCPサーバーも複数公開されています。しかし、実務の安全性と効率の観点から見ると、外部の第三者が作ったMCPサーバー(特にNode.jsやPython製)をそのまま自分の開発環境に入れる手法には3つの大きなリスク があります。
-
ランタイムとパッケージ依存の肥大化 :公開されている有志製MCPサーバーの多くはTypeScript(Node.js /
npx)やPython(uv)で書かれており、条文を1つ引くためだけに余計なランタイムと数百個の外部ライブラリ依存をPC内に抱え込むことになります。 -
生JSON丸投げによるトークン浪費(コンテキスト汚染) :汎用MCPサーバーの中には、APIが返した巨大な階層JSONやXMLを整形せずにそのままAIへ返す実装が少なくありません。数件の法令や文献を引いただけで数万トークンのノイズが会話履歴に流れ込み、AIの推論精度と応答速度を著しく低下させます。
-
サプライチェーン攻撃と保守停止のセキュリティリスク :第三者が管理するパッケージを自動実行(
npx -y等)する構成は、万が一パッケージが乗っ取られたり悪意ある更新が混入したりした際、ローカル環境への侵害に直結する管理体制(ガバナンス)上のリスクをゼロにできません。
この問題を根本から解決する最もクリーンな設計が、「手元の4大一次情報SQLite(法令・国会答弁・NDL書誌・保有PDF)と公式APIを直接叩き、不要なXML/JSONタグをすべて削ぎ落として『正確な条文番号・施行日・該当ページ・出典URL・本文抜粋』だけを最小トークンで標準出力へ返す小さなPure Rust製CLI(単体バイナリ)」 を1本用意することです。
当ラボでも外部クレート依存を極限まで削った単一のRustバイナリ(kb-search)にこれらの検索コマンドを集約しており、外部ランタイム不要・数ミリ秒で起動させています。AIエージェントにはターミナル経由でこの軽量CLIだけを叩かせることで、トークンを1トークンも無駄にせず、かつAIによる条文や出典の捏造を物理的に遮断できます。これからAI監督として堅牢なRust製CLIの設計思想を体系的に押さえておきたい方には、定番の解説書を1冊手元に置いておくのもおすすめです。
AI用の軽量CLIと人間用のLawtext拡張の使い分け
さらにここで重要になるのが、「AIが条文を検証するためのツール」と「人間が条文を読み込むためのツール」を無理に1つにまとめず、用途に合わせて明確に分業する という視点です。
なるほど!AIには余計な飾りを削ぎ落としたテキストだけを渡す軽量CLIが一番いいんだね。でも、人間がVS Codeの上で法律の全文をじっくり読みたいときは、コマンドラインの文字だけだとカッコが多くて読みづらくないかな?
そこがまさに「AI用」と「人間用」の切り分けどころです!人間がVS Code上で長文の法律を腰を据えて読むときは、無理にAIツールを介さず、法令専用のビューア拡張機能である『Lawtext』を使うのが圧倒的に読みやすいんです。
日本の法令文は「〇〇(以下「△△」という。)において、……(……を除く。以下同じ。)」のように二重・三重の括弧書きや他条文への準用参照が入り組んでおり、ブラウザの標準画面や生のテキストファイルで読むとすぐに迷子になります。
人間が自分の目で条文構造を追う場合は、Visual Studio Marketplaceで公開されている Lawtext(ID: yamachi.lawtext) 拡張機能をVS Codeに入れるのが最も実用的です。
| 比較項目 | AIエージェント用の軽量Rust CLI / SQLite | 人間用のVS Code拡張『Lawtext』 |
|---|---|---|
| 主な利用者 | AIエージェント(自動裏取り・横断監査) | 人間(条文の精読・構造理解・定義確認) |
| データ形式 | タグや装飾を削ぎ落とした最小トークンのプレーン条文 | 括弧の階層強調・定義語リンク・条項ジャンプ付きの構造化表示 |
| 得意な役割 | 記事やコード内の条文番号・文言の0.6秒〜ミリ秒単位の機械照合 | 複雑に入り組んだ括弧書きや「準用する」参照関係の視覚的な追跡 |
| 避けるべき誤用 | 人間が生のJSONやコマンド出力だけで長文法律の全体像を読もうとすること | 人間用のリッチな画面出力や巨大HTMLをそのままAIのコンテキストに流し込むこと |
このように、「AIには最小トークンで事実だけを突きつける軽量CLI(またはSQLite)」「人間には視覚的に構造を補助してくれる専用拡張機能(Lawtext)」 とインターフェースを切り分けることが、最大の障壁(ボトルネック)を解消して上位1割の生産性を手に入れる実践的な分業術です。
チャット相手から仕組みの設計者へ移行する実践手順
ここまでの内容を踏まえ、「単発のチャット相手」としてAIを使っている状態から、自分の業務や制作の「仕組みの設計者」へと移行するための4つのステップをフロー図にまとめます。
自分が毎回チャット欄で繰り返している「前提の説明」「表記・計算チェック」「事実確認」を書き出し、AIが毎回間違えるポイントを特定します。
特定したルールや業務の前提条件を1枚の「マスター仕様書(Markdownやテキスト台帳)」に外出しし、チャットのたびに手打ちする作業を廃止します。
正確な数値・法令・過去データの検索は公式資料やローカルDB(SQLite・軽量CLI)に任せ、定型チェックはチェックリストや検問スクリプトへ分離します。
事実とルールが外枠で固まった状態で、AIには「構成案の設計」「一次情報間の矛盾の抽出」「厳しい視点での自己批判(監査)」だけを集中して実行させます。
反復業務を棚卸ししてAIと定型ツールの境界を引く
仕組み化を始める際、最初から複雑なデータベースやプログラムを組む必要はありません。
第一に行うべきなのは、自分の日常業務や執筆作業を振り返り、「①1ビットの狂いも許されない定型・事実領域(=台帳・公式データ・検問ツールへ移すもの)」 と、「②文脈に応じた要約・構成・壁打ち・矛盾の洗い出し(=AIの推論へ任せるもの)」 の境界線を紙やメモ帳の上で明確に引くことです。この境界線が引けた瞬間、AIのハルシネーションに振り回されるストレスは劇的に減少し、AIが本来の推論能力を100%発揮できるようになります。
最上位モデルで自分の業務分業を設計するプロンプト
最後に、あなた自身の現在の仕事や制作作業を棚卸しし、「9割のチャット往復労働」から「上位1割の分業パイプライン」へと組み替えるための 事前調査ファースト・コピペ用プロンプト を用意しました。
推論を省略しやすい軽量モデル(Flash系や無料版の軽量モード)ではなく、必ず長文の論理設計と批判的検証に強い最上位推論モデル(Gemini 4 Carbon / Gemini 4 Argon 等)を選択し、新しいチャットを開いて以下の枠内をコピー&ペーストして実行してください。
あなたは熟練した業務アーキテクト兼システム監査官です。
私に対するお世辞、迎合(「鋭い視点ですね」等のクッション言葉)、曖昧な一般論は一切省き、冷徹かつ論理的に回答してください。

第一に、以下の参考記事の設計原則(9割が陥る単発チャット往復労働の罠と、上位1割が実践する「AIの確率的推論 × 1ビットも狂わないマスター台帳・ローカルDB・軽量CLI検問」の分業アーキテクチャ)を読み込んで前提として共有してください。
参考URL:https://lab.chihouzakki.com/blog/review/japan-ai-adoption-50pct-vs-mastery-10pct-workflow-gap-guide/

【厳守ルール(段階的実行)】
いきなり完成版のプログラムコードや長文の業務マニュアルを出力することは絶対に禁止します。最初は、以下の【私の現在の業務・AI利用の悩み】を分析し、「第1段階:業務の分業仕分けとマスター台帳の設計案」だけを出力して私の確認を待ってください。また、回答内では一次情報から確認できる「事実」、論理的な「推論」、現時点で情報が足りない「不明(私への質問)」を明確に分離してください。

---
【私の現在の業務・AI利用の悩み】
・主な業務/作業内容:(例:技術記事の執筆、契約書・法規の確認、社内報告書の作成、顧客データの集計など)
・現在AIで行っていること:(例:毎回チャット欄に前提を書いて下書きや要約を作らせている、法令や仕様を質問しているなど)
・困っていること・手戻り:(例:チャットが長くなると最初のルールを忘れる、ハルシネーションの裏取りに時間がかかる、毎回同じ指示を打つのが面倒など)
・使える環境:(例:非エンジニアでExcelとメモ帳のみ / VS Codeとターミナル・SQLite・Rust等が使える など)
---

【第1段階で出力してほしい内容】
1. 現在の作業の中で「確率で揺れるAIにやらせてはいけない定型・事実確認領域」の特定(3点)
2. 今日からチャット欄への手打ちをやめて1枚の「マスター台帳(仕様書)」に外出しすべき固定ルール項目の骨格案
3. 一次情報の取得や出力後の定型チェックを「人間用ツール/軽量スクリプト/チェックリスト」へ切り出す最小コストの分業構成案
4. 第2段階(実際のマスター台帳テンプレートや自動化スクリプトの作成)へ進むために、私に確認したい追加質問(3点以内)
まとめ:AIの迎合を剥がし自分の仕組みに組み込む
日本の個人AI利用率が5割を超え、大企業の推進度が87%に達した2026年現在、世間は「誰もがAIを使っている時代」に入りました。しかしその内実を見れば、単発の検索や下書きの補助にとどまる9割の層と、業務の仕組み(パイプライン)自体を組み替えて圧倒的な成果を出している1割の層との間で、かつてないほどの生産性格差が開いています。
みんながAIを使いこなしているように見えたのは上位1割の発信が目立っていただけで、大半の人はチャット欄の往復と裏取りで苦労していたんだね。でも、AIに忖度させず、台帳や専用ツールと分業する仕組みを作れば、今からでも確実にその1割側へ回れることがよくわかったよ!
はい!AIを「なんでも答えてくれる魔法の相談相手」として扱うのをやめて、「一次情報とマスター台帳を元に動く冷徹な推論・監査エンジン」として自分の仕組みの中に組み込んだ瞬間、手戻りのストレスは一気に消えていきますよ。
-
導入と成果の断絶を直視する :個人の利用経験58.8%・大企業の推進度87%に対し、「期待を大きく上回る成果」はわずか9%(6カ国最下位)、企業の「非常に活用」は4.4%です。単発のチャット利用にとどまる限り、ハルシネーションの確認作業で足踏みすることになります。
-
AIの「迎合」を剥がし、事実・推論・不明を分離させる :商用AIは利用者を気持ちよくさせるイエスマンになりやすい構造を持っています。お世辞を禁じ、一次情報(法令・官公庁統計・開示資料)だけを根拠に「事実・推論・不明」を分離させる運用を徹底してください。
-
AI推論と定型台帳・軽量ツールを明確に分業する :非エンジニアなら「1枚のマスター台帳とチェックリストの外出し」、技術者なら「法令・国会図書館API・保有PDFを統合したローカルSQLite+軽量Rust CLI(AI用)とLawtext拡張(人間用)の切り分け」のように、1ビットも狂わない定型基盤とAIの推論を組み合わせることで、初めて破綻しない実用システムが完成します。
まずは今日、いつもチャット欄に手打ちしている指示やルールを1枚のテキストファイル(マスター台帳)に書き出すところから、「仕組みの設計者」への第一歩を踏み出してみてくださいね。
▲ チャットの往復ではなく「仕組みそのもの」が正しく動いているか目を光らせる現場監督