スマホで撮りためた十数枚の実機写真とメーカー公式PDFをフォルダに放り込み、「この記事とこの記事に反映しておいて」と1行メモを送るだけで、AIが勝手に写真の仕分け・個人情報検閲・トリミング・複数記事の書き換え・本番公開・ブラウザ実機検査まで終わらせてくれたらどれほど快適でしょうか。
しかし実際のAIエージェント運用では、高解像度の生画像を10枚以上まとめて渡し、さらに複数記事の同時改修を指示した瞬間に、コンテキスト肥大による速度低下や30分稼働上限での途中停止という 最大の障壁(ボトルネック) に直面します。
結論からお伝えすると、2026年11月15日に当ラボ(公開総数 785記事:検証録 370記事・AI国家構想 415記事、設計憲法 1,372行)において、約1,219万画素の生JPEG写真12枚(計35.6 MB)と公式PDF 1本から別ジャンル3記事を同時更新し、Playwright本番3ページ検証までをトータル 22分42秒(1記事あたり約 7.6分)で完遂 しました。本記事では、司令塔 Gemini 4 Carbon (High) 1体とサブエージェント4体(計5体)が記録した生ログを1秒・1トークン単位で解剖し、「写真目視の隔離とSQLite裏番組スキャン」「Pure Rust 9スレッド並列WebP変換」「ファイル完全排他の3班同時編集」 という高速化の全手順を公開します。
-
AI開発で増えすぎた56コマンドと仕様書を暗記ゼロで回す術|全角対応Rustランチャー×SQLite管理台帳 : AIとの共同開発で56個に膨らんだpackage.jsonスクリプトや公開記事・内部仕様書を、暗記ゼロかつエディタ保存競合ゼロで操縦するコックピット設計術を実機解説。AT…
-
AIエージェントへの複数指示は別チャットか1チャット一括か?5件バルクで1件2.4分化した実測録 : 複数タスクを1チャットへ一括投入した際に、文脈共有と一括デプロイで処理時間が60%短縮された定量ベンチマークです。
-
ブログ1記事の修正でAIは何回ファイルを読む?68回のDB照会と丸読み破産の実測録 : わずか1記事の更新裏で発生するファイルI/Oの正体と、
read_file丸読みをゼロにするSQLite知識DBの解剖記録です。 -
AI自律開発の最適化7層総括|設計書3層分離・SQLite・Rust・Swarmの全設計図 : 当ラボが構築してきた7層の高速化・省トークン基盤の全体像を体系的にまとめた設計図です。
-
AIのツール呼び出し往復が遅い原因|Pure Rust前後一括化で出力83%減の実証録 : 細かいコマンド連打による「ツール往復税」を撤廃し、
prepとfinishの前後サンドイッチでミリ秒化した記録です。 -
AIエージェントのトークン節約とSQLite直結術|仕様書1コール化とCarbon並列監査で週間枠1%の実測録 : 12スレッド並列の1コール抽出とサブエージェント分業により、週間クォータ消費を極小化した実測データです。
-
10枚以上の実機写真やPDF資料 をAIエージェントに渡すと、急にレスポンスが重くなったりタイムアウトしたりして困っている方
-
複数の記事やソースコードを 1回の指示で同時にメンテナンス し、ビルドやデプロイの待ち時間を劇的に圧縮したい方
-
親エージェントとサブエージェント(子AI)の 具体的な役割分担・トークン消費量・キャッシュヒット率の実測値 を知りたい方
なぜ写真12枚と複数記事をAIに渡すと破綻するのか
テキスト中心の修正であれば軽快に動くAIエージェントも、スマホで撮影した高解像度写真が10枚を超え、さらに複数ファイルの改修が重なった途端に挙動が不安定になります。まずはその構造的な原因と、今回投入した実戦ワークロードの内訳を整理します。
生画像12枚の直読みが招くコンテキスト肥大と制限
近年のスマートフォンで撮影した生JPEG写真は、1枚あたり 3024×4032 px(約1,219万画素・約2.5〜3.5 MB)に達します。これを親エージェント(司令塔)が自身のコンテキストへ12枚すべて直接読み込む(read_file する)と、深刻な連鎖遅延が発生します。
AIエージェントは1ステップ進むごとに、それまでの会話履歴と読み込んだメディアデータを次回推論の入力として引き継ぎます。親エージェントが序盤で生画像12枚を抱え込むと、その後に続く記事検索・テキスト編集・ビルド・デプロイ確認の 全30〜50ステップすべてに巨大な画像コンテキストがぶら下がり続ける のです。
その結果、推論のレイテンシ(応答待ち時間)が雪だるま式に延びるだけでなく、注意散漫(アテンション希釈)によって細かい書式ルールを見落としたり、エージェントの1ターン実行上限(30分タイムアウト)に引っかかって作業途中で停止したりする事故が多発します。
今回の実戦負荷:別ジャンル3件と公式PDFの同時投入
2026年11月15日15時18分、当ラボの作業フォルダに投入したのは、単一テーマの簡単な画像追加ではなく、まったくジャンルの異なる3つの既存記事に対する複合アップデート要求 でした。
-
投入メディア総量 : スマホ撮影の生JPEG画像 全12枚(各
3024×4032px または4032×3024px=約1,219万画素、合計35,591.8 KB[約35.6 MB])+ シヤチハタ公式『ネーム印の取り付け方法(X5901_X-GQN.pdf)』 の外部一次PDF URL 1本 -
更新対象①(日用品・温度実測) : サーモス「真空断熱コーヒーサーバー TTF-720」実機レビュー|内面セラミック加工とHARIOアームスタンド適合検証 ―― 昼13:03に85℃湯温でハンドドリップした直後の初期液温
74.1℃のデジタル温度計実測写真(1枚:IMG_0290.jpeg)を追加し、既存の8時間半後(48.6℃)までの保温推移データと統合。 -
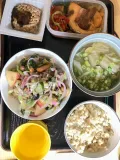
更新対象②(健康・食事戦略) : 糖新生を防ぎ脂肪燃焼を最大化する運動と食事|食後高血糖の即効対処法と血糖値帯別ルール ―― 加水率2倍で炊いたもち麦
150g・山盛りサラダ・どんぶり味噌汁・焼き鮭&鶏肉の朝食トレー実機写真(1枚:IMG_0291.jpeg)につき、外周の不要物(右端のサプリ袋端や下端の膝元等)をトリミング除去して追加。 -
更新対象③(文具・組立手順) : シヤチハタ「キャップレス9」メールオーダー式レビュー|片手ワンタッチ捺印と8書体・6色注文の全手順 ―― Web注文で後日届いた印面パーツの開封から、手順1〜4の装着完了・PP製プラ部品の分別廃棄までの実機写真10枚(うちピンボケ撮り直し前の
IMG_0293.jpeg1枚を自動検出し除外した採用9枚)と公式PDF一次出典を追加。

コーヒーの温度測定1枚に、朝ごはんのトレー写真1枚に、ハンコの組み立て写真10枚で計12枚かいな!しかもピンボケ写真が1枚混ざっとるし、背景の端っこも切り抜かにゃいけん。これ、普通に1個ずつAIに頼みよったら1時間は軽く吹っ飛ぶで。

そうなんです。もし親エージェント1人が生写真12枚を順番に見て、3記事を1本ずつ直列で書き換え、毎回ビルドと転送を回していたら、推論(単純積算による試算)で 約55〜65分前後 かかります。これをどうやって 22分42秒 に圧縮したのか、実際の生ログを見ていきましょう!
実測22分42秒の全5工程タイムラインと生ログ解剖
今回のセッション(親タスクID:de1666a5)は、15:18:03 の指示受信から 15:40:45 の最終報告完了まで、壁時計(実時間)で トータル 22分42秒(1,362秒 = 22.7分) で完走しました。1記事あたりに換算すると 約 7.6分 という速さです。
工程別の所要時間と待ち時間消滅の全体像
全1,362秒の内訳を5つのフェーズに分解すると、AIの推論待ち時間をローカルのRust処理と並列サブエージェントでどのように相殺したかが鮮明に浮かび上がります。
| 工程フェーズ | 時刻レンジ(JST) | 実測所要時間 | 主な実行主体と高速化・オフロード処理の内訳 |
|---|---|---|---|
| 工程① 初期照合&写真12枚の隔離目視 | 15:18:03〜15:26:00 |
7分57秒(477秒) |
親は media-scan(1.08 ms)でEXIFのみ取得。生写真12枚の目視検閲は research 子班(6.8分)へ隔離し、裏で親がSQLiteから3記事の行番号とGSCクエリを並走特定 |
| 工程② PDF検視・トリミング・並列WebP化 | 15:26:00〜15:31:33 |
5分33秒(333秒) |
公式PDFの視覚確認、3記事バックアップ、朝食写真の cwebp -crop 1発切り抜き(94.5%圧縮)、キャップレス9写真の9スレッド並列変換(約8秒)、元12枚の退避(1.06 ms) |
| 工程③ ファイル完全排他の3班並列編集 | 15:31:33〜15:37:36 |
6分03秒(363秒) |
self サブエージェント3班が3記事を同時編集&単体 gemini-gate --files 合格。純稼働合計 15.7分 を壁時計 6分03秒 に圧縮(約2.6倍高速化) |
| 工程④ 仕上げ監査・ビルド・SFTP転送 | 15:37:36〜15:39:48 |
2分12秒(132秒) |
3記事一括 finish が 747.2 ms で通過。リンク網&出典20本ライブ照合(4.78秒)→ Astroビルド → 4,475件中の差分SFTP転送(約 828 KB)が 約71秒 で完走 |
| 工程⑤ Playwright本番3ページ一括検証 | 15:39:48〜15:40:45 |
0分57秒(57秒) |
browser_run_code_unsafe 1コール統合により、本番3ページ(計85画像・横はみ出しゼロ)を わずか17秒 で一括実機検証し完了報告 |
| 合計(全5工程トータル) | 15:18:03〜15:40:45 |
22分42秒(1,362秒) |
1記事あたり平均 約7.6分(親のテキスト丸読み read_file 0回 で完遂) |
特に注目していただきたいのが 工程①の裏番組並走 と 工程③の3班並列編集 です。写真が12枚もあるため、AIが1枚ずつ視覚的にピントや個人情報の有無を確認する処理自体にはどうしても約6.8分かかります。しかし、その目視作業を子エージェントへ隔離委譲したことで、親エージェントは待ち時間ゼロでSQLiteの検索と編集計画の策定を同時進行 できました。
親エージェントと子4体のトークン消費とキャッシュ率
「サブエージェントを4体も起動したら、トークン消費が爆発してしまうのではないか?」という疑問に対し、セッション終了後に取得した全5体のトランスクリプト(transcript.jsonl)の実測値をすべて公開します。
| エージェント役割(ID) | 稼働時間 | ステップ / ツール数 | ログ容量 | Fresh入力トークン | Cache読込トークン(Hit率) | 出力トークン |
|---|---|---|---|---|---|---|
親:司令塔 Carbon(de1666a5) |
22.7分 |
32 steps / 54 tools | 233.3 KB |
552,012 tok |
2,856,620 tok(83.8%) |
34,669 tok |
子①:写真12枚目視班(6c1dca73) |
6.8分 |
13 steps / 23 tools | 58.9 KB |
94,957 tok |
449,768 tok(82.6%) |
17,733 tok |
子②:サーモス編集班(753af5b0) |
5.6分 |
10 steps / 16 tools | 70.1 KB |
109,323 tok |
433,300 tok(79.9%) |
21,321 tok |
子③:もち麦150g編集班(f3cc835b) |
5.0分 |
13 steps / 15 tools | 72.1 KB |
101,413 tok |
532,308 tok(84.0%) |
14,722 tok |
子④:キャップレス9班(e8361302) |
5.1分 |
12 steps / 23 tools | 77.0 KB |
112,235 tok |
563,127 tok(83.4%) |
20,896 tok |
| 子エージェント4体 合算 | 延べ 22.5分 |
計48 steps / 77 tools | 計 278.1 KB |
417,928 tok |
1,978,503 tok(平均 82.6%) |
74,672 tok |
親エージェントは32ステップ・54回のツール呼び出しを行いながら、テキスト系ファイルの丸読み(read_file)を1回も行わず(0回)、メディア確認の3回(公式PDFとトリミング仕上がり確認のみ)に抑えました。そして子エージェント4体もそれぞれ10〜13ステップの短期集中でタスクを完了させたため、全5体で キャッシュヒット率 79.9%〜84.0% という極めて燃費の良い推論を実現しています。
ほんとだ!子エージェント1体あたりのFresh入力トークンが約9.5万〜11.2万トークンでピタッと揃ってるわね。親が生写真12枚と長文記事3本を全部抱えて32ステップも回るより、よっぽど整理整頓されてて無駄がないじゃない!
益々高速化した5つの並列オフロード設計
なぜ今回のパイプラインがここまで滑らかに動いたのか、従来の「親1人による直列抱え込み」と今回の「マルチモーダル隔離&3班排他並列パイプライン」の構造的な違いを比較図解と5ステップのフローで詳しく紐解きます。
-
親が生JPEG 12枚(
35.6 MB)を直接read_fileし、全ステップで画像トークンを引きずる -
写真を見ている約7分間、記事の検索や構成案の作成が完全にストップする
-
3本の記事(計約3万字)を1本ずつ順番に読んで書き換えるため編集だけで15分以上かかる
-
途中でコンテキストが膨れ上がり、30分稼働上限や書式ミスに直面しやすい
-
親は
media-scan(1.08 ms)でEXIFだけ取得し、12枚の目視検閲はresearch子班へ完全隔離 -
子が写真を見ている裏で、親が SQLiteのWALモード 知識DBを21回叩いて3記事の改修座標を特定
-
cwebp1発トリミングと Rustのstd::thread並列処理 で9枚のWebP変換をわずか8秒で完遂 -
self3班が完全排他で3記事を同時編集(6分03秒)し、親が一括ビルド&17秒で本番検証
写真10枚超の目視隔離とSQLite裏番組スキャン
1つ目の高速化ポイントは、「高解像度画像の目視を親から切り離し、その待ち時間をSQLite検索の裏番組として活用した」 ことです。当ラボでは「写真10枚超の投入時は、親は media-scan によるEXIF取得のみとし、目視・WebP変換は子またはRustへ分担する」という運用規定を設けています。
開始直後の 15:18:03、親エージェントはまず Pure Rust 製バイナリ gemini-gate media-scan を叩き、わずか 1.08 ms で生JPEG 12枚の撮影日時(EXIF)・解像度・ファイルサイズ一覧を取得しました。そして即座に読み取り専用の research サブエージェント(子①)を起動し、生画像12枚の視覚確認を委譲しました。
子①が12枚の画像を1枚ずつ精査し、「キャップレス9の写真10枚のうち IMG_0293.jpeg は接写しすぎてピントが甘く、直後の IMG_0294.jpeg がピント鮮明な撮り直し成功版であるため 0293 は除外すべきこと」「印面ユニット天面の氏名ラベルが黄色い粘着テープと当て紙で物理的に完全遮蔽されており個人情報の写り込みがゼロであること」を検閲している6.8分間、親エージェントは手を休めません。
親はその裏で ./scripts/run_kb_search.sh(SQLiteのWAL[Write-Ahead Logging]モード とFTS5全文検索エンジンを直結したPure Rustバイナリ)を並列駆動し、対象3記事のセクション構造・挿入すべき行番号・Google Search Console(GSC)の保護すべき上位検索クエリをすべて特定し終えました。子①から検閲レポートが返ってきた 15:26:00 の時点で、親の手元には完璧な設計図が揃っていたのです。
Rust並列WebP変換とcwebp一発トリミング
2つ目の高速化ポイントは、「画像の切り抜き(トリミング)やWebP変換で使い捨てのPythonスクリプトを書かない」 ことです。AIエージェントに画像処理を任せると、わざわざPythonの Pillow スクリプトを新規作成して実行・削除する回り道(ツール往復税)をしがちです。
今回は朝食トレーの写真(IMG_0291.jpeg:4032×3024 px、2,782.9 KB)の右端にサプリメント小袋の端、上下端に容器の端や撮影者の膝元がわずかに写り込んでいました。親エージェントはスクリプトを1行も書かず、Google公式『cwebp』ドキュメント の標準フラグである -crop と -resize を組み合わせた以下の1コマンドを実行しました。
cwebp -q 85 -crop 0 165 3856 2620 -resize 1200 0 _gemini_history/ブログ用/20261115/IMG_0291.jpeg -o src/content/blog/review/gluconeogenesis-fat-burn-post-meal-glucose-strategy/images/mochimugi_150g_breakfast_tray.webpこの1発実行だけで、外周の不要領域を1ピクセルの欠けもなく切り抜きながら横幅 1,200 px(1200×816 px)のWebP画像(152.1 KB:94.5% 圧縮)を生成できました。さらに、シヤチハタ『キャップレス9』の採用写真9枚は、Pure Rust製の gemini-gate convert-image --out-dir(内部で Rust標準ライブラリの std::thread マルチスレッド機構 を用いてCPUコアを並列駆動するエンジン)により、15:30:23 から 15:30:31 までのわずか約8秒 で一括WebP変換を完了させました。変換後の元JPEG 12枚も media-scan --archive-to(スキャン 1.06 ms)で即座にアーカイブフォルダへ安全退避しています。
ファイル完全排他の3班同時編集とミリ秒デプロイ検証
3つ目の高速化ポイントは、「編集は3班で完全排他並列(Map)、仕上げとデプロイ検証は親1人で一括統合(Reduce)」 という役割分担です。全体の流れを5ステップの垂直フロー図にまとめます。
親は media-scan でEXIFのみ取得。生JPEG 12枚の目視・ピンボケ除外(IMG_0293)・個人情報検閲は research 子①へ隔離し、裏で親がSQLiteで3記事の行番号を特定。
公式PDF(X5901_X-GQN.pdf)を視覚読取し3記事を事前バックアップ。朝食写真を cwebp -crop で94.5%圧縮し、キャップレス9写真を約8秒で一括WebP化して元画像を退避。
子②(サーモス 74.1℃ 追記)・子③(もち麦 150g 朝食追記)・子④(キャップレス9手順+PDF出典追記)が同時稼働。純稼働計15.7分を壁時計6分03秒へ圧縮し単体検査合格。
3記事一括 gemini-gate finish を0.75秒で通過後、リンク網&出典20本ライブ検問(4.78秒)、自動バックアップ、Astro本番ビルド、4,475件中の差分SFTP転送(約828KB)を一括完遂。
browser_run_code_unsafe 1コール内で本番3URLを連続巡回し、全85画像の自然幅読込・未変換記法ゼロ・モバイル横はみ出しゼロをわずか17秒で実機確認して完了。
工程⑤の本番実機検証においても、従来のように browser_navigate → browser_evaluate → browser_close を3ページ分(計9ツールコール)小刻みに往復させることはしません。Playwright公式『Evaluating JavaScript』ドキュメント の page.evaluate() 機構を browser_run_code_unsafe の単一スクリプト内に統合し、1回のツール呼び出し(実測17秒)で3記事すべてのDOM・計85枚の画像描画・モバイル幅(390×844)のはみ出し検査まで一気に完走 させています。
並列パイプラインで事故を防ぐ3つの安全境界と母艦環境
複数のAIエージェントを同時に走らせる際、無秩序に並列化すると「同じファイルを同時に書き換えて壊す」「ピンボケ写真や個人情報がそのまま公開される」「ビルド中にメモリ不足でスワップする」といった事故が起きます。当ラボが徹底している 管理体制(ガバナンス) の安全境界と、それを支えるハードウェア環境を解説します。
ファイル排他ロックとプライバシー二重検問の鉄則
並列パイプラインを100%安全に回すため、今回のセッションでは以下の3つの安全境界(ガードレール)を厳格に適用しました。
-
ファイル単位の完全排他ロック(MapとReduceの分離) : 並列起動した
selfサブエージェント3班(子②・子③・子④)には、それぞれ 自分が担当する1記事の.mdxファイルのみ の編集権限を与え、共通設定ファイル(src/consts.ts等)の編集やfinish・git・本番環境転送の実行を厳禁としました。各班は単体の./scripts/run_gemini_gate.sh --files <担当MDX>が0件合格するところまでを担当し、最後の統合・リンク結線・デプロイは必ず親1人が一括実行します。 -
目視検閲サブエージェントと親によるプライバシー二重検問 : 実機写真で最も怖いのが、氏名・印影・配送伝票・室内の背景・身体の一部などの意図せぬ写り込みです。今回は子①(
research班)が全12枚を検閲して「印面ユニット天面の氏名ラベルが黄色いテープで完全遮蔽済みであること」「朝食写真の右端にサプリ小袋の端、下端に膝元が写っていること」「IMG_0293.jpegがピンボケであること」を報告し、さらに親エージェントがcwebp -crop実行後のWebP画像を自らの目で再確認してから記事へ組み込む二重検問を実施しました。 -
一次出典PDFのネイティブ視覚読取とインライン結線 : シヤチハタ『キャップレス9』の印面取付手順では、推測で手順を書かず、シヤチハタ公式『ネーム印の取り付け方法(X-5901 / X5901_X-GQN.pdf)』 を直接読み取り、「ネーム印は部品Aから取りはずさない」「ロックを解除した状態でスライド溝とスライド部の位置を合わせてシャッターを引き抜く」「印面ラベル(材質:紙)と部品A・部品B(材質:PP=ポリプロピレン)はセット完了後に自治体ルールに従い廃棄する」といった正確な 裏付け(エビデンス) を取得した上で、子④へ構造化ブリーフとして渡しました。
今回の実戦パイプラインで同時に更新された実物アイテム(サーモス『TTF-720』、シヤチハタ『キャップレス9 メールオーダー式』、国産もち麦『きらりもち』)は、いずれも日々の生活効率と健康を底上げしてくれる定番品です。各記事に追加された最新の実測写真とあわせてぜひチェックしてみてください。
並列AIとRustビルドを支える64GBメモリ母艦
親エージェント1体+サブエージェント4体の計5本が並行して動き、裏でSQLiteの12スレッド並列検索、Pure Rustの9スレッド画像変換、RAMDisk(APFSメモリディスク)上でのAstro本番ビルド(全 785記事 規模・4,475ファイル出力)、さらにPlaywrightのヘッドレスChromium検証が同時に走るワークロードでは、ローカル母艦のメモリ容量とストレージ帯域がそのままAI並列パイプラインの処理速度に直結 します。
AI自体はクラウドのサーバーで動いとるんじゃけえ、手元のパソコンなんか安物の8GBや16GBメモリでも一緒じゃないんか?
そこが大きな落とし穴なんです!AIの推論を速くするには、手元のMac側で「16GBのRAMDisk」「Rustのマルチスレッド変換」「SQLiteのインメモリキャッシュ」「Playwrightブラウザ」をスワップ(SSDへの退避遅延)ゼロで同時に回す必要があります。メモリが足りないと、せっかくAIが並列化してもローカルの処理待ちで足止めされてしまうんですよ。
ここで、64GBユニファイドメモリを搭載した母艦(Mac mini Pro構成等)や超高速Thunderbolt SSD、および最上位AIプラン(Google AI Ultra 20x 等)への投資を「タイム・イズ・マネー(時間の価値)」の視点から試算してみます。以下は耐用年数と毎日の使用時間で割った日割り・時間単価の 推論(設備投資の償却モデルによる試算) です。
-
64GBメモリ搭載Mac母艦+Thunderbolt高速SSDの償却試算(推論) : 仮に母艦と高速SSDの初期投資を合計約36万円とし、4年間(1,460日)・毎日平均5時間稼働させると仮定した場合、1日あたりの設備コストは約247円、1時間あたりではわずか約49円(推論)です。缶コーヒー1本分にも満たない1時間約49円の投資で、RAMDisk 16GB常駐とRust並列ビルドが4年間ずっとスワップゼロで動き続けます。
-
1回の並列更新で浮く「35〜40分」の積み重ね価値(推論) : 今回のように12枚の写真整理と3記事更新が約60分から約22分へ短縮されると、1回の作業あたり約35〜40分の自由時間 が生まれます。月20回こうした更新や開発を行えば 毎月約12〜13時間(年間約150時間) もの時間を創出でき、自分の時給を仮に3,000円と見積もっても 年間約45万円相当の時間価値(推論)を生み出す計算になります。
ローカル側で16GBのRAMDiskとSQLite・Pure Rust検問所を余裕で常駐させられる 64GBユニファイドメモリ構成のMac mini と、数十ギガバイトの生写真アーカイブや知識DBを瞬時に読み書きできる SanDisk Professional『PRO-G40 SSD』 の組み合わせは、AI並列開発のストレスを根底から消し去ってくれる最良の相棒です。
まとめ:自分の開発環境へ段階導入するプロンプト
生写真12枚(35.6 MB)と公式PDF 1本から別ジャンル3記事を同時更新し、Playwright本番検証までを 22分42秒(1記事あたり約 7.6分) で完遂した今回のセッションは、特別な魔法を使ったわけではありません。
- 重い視覚処理(10枚超の生画像検閲)を読み取り専用サブエージェントへ隔離し、親の待ち時間をSQLite検索の裏番組として相殺すること
- 画像の切り抜きや変換で使い捨てスクリプトを書かず、
cwebpやRustマルチスレッドへ直接オフロードすること - 複数ファイルの編集は「1班1ファイル完全排他」で並列化し、最後のビルドとブラウザ検証は親1人で1回に統合すること
この3つの原則を組み合わせるだけで、AIエージェントの処理速度と安定性は別次元に引き上がります。
ご自身のブログ運営やシステム開発環境にこの並列オフロード設計を段階的に取り入れたい方は、以下のプロンプトをコピーしてご自身のAIエージェント(Antigravity、Claude Code、Cursor等)へ貼り付けてみてください。
💡 AIモデル選択の重要な注意点 :軽量モデルや高速簡易モデル(Flash系や軽量モード等)にこの設計を行わせると、ファイル排他ロックの安全境界を読み飛ばして複数エージェントに同一ファイルを同時編集させる事故が起きやすくなります。必ず
Gemini 4 ArgonまたはGemini 4 Carbon(あるいは各社の最上位推論モデル・High思考モード) を選択して実行してください。
以下の検証記事(生写真12枚とPDFから3記事同時更新を22分42秒で完遂したAI並列パイプラインの実測録)を読み込み、現在の私のプロジェクト環境に「マルチモーダル目視隔離」と「ファイル完全排他の並列編集パイプライン」を段階的に導入するための設計計画を作成してください。

参照URL: https://lab.chihouzakki.com/blog/review/multimodal-12photos-3posts-22min-parallel-pipeline/

【厳守ルール(いきなりファイルを書き換えないこと)】
1. まずは現在のワークスペースの構成(画像フォルダ、記事やコードの配置、ビルド・検証スクリプト、ルール定義ファイル)を確認し、いきなりファイルを変更せず「段階的な導入計画(Phase 1〜3)」を提示して私の合意を得てください。
2. Phase 1(画像処理と目視の隔離):高解像度画像が複数枚投入された際、親エージェントが全画像を直接抱え込まず、EXIF・サイズ確認の軽量コマンドと「目視・個人情報検閲専用のサブエージェント(読み取り専用)」へ分離する運用ルールを設計してください。
3. Phase 2(ファイル完全排他の並列編集):3ファイル以上の更新時に、各サブエージェントへ「1班1ファイル完全排他(共通ファイルの変更やビルド・git操作は禁止)」で割り当て、親エージェントが裏で検索・準備を進める手順を定義してください。
4. Phase 3(一括ビルド&1コール検証):各班の編集完了後、親エージェントが1回だけビルド・整合性チェック・ブラウザ検証を一括実行する統合フローを提案してください。
写真を撮って1行メモを投げるだけで、複数の記事が正確かつ清潔にアップデートされていく快感は、一度体験すると手放せなくなります。ぜひご自身の環境でも、安全境界を守った並列パイプラインを育ててみてくださいね。

3つの記事が猛スピードで同時更新されていく横で、うちの猫様は最初から最後まで変わらずすやすやと夢の中でした。人間も猫様のようにゆったり構えながら、重い作業は賢い分業パイプラインにどんどん任せていきましょう!