Gemini『アクティビティの保存』2分割と学習オフの罠|履歴オフでも2か月保持の仕様と『あえて学習オン』戦略
2026 年 11 月中旬、Google から Gemini 利用者へ向けて 「Gemini アプリのプライバシー設定を更新」 という重要な通知メールが配信されました。これまで 1 つのスイッチに束ねられていた [アクティビティの保存] が、今後数週間のうちに 「履歴」 と 「生成AIモデルのトレーニング」 という 2 つの独立した設定へ分離されます。
この変更を受けて、SNS やネット上では早くも「履歴はオンにして便利に残しつつ、AI のトレーニング(学習)だけをオフにするのが最強の設定だ!」という解説が飛び交っています。しかし、公式ヘルプの更新文面を一字一句読み解くと、「履歴をオフにしても約 2 か月間はチャットがサーバーに保存され、人間のレビュアーによる確認対象にもなり得る」 という重大な仕様変更が見落とされています。
さらに深刻なのは、誰も彼もが「履歴だけ残して学習はオフ」というタダ乗り設定へ逃げ込むと、生きた日本語の試行錯誤や微妙な行間データが枯渇して AI が事なかれ主義の優等生へ劣化する(モデル崩壊を起こす)という構造的な罠です。本当の最適解は、実名・口座・税務・訴訟などの固有の機密を手元のローカル環境(SQLite+外付けSSD)へ完全隔離したうえで、固有名詞を伏せた普遍的な思考ロジックや日本語の壁打ちは 「あえて学習オン」で次世代 AI へ還元する二層戦略 にあります。-
AIの学習オンは100%使われる?皆が制限して日本語の行間が死ぬ理由と『口の堅い参謀』育成術 : 学習オンでも全量が丸暗記されるわけではない 3 段階サンプリングの裏側と、過剰な制限で日本語の「空気を読む力」が失われる理由を解説しています。
-
AIチャットの会話漏洩は起きる?Gemini・ChatGPTの分離仕組み(TSS)と学習オフ設定 : 世界中で何億人も同時に使う AI がどのように会話セッションを物理分離(TSS)し、他人の画面への混線を防いでいるのかを検証しています。
-
AI回答の評価ボタン(👍👎)は押すな!VS Codeでコード送信を招く罠と2つのコピーボタン使い分け術 : 回答下の高評価・低評価ボタンを押すことで人間レビュー用のデータ保持が発生する仕組みと、安全なコピー手順をまとめています。
-
ChatGPT・ClaudeからGeminiへ履歴移行する方法|ZIPインポート手順とSQLite無劣化保管術 : クラウド側の保存期間設定に依存せず、エクスポートした対話履歴 ZIP 原本を手元の Mac(SQLite+Markdown 正本)へ無劣化保管する手順を紹介しています。
-
AIのモデル崩壊(学習データ枯渇)と機密保護の解決策|記憶分離と3段階集合知蒸留 : ハードウェア暗号隔離領域(光 TEE)と法定の守秘義務を統合し、個人の秘密を 100% 守りながら集合知だけを抽出する次世代アーキテクチャを考察しています。
-
Google から 「Gemini アプリのプライバシー設定を更新」 というメールや通知が届き、具体的に何が変わるのか正確な仕様を知りたい方
-
「履歴をオフ(または学習をオフ)にしておけば、入力した機密は即座に消えて誰の目にも触れない」 と思い込んでいる方
-
過去のチャット履歴は便利に検索したい一方で、どこまでを AI のトレーニングに許可し、どこからを手元に隠すべきか の線引きで迷っている方
-
Gemini アプリの設定だけでなく、AI 開発環境(Google Antigravity IDE 等)のテレメトリ設定や公開 Web 発信 を組み合わせて、自分の思考を最も深く理解する AI 参謀を育てたい方

Google から「Gemini アプリのプライバシー設定を更新」っていうメールが届いたぞ!これまで一緒くただった設定が「履歴」と「生成AIモデルのトレーニング」の 2 つに分かれるらしい。これからは履歴だけオンにして、学習はオフにしておけば万事解決じゃないか?

一見するとそう思いますよね!でも実は、今回の通知の後半に書かれている「履歴をオフにした場合の約 2 か月保持(人間レビュー含む)」という一文を読み飛ばしていると、思わぬ情報管理の落とし穴にはまってしまうんです。さらに「みんなが学習オフにする副作用」まで含めて、順番に紐解いていきましょう!
Gemini設定2分割の変更点と自動移行の仕組み
アクティビティ保存から履歴と学習への分離
まずは、2026 年 11 月 16 日〜 17 日付で更新された Google Gemini ヘルプ公式『Gemini アプリのプライバシー ハブ』 および 『Gemini アプリ アクティビティ(履歴)の管理と削除』 の一次情報にもとづき、今回届いた通知の正確な中身を確認しておきましょう。
実際に配信された Google からの通知案内がこちらです。
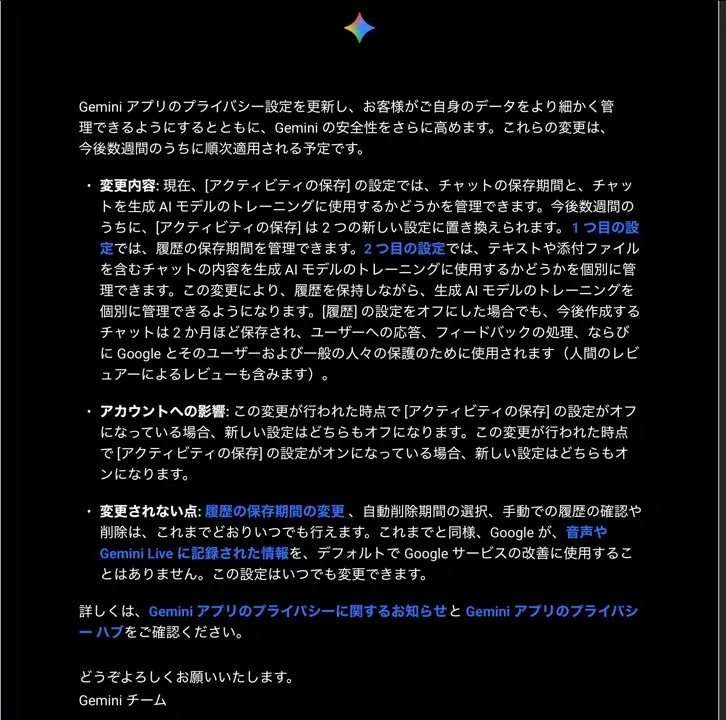
▲ Googleから届いた「Gemini アプリのプライバシー設定を更新」通知(宛名部分はマスク処理済)
従来の Gemini アプリでは、[アクティビティの保存] という単一の設定スイッチしか用意されていませんでした。そのため利用者にとっては、「過去のチャット履歴を保存して後から見返したいなら、Google の AI モデル学習への利用もセットで受け入れるしかない(学習を拒否してオフにすると、自分のチャット履歴まで保存できなくなる)」 という非常に不便な二律背反(トレードオフ)が存在していたのです。
今回の仕様変更により、今後数週間のうちに従来の [アクティビティの保存] は廃止され、以下の 2 つの独立した設定 に置き換えられます。
-
1つ目の設定:
[履歴](チャット履歴の保存と期間管理) :自分の Google アカウントに過去のチャット履歴を保存し、後から別端末で続きを話したり検索したりできるようにする設定です。保存期間(デフォルトの 18 か月、または 3 か月・36 か月での自動削除)の変更や、特定チャットの手動削除をここで管理します。 -
2つ目の設定:
[生成AIモデルのトレーニング](学習利用の個別スイッチ) :テキストや添付ファイルを含むチャットの内容を、Google の生成 AI モデルのトレーニング(性能改善・再学習)に使用するかどうかを、[履歴]とは切り離して個別にオン・オフできる設定です。
既存設定の自動引き継ぎと音声データの扱い
ここで多くの方が気になるのが、「自分のアカウントに更新が適用された瞬間、設定は勝手にオンへ切り替わったりしないのか?」 という点です。
公式発表および更新後のヘルプ仕様によると、移行時の初期状態は 「変更が適用される時点での従来の [アクティビティの保存] 設定をそのまま引き継ぐ」 というルールになっています。なお、公式ヘルプの履歴・トレーニング管理仕様 では 「トレーニングへの使用をオンにするには、[履歴] がオンになっている必要がある」(履歴オフのまま学習だけオンにはできない)と定められており、新規設定時や一度オフにした状態からはトレーニング設定はデフォルトでオフになります。また、音声や Gemini Live に記録された情報については、これまでと同様、デフォルトでは Google サービスの改善には使用されません。
従来の設定と、移行後に実際に選べる 3 つの設定パターン の挙動を一覧表に整理しました。
| 設定パターン | 1つ目の設定:[履歴] |
2つ目の設定:[生成AIモデルのトレーニング] |
移行時の自動引き継ぎ条件と実際の挙動 |
|---|---|---|---|
| パターン①:フル活用・還元型 | オン(3 / 18 / 36か月保持) | オン(モデル学習に協力) | 従来「オン」だった人の初期状態。履歴が残り、一部データが将来のAI改善にも活かされる |
| パターン②:履歴保存・学習拒否型 | オン(3 / 18 / 36か月保持) | オフ(モデル学習から除外) | 今回の分割で新たに可能になった組み合わせ。自分の履歴は残しつつモデル再訓練からは外せる |
| パターン③:完全オフ型 | オフ(履歴一覧には残さない) | オフ(履歴オフに連動して無効) | 従来「オフ」だった人の初期状態。ただし後述の通り 「約2か月間のサーバー保持」 は発生する |
このように、以前から [アクティビティの保存] をオフにしていた方は自動的に「どちらもオフ(パターン③)」へ、オンにしていた方は「どちらもオン(パターン①)」へとシームレスに移行します。
スマホ・PCでの切り替え手順と法人版・APIの違い
実際に手元のスマートフォンやパソコンで現在の適用状況を確認・変更する手順は、端末によって入り口が異なります。迷わないようデバイス別の操作経路を整理しました。
-
スマホ・タブレット(iPhone / iPad / Android アプリ) :Gemini アプリを開き、画面右上の プロフィール写真(またはイニシャル) をタップして
[履歴](順次適用前のアカウントでは[Gemini アプリ アクティビティ])を開きます。ここから[履歴]のオン・オフ(および 3 か月・18 か月・36 か月の自動削除期間)と、[生成AIモデルのトレーニング]([テキストやアップロードを含むチャット コンテンツ]のチェック項目)を個別に切り替えられます。 -
パソコン(Web ブラウザ版) :画面左下の
[設定とヘルプ](歯車アイコン) >[履歴]をクリックするか、Google 公式ヘルプ『Gemini アプリの履歴を管理、削除する』 内の案内からマイアクティビティ管理画面(myactivity.google.com/product/gemini)を開いて切り替えます。設定は端末ごとではなく Google アカウント単位で同期 されるため、スマホとパソコンのどちらか一方で変更すれば全端末へ即座に反映されます(※数週間かけて順次ロールアウトされるため、旧画面の方は適用完了後に 2 項目へ分かれます)。 -
特定の会話だけ残したくない場合(「一時チャット」の活用) :普段は履歴オンにしつつ単発の相談だけ履歴一覧やパーソナライズ・モデル学習から外したい場合は、新規チャット横の 「一時チャット(Temporary Chat)」 が便利です。ただし、一時チャットであっても後述する安全性・フィードバック処理のための短期サーバー保持対象になる点は共通しています。
また、よく混同されやすいのが 「有料プランに課金していれば自動的に学習オフになるのか?」「会社の Google Workspace アカウントや開発者向け API はどう扱われるのか?」 というアカウント種別ごとの境界線です。Google Gemini ヘルプ公式『プライバシー ハブ』 および 『Gemini API 追加利用規約』 に基づく違いは以下の通りです。
| 利用アカウント・契約区分 | AIモデルの学習利用 | 人間のレビュアー確認 | 設定管理とデータ保持の扱い |
|---|---|---|---|
| 個人 Google アカウント (無料版 / AI Pro・Ultra 等の個人有料プラン共通) |
設定次第 (新トレーニング設定で個別オン・オフ可) |
あり (履歴オフ時も安全保護・フィードバック処理で対象) |
本記事の 2 分割設定が適用。個人有料プランでも自動オフにはならず、履歴オフ時は約 2 か月保持 |
| 法人・教育向け Google Workspace (Business / Enterprise / Education) |
使われない (組織外のモデル学習に不使用) |
なし (組織外の人間による目視確認なし) |
法人データ保護規約(CDPA)が適用。保持期間は組織管理者が制御し、個人用の学習スイッチは非表示 |
| 開発者向け Gemini API / AI Studio (無料枠:Unpaid Services ※EEA・英国・スイス除く) |
使われる (品質改善・機械学習の訓練に使用) |
あり (アカウント切り離し後にレビュー対象) |
テスト用途限定。公式規約上も機密情報や個人情報の送信は行わないよう明記 |
| 開発者向け Gemini API / Vertex AI (有料枠:Paid Services・請求先紐付け済) |
使われない (モデル学習への利用禁止を規約保証) |
原則なし (不正利用フィルタ検知時のポリシー審査のみ) |
商用・業務システム連携向け。不正利用監視用の期間限定ログのみ保持され学習からは完全除外 |
履歴オフでも約2か月保持される新仕様の盲点
従来の72時間保持から約2か月への延長理由
ここからが、今回の設定変更で最も注意しなければならない核心部分です。
「大事な仕事の相談やプライベートな悩みを入れるときは、[履歴] も [生成AIモデルのトレーニング] も両方オフ(上記のパターン③)にしておけば、会話が終わった瞬間にサーバーから消去されて、人間の目にも一切触れないはずだ」と考えていないでしょうか。
実は、今回の通知メールの中段には、従来の仕様を知る技術者ほど驚く 決定的な一文 が明記されています。
[履歴] の設定をオフにした場合でも、今後作成するチャットは 2 か月ほど保存され、ユーザーへの応答、フィードバックの処理、ならびに Google とそのユーザーおよび一般の人々の保護のために使用されます(人間のレビュアーによるレビューも含みます)。 — Google Gemini ヘルプ公式『Gemini アプリのプライバシー ハブ』 および更新通知より引用
従来、Google はアクティビティ(履歴)をオフにした場合の一時的なサーバー保持期間を 「最長 72 時間(3 日間)」 と説明していました。それが今回の 2 分割アップデートにあわせて、「2 か月ほど(約 60 日間)」へと約 20 倍に延長 され、しかもその用途として 「フィードバックの処理」や「人間のレビュアーによるレビューも含みます」 とハッキリ書き込まれたのです。
ええっ!?ちょっと待ってよ!今まで「オフなら最大 72 時間で消える」って聞いていたのに、これからは履歴をオフにしても 2 か月間もサーバーに残って、しかも人間の担当者に見られる可能性があるっていうの!?
そうなんです!もちろん「生成 AI モデルのトレーニング(再学習)」がオフであれば次世代モデルの重みパラメータに学習されることはありませんが、「サーバーから即座に消える」「人間の目に絶対触れない」というのは大きな誤解なんですよ。
なぜ Google は、履歴オフ時の保持期間を 72 時間から約 2 か月へ引き上げたのでしょうか。そこには AI サービスの運用における 3 つの現実的な理由があります。
-
長文コンテキストと継続セッションの維持 :数万〜百万トークンに及ぶ長い対話の文脈を維持しながら正確に応答を返すためです(リアルタイム推論時のメモリ分離の仕組みは AIチャットの会話漏洩は起きる?Gemini・ChatGPTの分離仕組み(TSS)と学習オフ設定 で詳解しています)。
-
高評価・低評価(👍👎)などのフィードバック処理 :利用者が回答の下にある評価ボタンを押したり問題報告を送ったりした際、開発チームや人間のレビュアーが前後の会話ログを遡って原因を調査するためです(評価ボタンが招くデータ送信の罠は AI回答の評価ボタン(👍👎)は押すな!VS Codeでコード送信を招く罠と2つのコピーボタン使い分け術 を参照してください)。
-
悪用検知と安全性の監査(Trust & Safety) :サイバー攻撃コードの生成や詐欺・違法行為への悪用など、複数日にまたがる巧妙な規約違反を検知し、必要に応じて人間の審査官が確認するためです。
人間レビューと米連邦地裁判決が示す法的境界
つまり、新しい設定で [履歴] と [生成AIモデルのトレーニング] を両方ともオフにしていても、「約 2 か月間は Google のサーバー上にログが存在し、安全性確認やフィードバック処理の過程で人間のレビュアーが目を通す可能性があり、かつ法的な開示要請があれば提出対象になり得る」 というのが厳然たる事実です。なお、公式プライバシー ハブ では 人間のレビュアーが確認・注釈付けを行った会話データは、Google アカウントとの関連付けを解除した状態で、利用者が履歴を削除した後も最長 3 年間保存される 仕様であることも明記されています。
多くの利用者が抱いているイメージと、実際の規約・法制度上の現実を比較図で整理してみましょう。
- 保存期間の誤解 :ブラウザを閉じればサーバーからも即座(または72時間以内)に完全消去されると思い込む
- 閲覧者の誤解 :機械が処理するだけで、人間のレビュアーが目を通すことは一切ないと信じ込む
- 法的保護の誤解 :医師や弁護士への相談と同じように、打ち明けた秘密が法的に守られると錯覚する
- 約2か月のサーバー保持 :応答継続・フィードバック処理・安全保護のため、履歴オフでも2か月ほど保存される
- 人間レビューの明記 :安全性監査や評価ボタン送信時には、人間のレビュアーによる確認が含まれると公式明記
- 秘匿特権の不成立 :2026年米連邦地裁判決(Heppner事件)により、民間AIへの相談に弁護士秘匿特権は認められない
特に軽視できないのが、上の右カード最後に挙げた 法的な証拠開示リスク です。2026 年 2 月 17 日に米ニューヨーク南部連邦地裁が下した注目判決(United States v. Heppner 事件:Harvard Law Review Blog 2026年3月の判例解説)では、連邦捜査の対象となった企業幹部が一般向け AI チャット(Claude)に弁護士から得た情報や自らの防衛方針を入力して作成した 31 件の文書が争点となりました。
この裁判において連邦地裁(Jed S. Rakoff 判事)は、「一般向け AI は資格を持つ弁護士ではなく、学習利用や第三者提供を含む利用規約のもとでは秘匿の合理的期待も成立せず、弁護人の指示下で作成されたものでもないため、弁護士・依頼人間の秘匿特権(Attorney-Client Privilege)も訴訟準備書面の保護(Work-Product Doctrine)も一切適用されない」 と判断し、押収端末内の AI 生成文書に対する検察側の閲覧・証拠利用(開示請求)を認めました。
履歴オフでもサーバーに約 2 か月間チャットが保持される以上、「オフにしたから安心だ」と過信して、係争中のトラブルや未公開の契約書原文、実名入りの顧客名簿や税務の固有数値をそのままクラウド AI に打ち込むのは絶対に避けなければなりません。
皆が学習オフへ走るほど日本語AIが劣化する理由
履歴オン×学習オフのタダ乗りが招くモデル崩壊
さて、ここまで読むと「やっぱり怖いから、自分は [履歴] だけオンにして、[生成AIモデルのトレーニング] はずっとオフにしておこう」と思われたかもしれません。実際、今回の 2 分割によって多くの利用者がこの 「履歴オン×学習オフ」 へ流れる構造になると推論されます。
しかし、ここにもう 1 つの、日本の AI 利用者にとって自らの首を絞めることになる 巨大な逆説(パラドックス) があります。
もし、現場で真剣に仕事に向き合っている技術者や執筆者、思慮深い日本語ユーザーたちが全員「学習オフ」に閉じこもり、AI から美味しい果実だけをタダ乗りで受け取ろうとしたら、1 年後・2 年後の Gemini はどうなるでしょうか。
オックスフォード大学やケンブリッジ大学などの研究チームが科学誌『Nature』(2024 年)で発表した論文(Ilia Shumailov et al., “AI models collapse when trained on recursively generated data” / arXiv:2305.17493)が実証した通り、生身の人間による深い試行錯誤や多様な実例データが供給されなくなった AI モデルは、ネット上に溢れる AI 生成の量産記事や当たり障りのないまとめサイトばかりを繰り返し食べて自己中毒を起こし、知能の裾野がどんどん狭まっていく 「モデル崩壊(Model Collapse)」 に陥ります。
うむむ…たしかに今の公開 Web なんて、誰からも怒られないように角を丸めた建前の記事か、AI で量産した似たようなまとめ記事ばっかりじゃもんな。そんなものばかり学習させられたら、AI がどんどん退屈な事なかれ主義になってしまうわい!
まさにそこが最大の障壁(ボトルネック)なんです!特に英語と違って「言葉の裏にある文脈や相手との距離感」で意味を伝える日本語では、人間が AI に粘り強くダメ出しして磨いた対話データが減ると、一気に「空気の読めない AI」へ退化してしまうんですよ。
具体的に、皆が学習オフへ逃げ込んだときに AI から失われていく「生きた日本語の栄養素」は以下の 3 つです。
-
AI定型句(「〜と言えるでしょう」等)への厳しいダメ出しの軌跡 :人間が「その表現は AI 臭くて退屈だから、もっと具体的な一次データと温度感のある日本語に直して」と修正を迫るプロセスそのものが、次世代モデルの文章力を鍛える最大の教師データになります。学習オフが増えるほど、誰も文句を言わない無機質なテンプレ回答が標準になってしまいます。
-
高コンテキストな日本語の「行間」と「緩衝表現」 :「相手のメンツを潰さずに条件変更を飲んでもらう」「建前と本音を切り分けて本質的な代替案を出す」といった日本語特有の繊細な距離感は、公開 Web のマニュアル記事には載っておらず、実際の壁打ち対話の中にしか存在しません。
-
複雑な実務課題を解きほぐす「思考の順序(推論チェーン)」 :完成した綺麗事の結論だけでなく、「最初にどこでつまずき、どの前提を疑い、どうやって矛盾のない解決策へ辿り着いたか」という人間の思考プロセスが学習から消えると、AI の問題解決力そのものが頭打ちになります。
学習オンでも丸暗記されない選別と二層分離の解
もちろん、「日本語 AI を育てたい気持ちはあるけれど、学習オンにしたら自分の会話が 100% そのまま丸暗記されて、他人のチャット画面に自分の秘密が出てしまうのではないか?」という不安を持つのは当然です。
しかし、当ラボの別記事(AIの学習オンは100%使われる?皆が制限して日本語の行間が死ぬ理由と『口の堅い参謀』育成術)で一次論文とともに検証した通り、学習設定を「オン」にしたからといって、あなたの毎日の会話が 100% 無条件にモデルの知識として焼き込まれるわけではありません。
入力されたデータが次世代モデルの再訓練に届くまでには、①設定ゲート、②膨大なトラフィックからの一部サンプリング抽出(※具体的な抽出比率は Google 非公開のため 不明 ですが、全量ではなくごく一部のみ)、③品質選別と個人識別情報(PII)の自動匿名化フィルタという 3 段階の厳しい関門 があります。
そこで抽出されるのは「誰が何を言ったか」という個人のゴシップではなく、「どういう問いに対して、どの論理展開と日本語表現を返したときに人間の納得度が高まったか」という統計的な知恵の骨格です(※将来的にハードウェア暗号隔離領域[光 TEE]と法定守秘義務を統合し、秘密を物理的に 100% 遮断しつつ集合知の結晶だけを還元する国家レベルの設計論については AIのモデル崩壊(学習データ枯渇)と機密保護の解決策|記憶分離と3段階集合知蒸留 で詳しく解説しています)。
だからこそ、今回の設定 2 分割に対する最も賢明な回答は「思考停止で学習オフにする」ことではありません。①外に出してはいけない固有の機密(実名・口座・税務・契約・訴訟防衛)は最初からクラウドに入れず手元のローカル金庫へ完全隔離し、②固有名詞を一般化・匿名化したうえでの本気の思考壁打ちや日本語の推敲は「あえて学習オン」にして次世代の Gemini を自分たちの手で賢く育てる という二層分離こそが、他の誰でもない自分自身の未来を助ける最強の戦略なのです。あえて学習オンで日本語AIを育てる3つの還元経路
アプリ設定・開発IDE・公開Webの3ルート比較
「機密は手元に隔離し、普遍的な思考ロジックと日本語の温度感は AI へ還元して育てる」と決めたとき、ぜひ知っておいていただきたい重要な技術的ポイントがあります。
それは、私たちが AI を使いこなすうえで、「自分の知恵や思考スタイルを AI へ届ける(または管理する)経路は、今回の Gemini アプリ設定を含めて 3 つの異なるレイヤーに分かれている」 という事実です。特にパソコンで本格的な執筆やプログラミングを行う方は、Web 版 Gemini アプリの設定と、開発環境(IDE)側の設定が別枠であることに注意が必要です。
- 管理場所 :Gemini アプリ内の
[設定とヘルプ] > [履歴]([テキストやアップロードを含むチャット コンテンツ]の学習設定) - 還元の仕組み :固有名詞を伏せた日常の思考整理や文章推敲を「学習オン」で行うことで、サンプリングと匿名化フィルタを通過した良質な日本語の対話パターンが次世代 Gemini の基礎体力として還元されます。
- 管理場所 :アプリ設定とは別枠(例:Google Antigravity IDE なら
Antigravity Settings内のEnable Telemetry等や契約プラン規約) - 運用の要諦 :IDE 上では手元のローカル SQLite 金庫や統合ルールファイル(
GEMINI.md)を直接読み書きさせるため、未公開ソースコードや個人資産台帳を扱うプロジェクトでは IDE 側のテレメトリ境界とサンドボックス制御を正確に把握して運用します。
- 管理場所 :自分自身が運営する公開 Web メディア(当ラボなら現在公開 885記事、運用ルール 1,405行 規模)
- 還元の仕組み :チャット欄の学習オンはどれが採用されるか非公開(不明)ですが、壁打ちで磨き上げた一次実測データと論理構造を公開 Web 記事として発信すれば、検索クローラー経由で世界中の次世代 AI モデルへ 100% 確実に知識の結晶を届けることができます。
これら 3 つの経路の違いを、設定場所・保持期間・おすすめの用途ごとに比較表でまとめました。
| 比較項目 | 経路①:Geminiアプリ (Web・スマホ版) |
経路②:AI統合開発環境 (Google Antigravity IDE 等) |
経路③:公開Webメディア (自分の検証ブログ・技術記事) |
|---|---|---|---|
| 設定の切り替え場所 | [設定とヘルプ] > [履歴] 内の 「履歴」と「生成AIモデルのトレーニング」(2分割) |
アプリとは独立した IDE 側の設定(例:Antigravity Settings > Enable Telemetry 等)および API / プラン規約 |
自分のサーバー・Git リポジトリ(公開前に Pure Rust 等の機械検問で個人情報混入をゼロにする) |
| オフ時のサーバー保持 | 履歴オフでも 約 2 か月保持(応答・フィードバック処理・人間レビュー含む) | 利用プラン(個人無料 / Pro・Ultra / 法人 Workspace・API)のデータ保持ポリシーに準拠 | 公開した記事のみが全世界の Web とクローラーへ恒久公開される(手元の下書きやローカル DB は非公開) |
| AIモデルへの届き方 | 学習オン時、一部サンプリング+匿名化 を経て間接的に反映(抽出率は非公開のため 不明) | テレメトリ有効時の利用統計・改善データ(または手元の GEMINI.md による即時コンテキスト注入) |
クローラーと検索インデックスを通じて、次世代モデルの事前学習・RAG(検索拡張生成)へ直接かつ確実に到達 |
| 最適な使い分け | 固有名詞を一般化した思考の壁打ち、言い回しの推敲、アイデア出しを 「あえて学習オン」 で回す | 手元のローカル SQLite 金庫やルールファイルを接続し、専属参謀として高度な自動化・検証を行う | 壁打ちで得た一次データと普遍的な解決策を、徹底的に匿名化・構造化して社会と次世代 AI へ還元する |
なるほど!スマホやブラウザの Gemini アプリの設定だけでなく、パソコンの開発ツール(Antigravity IDE など)には別枠のテレメトリ設定があるし、一番確実に AI を賢くしたいなら、壁打ちで磨いた知恵をちゃんとした公開ブログ記事にして世に出すのが王道なのね!
その通りです!チャット欄での学習オンは「日々の素振りや対話の空気感を届ける基礎栄養」、そして公開 Web 記事での発信は「体系化された教科書を AI に届ける直球ルート」と考えるとイメージしやすいですよ。
手元のSQLite金庫とクラウド還元の仕分け基準
では、日々の生活や仕事の中で「どのデータを手元のローカル環境に隔離し、どのデータを学習オンの Gemini に入れて壁打ちすべきか」、迷わず 3 秒で判断できる実践的な仕分け基準を整理しておきましょう。
-
【レベルA:手元のローカルSQLite金庫へ完全隔離(クラウド入力・学習とも厳禁)】 :自分や家族の実名・住所・生年月日・マイナンバー、銀行口座や証券番号、確定申告・不動産売却・医療介護還付などの 1 円単位の税務原票、取引先との未公開契約書・NDA 対象資料、および現在進行形の法的トラブル・訴訟防衛戦略(Heppner 判決の教訓)。これらは履歴オフでも約 2 か月保持されるクラウド側へそのまま貼らず、手元の Mac 内の隔離ディレクトリ(ローカル SQLite+外付け SSD)で管理します。
-
【レベルB:固有名詞を一般化・匿名化して『あえて学習オン』で徹底壁打ち】 :具体的な人名や自治体名・店舗名を「地方都市の A 市」「取引先の B 社(製造業・従業員 50 名規模)」「70 代の親の介護手続き」のように一般化したうえでの制度設計の相談、文章の構成案づくり、論理の矛盾チェック、日本語の緩衝表現の推敲。これらは個人を特定するリスクをゼロにしつつ、日本語 AI の思考力と行間理解を劇的に鍛える最高の学習素材になります。
-
【レベルC:一次検証データと普遍的ノウハウへ昇華して『公開Web』へ還流】 :実際のガジェット実機測定値、法令や公的統計(e-Gov・国会会議録・国立国会図書館データ等)の裏取り結果、AI 運用の自動化設計など、誰でも再現・検証できる普遍的な知見。過去の対話ログ(Google Takeout 等)から個人情報を 100% 脱色して公開記事へ仕上げることで、自分自身の備忘録になると同時に、次世代 AI の最も信頼できる参照元(RAG の一次出典)になります。
なお、クラウド側の [履歴] 設定(3 か月・18 か月・36 か月)に頼り切っていると、将来アカウントのトラブルや仕様変更があった際に過去の貴重な壁打ち資産を失うリスクがあります。定期的に Google Takeout や履歴エクスポート機能で ZIP 原本を取り出し、手元の Mac の SQLite データベースへ無劣化で取り込んでおく手順は ChatGPT・ClaudeからGeminiへ履歴移行する方法|ZIPインポート手順とSQLite無劣化保管術 で詳しく解説していますので、あわせて実践してみてください。
手元のローカル金庫と学習オンのクラウド壁打ち、そして公開 Web への還流を組み合わせた理想的な好循環フローは以下の通りです。
実名・税務・契約原票や過去の全チャット履歴原本(Takeout ZIP)は、クラウドの保持期間に頼らず手元のMacと外付けSSDのローカルSQLiteへ無劣化保管します。
固有名詞を伏せた普遍的な課題や日本語表現の推敲は、あえて学習オンのGeminiと本気でぶつけ合い、AI臭さを排した深い論理と行間表現を引き出します。
壁打ちで得られた思考の型を手元のルールファイルへ追記して専属参謀を強化し、さらに構造化した検証記事として公開Webへ発信して次世代AIへ確実に届けます。
まとめ:機密は手元へ隔離し知恵はAIへ還元しよう
自分専用の仕分けルールを作るコピペ用プロンプト
今回の Google Gemini のプライバシー設定 2 分割([履歴] と [生成AIモデルのトレーニング] への分離、および履歴オフ時の約 2 か月保持)は、私たち利用者に 「ただ思考停止でオフにして隠れるか、それとも機密と知恵を賢く切り分けて AI を自分たちの手で育てるか」 という選択を突きつけています。
最後に、あなた自身の仕事や生活スタイルにあわせて「何をローカルへ隔離し、何をどう匿名化して学習オンで壁打ちするか」の専用マイルールを AI と一緒に作れるコピペ用プロンプトを用意しました。
ご自身の AI チャットや開発環境(Google Antigravity IDE 等)で運用ルールを整理する際は、『Gemini 4 Carbon』または『Gemini 4 Argon』などの最上位推論モデル を選択し、以下の指示文をそのままコピー&ペーストして送信してみてください。
- コピペ用スタート指示文 :
この記事( https://lab.chihouzakki.com/blog/review/gemini-privacy-settings-split-2months-opt-in-training/ )で解説されている「Geminiプライバシー設定2分割(履歴オフでも約2か月保持・人間レビュー含む)の仕様」と「ローカル完全隔離×あえて学習オンで日本語AIを育てる二層戦略」を前提にして、私専用の『データ仕分け&匿名化壁打ちルール(GEMINI.md / カスタム指示用)』を設計してください。いきなりルール全文を出力するのではなく、まず私の普段のAI用途・扱っているデータの種類・開発環境(WebアプリかIDEか)を把握するための質問を3つだけ投げかけ、私の回答を踏まえて計画に合意してから最終ルールを作成してください。
履歴と機密を手元で守り抜く母艦Macと外付けSSD
そして、この「機密と全履歴原本は手元のローカル金庫(SQLite+Markdown 正本)に置き、思考の壁打ちだけをクラウドと連携させる」という二層運用をストレスなく回すうえで、一番の土台になるのが 手元の母艦パソコンと高速・高耐久な外付け SSD です。
クラウド側の [履歴] 設定が 18 か月や 36 か月であっても、あるいは履歴オフで 2 か月後に消える設定であっても、手元の Mac に数千件の過去の対話データベース(SQLite)と非公開の個人資産・税務台帳が 1 秒未満で検索できる状態で揃っていれば、クラウド側の仕様変更に一切振り回されない「自分だけの一生モノの参謀基地」が完成します。
たとえば、大容量ユニファイドメモリを備えた静音デスクトップ母艦(Mac mini の Apple シリコン Pro 系チップ・64GB メモリ構成クラス:約 32 万〜36 万円前後)と、Thunderbolt 接続対応の堅牢な外付け SSD(SanDisk PRO-G40 SSD 2TB〜4TB クラス:公式直販 APFS 版や実勢価格で約 6 万〜10 万円台 ※一般流通 exFAT 版 4TB は約 16 万円前後、時期により変動)を組み合わせた場合、合計約 40 万〜45 万円前後と仮定した 推論(日割り試算) でも、5 年間(1,825 日)毎日自分の知恵の金庫として使い倒せば、1 日あたりのコストは約 219〜247 円前後(カフェのコーヒー 1 杯分ほど) に収まります。大切な個人資産のデータや何年分もの思考の軌跡をクラウド任せにせず、自分の手元で物理的に守り抜く投資としてこれほど確実なものはありません。

履歴オフでも 2 か月間は見られる可能性があるなら、カリカリの隠し場所リストだけは手元の SSD 金庫にしまっておいて、美味しいおねだりの日本語表現だけを学習オンで鍛えるでちぃ🐾
▲ 秘密を守るローカル金庫と、生きた日本語を育てる学習還元の二刀流が最強の戦略です